HOUHUIYANG.COM

技术札记

AI、工程系统与组织进化

侯惠阳41

目录

  1. 01从 HTML 时间轴到可验证成片:我如何使用 HyperFrames 制作 HHY 视频
  2. 02从 v1.7.0 到 v1.7.1:让 HHY 的每一次提交都有边界
  3. 03研发 HHY CMS:把企业官网的交付经验写成可复用的产品
  4. 04从 v1.5 到 v1.7:我如何为 HHY 建立可验证的优化链路
  5. 05HHY Database 1.0:我如何把数据库访问做成可长期运行的能力
  6. 06把 GPT 拆到标量:我如何理解 MicroGPT 的完整训练算法
  7. 07从脚本到常驻服务:我如何实现 HHY Web Runtime
  8. 08旅行不是打卡:我如何在路上不断修正对世界的想象
  9. 09不是模型战争:我如何理解跨太平洋 AI 棋局
  10. 10从 AST 到 Bytecode:我如何让 HHY 的默认执行引擎快 2.7 倍
  11. 11纠缠、黑洞与真气:我对宇宙和人的三个猜想
  12. 12不要只经营一份工作:关于职业窗口、第二曲线与持续进化
  13. 13实战多 API 数据采集器:异构来源如何汇成一张增量表
  14. 14实战 Asset Governance:先审计,再让副作用发生
  15. 15实战 DataFlow ETL:用一条 HHY Flow 串起 CSV、JSON 与 HTTP
  16. 16实战 FlowGuard:我用 HHY 写了一个可进 CI 的项目质量门禁
  17. 17实战 HHY Collector Framework:我没有从复刻 Scrapy 开始
  18. 18不换 Bytecode,我如何优化 HHY 的 AST 解释器
  19. 19实战香港电影公司:用 HHY 做一次可复现的维基百科研究
  20. 20从 Flow 哲学到 C Runtime:我如何从零实现 HHY Language
  21. 21为什么我在大模型前加了一层 OCR:图片理解不是把文件直接丢给模型
  22. 22AI 产研组织的下一阶段:从职能分工走向项目小队
  23. 23软件正在变成“日抛品”:AI 如何改写 SaaS 与企业内部系统
  24. 24一份内容,三个阅读终端:我如何把个人技术札记做成网站、小程序与 macOS 应用
  25. 25垂类大模型不是一个模型:我如何构建本地 AI 求职系统 Atlas
  26. 26CoreX 开发实录:用 Swift 构建一款原生 macOS 实时系统监控工具
  27. 27FaceFizz:把趣味相机装进浏览器,源码公开后的产品与工程复盘
  28. 28我在 Homebrew Redis 8.10.0 中发现了一个打包问题
  29. 29从 0 到 1 构建招聘领域大模型:以 BOSS 直聘类场景为例
  30. 30大模型的护城河,不只是代码,而是数据
  31. 31中小企业 Agent 平台架构:从入口、编排到工具与治理的完整设计
  32. 32用务实 DDD 构建 Docket:从业务边界到可演进的模块化单体
  33. 33心绪云脑AI:从零构建可靠的多模态情绪理解系统
  34. 34现代并发编程:从执行模型到生产级可靠性
  35. 35大模型真的理解世界吗?从下一个 Token 到智能的边界
  36. 36LangChain 与 LlamaIndex:如何选择,以及如何构建生产级 RAG
  37. 37如何构建 AI 原生团队:不是给旧流程加 AI,而是重写工作系统
  38. 38从 Query 理解到知识驱动推荐:一套可演进的财税搜索架构
  39. 39我的 AI 编程工作台:让多个模型协作,而不是寻找唯一最强工具
  40. 40构建生产级智能风控系统:实时流、离线湖仓与规则模型一体化
  41. 41从随机权重到本地推理:我如何从零训练一个 Transformer

01 / 41

从 HTML 时间轴到可验证成片:我如何使用 HyperFrames 制作 HHY 视频

复盘我用 HyperFrames 制作 HHY 发布片、入门教学、课程与竖屏短片的过程:如何先定义信息边界,再组织场景、声音、真实素材和自动检查,并把视频生产变成可重复的工程工作流。
2026/09/15 · 15 分钟阅读

过去一段时间,我用 HyperFrames 连续做了几种完全不同的视频:HHY Web Runtime 发布片、HHY v1.7.0 产品发布片、两分钟左右的入门教学、可批量生产的课程,以及一条 9:16 的移动端创意短片。

它们的目的不同。发布片要在几十秒里建立记忆点,教学视频必须让代码和旁白对应,课程需要重复生产,竖屏短片则更依赖单一视觉概念。但做完这些项目以后,我越来越确定:视频生产真正难的部分,不是让一个元素动起来,而是让内容、时间、素材、声音和验证形成同一个系统。

HyperFrames 对我有价值,是因为它把视频写成 HTML。场景是 DOM,动画有可定位的时间,图片、代码、音频和子合成都是项目文件,最终再由确定的渲染流程输出 MP4。这种方式很像做软件:画面依然需要审美判断,但结构可以阅读,变化可以复现,错误可以检查。
HHY v1.7.0 发布片中的品牌定格画面

我先定义视频要证明什么

最容易走偏的做法,是一开始就选择转场、粒子或 3D 效果。画面可能很忙,但观众看完不知道产品是什么。

我现在会先写一个很短的制作约束,至少回答五个问题:

问题我需要得到的答案
核心信息观众看完只记住一句什么?
目标受众是开发者、学习者,还是移动端泛用户?
证据哪些代码、界面、结果可以真实展示?
边界哪些能力尚未交付,不能写进画面?
载体横屏、竖屏、网站、社交平台还是课程?

例如 HHY v1.7.0 发布片的主线不是“我们做了很多功能”,而是:HHY 已经从 Flow-first 语言走向可以构建真实应用的系统。 41 秒被拆成 Logo、语言、编译器、ETL、CMS 和邀请六段,每一段只承担一个信息任务。

这也帮助我控制技术表述。发布片可以写“Verified optimizing compiler and Runtime”,但不能因为某个局部基准更快,就把它变成对所有程序的性能承诺。视频文案越短,越容易把条件删掉,因此内容边界必须在动画之前确定。

Storyboard 不是画面清单,而是时间预算

我以前理解 storyboard,容易把它当成“第一幕出现标题,第二幕出现代码”。真正进入制作以后,我发现它更像一份时间预算。

一段 6 秒的场景,不能同时容纳标题进入、三行代码逐字出现、架构图展开、结果计数和离场转场。即使技术上都能实现,观看时也没有足够时间完成阅读。

我会把每个场景继续拆成小阶段:

0.0–1.4s  建立标题
1.4–3.2s  展示输入与方向
3.2–4.8s  给出核心模型或结果
4.8–6.0s  保持画面,让观众读完

最后这个“保持”很重要。动画系统很容易让人产生一种错觉:画面不动就是浪费。但如果所有元素一直运动,观众真正看到的只有变化,没有结论。

在发布片里,我通常让一个场景有一个主动作,其余动画服务于它。|> 从远处接近并翻转成 HHY Logo,是开场的主动作;后面的版本文字和网址只需要清晰到位。把每个细节都做成主角,会让品牌记忆点消失。

HTML 让我把画面当成可维护的结构

HyperFrames 的合成不是录制浏览器操作,而是把可渲染页面本身作为视频源。一个元素何时出现、持续多久、属于哪条轨道,都可以在 DOM 中明确表达;动画时间轴可以暂停和 seek,因此同一时间点应当得到同一画面。

这给我带来几个工程上的直接收益:

  • 文案不是压进一张图片里,后续可以修改和本地化;
  • 代码、终端、数据卡片可以保持真实文本和稳定布局;
  • 场景可以拆成子合成,避免一份 HTML 无限增长;
  • 横屏和竖屏可以复用设计语言,但分别控制构图;
  • 固定时间截图可以成为评审证据,而不是依赖“从头播放时感觉没问题”。

但 HTML 也不会自动带来好设计。网页允许用户滚动、等待和点击,视频却按照时间强制推进。一个在网页上合理的卡片布局,放到 1920×1080 的视频里可能显得细碎;一个漂亮的长页面,缩到画面中可能完全看不清。

因此我的处理原则是:视频里尽量使用大字号、短句、明确的视觉层级和有限的同时信息量。真实产品截图需要足够大;代码只展示当下要解释的部分;背景和装饰不能与正文争夺对比度。
HHY Web Runtime 发布片中的架构表达

真实素材决定视频有没有可信度

我会优先使用项目本身的 Logo、真实代码、真实命令和真实界面。模型或插画可以建立氛围,但不能替代产品证据。

HHY v1.7.0 发布片里的 CMS 画面来自实际网站和管理界面;ETL 场景中的客户数、部门数和数据结果来自已经验证的 fixture;入门教学使用可以运行的 .hhy 文件和真实命令,而不是为了画面临时写一段不存在的语法。

这里有一个很实际的经验:先验证素材,再设计围绕它的动画。 如果最后才发现截图比例不适合、命令运行失败、数据与发布版本不一致,前面的构图和节奏都会返工。

素材进入项目后,我也尽量冻结成当地文件。渲染不依赖网络请求,不在运行时随机选择图片,也不让远程资源的变化影响以后重新输出。这既是稳定性问题,也是可追溯性问题。

教学视频的时间轴必须跟着理解过程走

产品发布片可以依靠节奏建立情绪,教学视频不能只追求快。观众需要看见概念、代码、执行和结果之间的关系。

我制作 HHY 入门视频时,把内容拆成欢迎、安装、绑定、函数、Flow 和运行六个子合成。每一段都有独立旁白和画面,组合后形成一条完整时间轴。
HHY 入门教学中的函数与管道语法画面

这类视频给我的几个经验是:

  1. 先让观众知道本段要得到什么结果,再解释语法。
  2. 代码出现的速度要服从旁白,而不是服从动画模板。
  3. 命令、源码和输出必须在画面上有不同层级。
  4. 字幕不能挡住正在讲解的代码。
  5. 对长句,应根据实际语音时长切分字幕,而不是平均分配时间。

课程生产进一步放大了这个问题。一条视频可以手工微调,16 集课程如果每一集都从空白开始,风格和质量很快会漂移。因此我把课程拆成脚本、可运行示例、旁白、句子时间、字幕、合成、渲染、媒体验证和网站同步几个阶段。

模板的价值不是让每集长得完全一样,而是固定不应该反复争论的部分:分辨率、品牌颜色、标题区、代码区、字幕安全区、字体、声音格式和输出检查。每一集真正变化的是教学目标、示例和节奏。

声音不是最后再贴上去的一条轨道

没有旁白的发布片,我会先确定几个视觉节拍,再让音乐和关键音效支撑切换。带旁白的教学视频则相反:实际语音时长决定场景长度,画面需要围绕句子进入和停留。

如果先按想象做完 60 秒动画,最后得到 73 秒旁白,通常不是把语速加快就能解决。字幕、代码揭示、段落停留和场景连接都需要重新分配。

我现在更愿意把声音当成时间数据:先生成或录制,测量每句话的长度,再建立场景和字幕。渲染时,视频素材本身静音,声音由单独轨道管理,便于调整、替换和验证。

音效也要克制。键盘确认、程序完成或场景切换可以有一个明确声音,但每个文字进入都配音效,会快速消耗注意力。声音应该帮助观众理解事件,而不是证明制作工具拥有多少效果。

同一套语言,不等于同一个画面比例

横屏发布片强调左右关系和宽阔留白;竖屏短片更接近单列叙事,主体必须始终处在手机可视区域。把 16:9 画面简单裁成 9:16,通常会同时失去文字和主体。

在 HHY 的竖屏创意短片里,我使用了一个连续场景:人物生活在 macOS 桌面中,Terminal 从 Dock 上方出现,真实命令逐字输入,运行成功后 HHY Logo 从终端结果中进入画面。22 秒没有切镜,所有变化都围绕同一空间关系发生。

这个项目让我意识到,创意并不一定等于更多镜头。一个清楚的空间规则,加上分阶段揭示,往往比连续切换背景更容易形成完整体验。竖屏尤其需要控制顶部菜单、终端、人物、Logo 和收尾文案之间的安全区域。

检查固定时间点,比只看一遍成片更可靠

视频最容易遗漏的问题,经常只出现几帧:文字刚好重叠、元素还没完全退出、转场中间出现空白、图片比例短暂变形,或者某一行代码在动画过程中被裁切。

我会保留三层验证:

层级检查内容
静态规则时间属性、资源路径、确定性和合成结构
运行与布局页面错误、元素越界、文字遮挡、对比度
成片证据指定时间截图、contact sheet、音视频元数据和最终 MP4

完整播放仍然必要,但它更适合判断节奏和情绪。定位布局问题时,固定时间采样更有效。发布片会在场景主体稳定时取 poster,也会专门检查切换前后;教学视频还要检查字幕、代码揭示和声音是否在相同时间点对齐。

自动检查不能替代审美判断。一次 check 通过,只说明既定规则没有发现错误,不说明故事足够清楚、字体一定合适或节奏已经最好。我的做法是让工具负责发现可计算的问题,人负责判断信息是否值得出现、观众是否来得及理解。

我最终保留下来的工作流

经过几类项目以后,我现在使用的顺序大致是:

一句核心信息
→ 内容与证据边界
→ Storyboard 和时间预算
→ 准备并验证真实素材
→ HTML 场景与可 seek 时间轴
→ 声音、字幕和画面对齐
→ 固定时间截图与自动检查
→ 完整播放审阅
→ 渲染并验证最终文件

其中最值得保留的不是某个转场参数,而是三个原则。

第一,先决定观众应该理解什么,再决定画面怎么动。

第二,把真实内容放进视频,而不是用视觉包装替代证据。

第三,让视频能够被重新生成、检查和修改。 当版本号、代码、配图或语言变化时,我希望修改的是结构化源文件,而不是重新打开一个只能凭记忆调整的工程。

HyperFrames 没有消除视频创作中的判断。它把判断放进一个更适合工程师的媒介:HTML、时间轴、文件、规则和可重复渲染。对我来说,这不是把视频变成网页,而是把一次性的制作过程变成可以持续演进的内容系统。

好的工程化视频,不是动画最多的那一条,而是信息、证据、节奏和画面在同一条时间线上达成一致。
相关项目

02 / 41

从 v1.7.0 到 v1.7.1:让 HHY 的每一次提交都有边界

从优化编译器回到资源归属、失败恢复和受控并发,复盘 HHY v1.7.1 的工程取舍、真实性能基线,以及走向共享状态、协程与分布式事务的下一步。
2026/09/14 · 15 分钟阅读

写完 v1.7.0 的优化编译器,我又回到了几个看起来没那么“先进”的问题:一个环境究竟由谁保活,一条 Stream 关闭之后还留着什么,一个任务失败时谁负责把子进程收回来,以及一次更新报错之后,数据到底有没有提交。

这些问题没有新语法那么显眼,却决定了我敢不敢让 HHY 持续运行,敢不敢让它修改真实的业务状态。

上一篇文章记录了从资源生命周期到 HIR/MIR 的优化链路。v1.7.1 接着往下走:把资源归属补牢,把几类提交行为的保证说清楚,再用当前二进制建立一份能够继续比较的性能基线。

对我来说,这次迭代最重要的进展,是让“成功、失败、结果未知”分别有自己的含义。 后面的共享状态、协程和分布式事务,都需要建立在这个基础上。

本文依据 2026 年 9 月 14 日的语言现状报告与发行归档。性能表来自报告当天的采样,写作时没有重新跑基准;未来方向采用同日官网路线图的 1.x、2.x、3.x 分组,均不代表已交付能力或日历承诺。

从 v1.7.0 优化链路,到 v1.7.1 资源与提交边界,再到后续内核演进

v1.7.0 留下的基础,v1.7.1 接住的问题

v1.7.0 已经交付结构化 HIR、六个静态优化 pass、有界整数 MIR、类型反馈 guard/deopt,以及局部整数 List 的标量替换。这条路径让我可以把一部分重复工作前移到编译阶段,再由独立 Verifier 检查。

但交付优化器,并不意味着所有应用已经默认变快。直接 Bytecode 仍是默认路径,AST 保留为独立语义对照;HIR、反馈特化和标量替换继续显式开启。标量替换也保留原有 GC 与配额分配预约,不能把它写成已经消除了堆分配。

到了 v1.7.1,我把注意力放回更接近应用的一层。语言现在有文件、HTTP、进程、Stream、常驻 Web 和数据库扩展。一次函数调用可以借出游标,一条惰性流水线可以把闭包环境保留很久,一次父任务失败也可能留下已经完成的外部写入。

如果 Runtime 不能准确回答这些对象的生存期,继续叠加快路径只会让错误更难解释。

先把资源的归属补牢

这次修复里,Context environment 的 GC roots 很关键。长期宿主调用依赖的环境需要显式保活,不能因为一次垃圾回收变成悬空引用。候选状态、事务与严格作用域也需要参与 roots 管理,并在异常出口清理。

Stream close 的变化同样具体:释放 payload、环境、回调和 jobs 引用,让已经结束的消费不再拖住这些对象。但为了保护检查点,注册链节点仍然保留。我不会把它概括成“关闭后所有资源节点立即删除”,因为那会掩盖真实的生命周期设计。

任务子进程的失败恢复,以及 portable no-replace 的修复,也都在处理同一种责任:正常路径建立了什么,失败路径就必须知道如何收尾。

这里还要分清内存口径。max_memory 限制的是相对 Runtime 启动基线的语言堆,不是整个进程 RSS,也不是所有 Worker 的内存总和。语言配额是可控运行的一部分;要判断常驻服务是否稳定,还需要持续观察 RSS、FD、子进程和临时文件。

七个实验接口,围绕四种明确的责任

v1.7.1 新增的七个受控并发 API 默认关闭,需要显式启用:

HHY_CONCURRENCY_EXPERIMENTS=1 hhy run app.hhy

它们分别解决 Runtime 内状态发布、单文件协作更新、数据库严格事务和有限批次任务监督。

范围接口我希望它承担的责任
单 owner 状态atomic_stateatomic_readatomic_updateatomic_close候选值校验完成后,一次发布完整状态
单文件atomic_file_update遵守同一锁协议的写者,在锁内完成读改写
数据库transaction_strict回调受约束地使用同一个事务,失败后不能继续提交
有界任务task_map隔离子进程、有序结果、失败监督与直接任务回收

这七个接口并没有把 HHY 变成共享内存并发语言。当前并发仍建立在同步 Runtime、隔离进程、有界并行与外部存储事务上,没有新协程调度器,也没有 async/await

我选择先把每种资源的保证做窄、做实。原子性需要回答“对什么原子”,才有讨论价值。

原子状态:把相关字段作为一个候选值发布

例如,我希望两个字段一起变化,而不是让读取者看到中间状态:

let state = atomic_state({left: 100, right: 0})
fn transfer(old) { {left: old.left - 10, right: old.right + 10} }
atomic_update(state, transfer)
print(atomic_read(state))
atomic_close(state)

atomic_update 同步计算并校验候选值,然后一次发布。提交前发生错误、取消或配额失败,旧值仍然保留。

这里的 owner 是所属 Runtime/PID。AtomicState 不能跨 Worker 发送,不能捕获到另一个 Worker 里,也不能 JSON 编码。它不是普通变量自动获得了线程安全,更不是跨进程共享内存已经完成。

候选值也有明确范围:Null、Bool、Int、有限 Float、String,以及递归 List/Map;Function、Stream 和句柄不能混进来。限制这些值,才能约束发布、生命周期和失败行为。

对我来说,这提供了一个足够小、可以验证的提交内核。以后扩展到多个对象、多个 Worker 时,需要新的内存模型和恢复协议,不能直接扩大这组 API 的承诺。

文件、数据库和任务,不能拼成一个自动事务

三个独立原子域及有界任务监督的保证边界

单文件更新最容易产生误解。原子替换解决可见性;多个写者先读再写是否丢更新,还取决于它们是否遵守同一套协作锁协议。

atomic_file_update 要求目标是预先存在的普通文件,所有写者围绕同一路径和稳定的 .hhy-lock 文件协作。传入的 Duration 只限制等待锁的时间,不会中断任意长的回调。活跃写者之间也不能随手删除锁文件,否则锁的身份就变了。

发布与持久化仍是两件事。临时文件写入和同步、替换、父目录同步,各自都有失败位置。HHY_PUBLISHED_DURABILITY_UNKNOWN 表示内容已经发布,但目录持久性未知;此时把错误理解成“完全没写入”,再盲目重试,就可能重复执行业务动作。

数据库也有对应的问题。transaction_strict 约束回调使用同一事务;回调运行错误即使被 catch,仍保持 rollback-only,不能通过吞掉错误恢复提交资格。严格回调也不能任意执行文件、HTTP、任务等外部效果。

但数据库 COMMIT 的应答丢失后,客户端可能只知道 DB_COMMIT_UNKNOWN。数据库已经提交、客户端却没有收到确认,是必须单独处理的状态。业务应该结合唯一请求键查询、对账,再决定下一步;语言没有自动提供 exactly-once。

task_map 则负责有限 List 输入、有界隔离任务和有序 List 结果。后面的任务快速失败,不必一直等第一个慢任务才能被发现;退出时会统一终止和回收直接子任务。不过,子任务已经完成的文件、HTTP 或数据库效果,不会随父任务失败自动撤销。它的结果预算也不是全局磁盘或 RSS 上限。

我希望开发者能够在调用之前知道,哪一部分会被一起提交,哪一部分需要自己恢复。 Runtime 状态、单文件和数据库是三个独立原子域,任务监督负责生命周期;它们不会自动组合成跨资源事务。

这次基线,让我重新看待“默认更快”

9 月 14 日的报告使用当前 1.7.1 二进制,对三个既有基准分别运行 AST 与 Bytecode。每种模式预热两次、正式采样七次,交替执行顺序,清除环境中的 HHY_* 实验开关,并检查每次输出一致。
每个样本都单独启动进程,时间包括启动、解析、编译或验证与执行。这测的是端到端成本,不能直接当成热循环的稳态速度。

HHY 1.7.1 同一二进制的双引擎耗时比:Flow 更快,JSON 接近,闭包更慢

负载AST 中位数Bytecode 中位数BC / AST
core-flow,100,000 项20.922 ms13.499 ms0.645×
json-flow,500 轮转换62.382 ms63.469 ms1.017×
call-closure,100,000 次捕获闭包调用21.985 ms28.518 ms1.297×

Flow 负载里,Bytecode 耗时少约 35.5%;JSON 接近;捕获闭包里,Bytecode 耗时多约 29.7%。三组输出对等,但速度方向并不一致。
我愿意把闭包这一行原样留下。下一轮真正值得做的,是通过 profiler、dispatch 和 lookup 对照,把启动成本与稳态成本分开,找到可以解释的热点。单凭这张表,还不能断定是哪一次查找或哪种派发导致了差异。
这组数据也不是 v1.7.0 与 v1.7.1 的版本对比。它比较的是同一 1.7.1 二进制的两个引擎。开发机没有锁频、绑核或停掉后台服务,也没有多主机重复;它适合做后续调查的基线,不能给出 p99、生产 SLA 或与其他语言的全面排名。

开发期 binding cache 与 source fusion 的配对记录同样呈现混合结果:部分负载略有收益,文件 distinct 等负载退化。那组记录使用的是开发前保存的对照二进制,并非从 tag 洁净重建,也不能拿绝对时间与本次表格相除,拼出一条版本提速曲线。

因此,编译器、cache 和 fusion 候选继续按真实负载收益、兼容与资源预算独立准入。代码存在,不构成默认开启的理由。

有验收证据,也要留下尚未回答的问题

这份报告新执行了 69 个引擎与配置用例,以及 80 次协作文件竞争更新。69 个用例包含预期拒绝,含义是行为符合契约,不是所有输入都应成功。

已有归档还包含双数据库幂等与提交未知恢复、100,000 请求的单机 Web 测试、四平台 CI 和发行包验收。Web 记录为 32 客户端、0 失败、约 2,391 req/s;这是当时单机单负载的观察值,不是最大承载量,更不是数据库业务 QPS。

120 秒、9,360,000 次 owner 提交的短时长稳,也属于旧构建的开发期证据。它不是当前发布二进制的 24 小时长稳,更不是共享内存并发测试。Linux x86_64 的极低内存 unwind 还存在 BDWGC/ASan 环境限制,不能把各平台 sanitizer 的覆盖范围写成完全相同。

发行过程中也出现过性能门槛波动:首次 macOS I/O/JSON 比值为 1.3496,超过 1.10 门槛;同提交本地复核为 1.0032,在不改代码和阈值的情况下重跑失败 jobs 后通过。记录这段过程,比把它压缩成“首轮全部通过”更有助于以后理解测量环境。

接下来,我优先补当前候选构建的 24 小时长稳、提交前后故障矩阵,以及数据库隔离级别、死锁、重复请求和重启恢复的业务不变量。然后再做 Web 并发阶梯、尾延迟和资源曲线。测试数量可以增长,承诺范围仍应跟着证据走。

1.x:让已有能力逐项稳定开放

官网路线图把接下来的工作分成三个大版本系列。我会用这个层级表达方向,而不把内部拆分草案中的每个小版本号写成发布日期。

1.x 的重点是稳定当前七个接口:先固定 owner、effect、错误分类与资源契约,再用当前候选构建完成长稳、故障、平台和 AST/Bytecode 对等验收。

状态、文件、数据库和任务应分别判断。某一项成熟,可以先移除它的实验门槛;没有满足条件的继续保留实验状态,不需要彼此捆绑。

“稳定开放”意味着不再要求 HHY_CONCURRENCY_EXPERIMENTS 才能调用已经准入的 API。开发者仍然需要显式调用原子更新或严格事务,普通变量不会因为升级突然变成事务变量。

性能优化是另一条准入线。HIR、cache 或 fusion 即使正确性通过,也仍需证明端到端收益,可以长期保持关闭。

2.x:共享状态与协程,需要一起设计内核

HHY 后续路线图:1.x 稳定化,2.x 原子共享状态与协程,3.x 分布式事务

2.x 的目标,是域内全局状态原子性、跨 Worker 的共享内存原子状态,以及协程调度器。

这里的“全局”有范围:一个声明的 StateDomain 内,受管共享对象可以参与统一的多对象事务。它不代表任意普通变量、文件、HTTP 和数据库会被自动包成一个事务。

共享内存也不能直接传递当前 GC 堆里的指针。它需要共享 arena、带代际的句柄、版本与读写集、统一提交点,以及 Worker 崩溃后的恢复和回收规则。同机 Worker 共享与跨节点分布式一致性,是不同层次的问题。

协程则要求可挂起和恢复的执行帧,保留局部值、异常处理器、资源作用域与 GC roots,再接入非阻塞 I/O 和结构化取消。已有 Stream 或 SSE 并不等于这些工作已经完成。

我尤其关注共享事务和协程相遇的地方:原子提交过程中能不能挂起,取消到达时由谁清理候选,等待的任务是否会丢失唤醒,旧版本由谁保留。两部分分别通过测试之后,还需要联合验证。

新模式应该先实验,满足正确性、恢复、公平性与资源边界后再稳定。旧程序不能在没有迁移选择的情况下,突然改变共享或调度语义。

3.x:把未知结果带进可恢复的分布式协议

3.x 才进一步走向分布式事务:持久协调器、prepare/commit/rollback 参与者、决策日志、UNKNOWN 查询与恢复,再到高可用、故障注入和运维工具。

我希望支持的是明确具备事务协议能力的参与者。普通 HTTP 服务如果不支持可恢复的准备和提交,就不能因为接入 HHY 而自动获得严格原子回滚;显式补偿有价值,但补偿与原子回滚需要分别说明。

这条路线的验收重点,会是参与者崩溃、网络分区、重复消息、确认丢失,以及协调器重启后如何继续执行已经记录的决定。稳定的 API 也仍然需要显式配置数据库、协调器和支持矩阵。

从 v1.7.0 到 v1.7.1,我对 HHY 的期待没有变:让数据流清楚,让系统行为可解释。只是现在,每增加一种能力,我都会多问一句:它失败以后,使用者还能不能知道发生了什么,并且继续把事情做完。

参考资料与延伸阅读

03 / 41

研发 HHY CMS:把企业官网的交付经验写成可复用的产品

从 CMS 开发者的视角,复盘 HHY CMS 0.1.2 的架构与取舍:HHY Web 与 MySQL、可恢复安装、草稿发布隔离、主题边界,以及面向他人使用的编辑和维护体验。
2026/09/08 · 12 分钟阅读

企业官网看起来总是差不多:介绍企业,展示产品与案例,发布新闻,留下联系方式。但只要真正交付过一个网站,就会发现,页面完成之后,工作还远没有结束。

谁来修改内容?编辑到一半的文案会不会出现在官网?换一张封面需要找开发者吗?安装失败后,接手的人能不能继续?几个月后迁移服务器,究竟要备份哪些东西?

研发 HHY CMS 时,我关心的是这些问题。我希望把建站过程中反复出现的内容管理、发布和交付能力写进一个产品,让其他人能够在自己的环境里安装、管理,并继续维护一套企业官网。

这篇文章以当前 0.1.2 的源码为基础,记录我如何划分系统职责,以及为什么一些看起来很小的约束,值得在第一版就认真实现。

把网站交付给别人,意味着把日常更新的能力、操作的边界和出错后的恢复路径一起交出去。

先确定交付的最小完整产品

第一版的范围,是一套企业官网和与之配套的管理后台:首页、关于、产品、案例、新闻、联系页,以及分类、媒体、站点设置和首页区块管理。

这个范围决定了数据模型。产品、案例、新闻和页面用 kind 区分,共用标题、URL 标识、摘要、正文、分类、封面和 SEO 字段。品牌、联系方式、导航和页脚属于站点设置;首页区块单独管理顺序、可见性与文案。

我没有在这个阶段引入任意内容类型建模、自由拖拽布局、多租户或插件市场。每增加一种自由度,都需要相应的校验、兼容和维护机制。先把常见的企业表达组织好,才能知道哪些差异值得成为产品能力。

这也让“可复用”变得具体:不同企业可以更换自己的品牌、内容与首页组织,而内容保存、发布、鉴权和媒体管理沿用同一套实现。

让 HHY 承担完整的服务端职责

HHY CMS 建立在 HHY Web 和 MySQL 之上。安装器、路由、权限、数据库访问与服务端页面都使用 HHY 实现;浏览器端用 CSS 和 JavaScript 增强编辑体验。部署 CMS 本身不需要 Node.js,也没有前端构建步骤。

当前环境约定是 HHY 1.5.0、官方 database 1.0.0 扩展、MySQL 8.x 或兼容版本,以及 OpenSSL 3 和系统 file 工具。这些依赖写进交付文档,比一句“开箱即用”更有价值。

代码按业务边界拆分:

模块承担的职责
lib/application.hhy注册路由、分发请求、统一错误响应
lib/install.hhy安装验证、迁移记录、初始化与恢复
lib/auth.hhy登录、退出与登录限流
lib/content.hhy内容编辑、保存、发布、下线与预览
lib/manage.hhy站点设置、首页区块、分类与媒体
lib/site.hhy组织公开页面数据与 sitemap
themes/default/theme.hhy默认主题的展示逻辑

这套划分让我能沿着业务动作阅读系统。修改发布规则时看内容模块;调整视觉表达时看主题;安装失败时沿安装状态检查。它也为后来接手代码的人提供了入口。

HHY Web 的组合方式在应用入口中很直接,下面是源码中的静态资源注册片段:

let mut app = hhyweb.minimal()
    |> hhyweb.static_files("/assets",path("public"))
    |> hhyweb.static_files("/media",c.file("uploads"))

这个映射同时表达了部署边界:静态资源和上传图片可以公开,私有配置、安装令牌与临时文件不能因为“方便”而一起暴露。

把安装器当作一段需要恢复的工作流

给自己使用的项目,往往可以靠手动建表和补配置启动。交给别人之后,安装过程本身就是产品的一部分。

HHY CMS 首次启动生成安装令牌,安装向导再收集数据库、站点和管理员信息。数据库必须由部署者预先准备,首次安装会检查是否为空;浏览器里填写的数据库地址,还必须落在部署环境配置的 CMS_DB_ALLOW 范围内。

这样,安装表单负责收集信息,允许连接哪些数据库则由部署者决定。

安装也不能假设所有步骤一次成功。当前实现先保存 install-pending.json,再执行迁移与初始化;cms_migrations 记录已执行的步骤,数据库锁用于避免迁移阶段并发执行。中断后沿用首次提交的安装信息继续,完成后才写正式配置。

这里我刻意区分了“继续同一次安装”和“覆盖一个已有站点”。数据库中的安装标识用于识别归属,已有站点的安装入口会关闭。恢复不应该变成一次隐藏的重装。

这些机制针对的是当前安装流程,并不等于已经具备完整的跨版本升级系统。后续的模式变更、历史版本兼容与升级回退,仍然需要独立设计。

草稿与公开版本必须在数据上分开

内容管理最容易让使用者失去信任的情况,是点击“保存”之后,未完成的改动直接出现在官网。

HHY CMS 把可编辑字段和 public_json 公开快照放在同一条内容记录中。保存草稿只更新编辑态;发布时才替换公开快照。公开页面读取快照,后台预览读取当前编辑内容。

操作编辑内容官网展示
新建并保存草稿保存新内容仍不公开
修改已发布内容并保存草稿保存新修改保持上一次发布版本
发布保存当前内容并更新快照展示新的公开版本
下线保留可编辑内容移除公开版本

下面是 lib/content.hhy 中更新发布快照的实际代码:

if f.intent == "publish" {
    let snapshot = put(item,"revision",c.str(revision+1))
    c.exec(tx,"UPDATE cms_content SET public_json=?,public_category_id=NULLIF(?,0),public_cover_id=NULLIF(?,0),published_at=UTC_TIMESTAMP() WHERE id=?",[encode_json(snapshot),item.category_id,item.cover_id,saved_id])
}

public_category_idpublic_cover_id 也要随发布同步。否则正文虽然保持旧版本,分类筛选或封面引用却可能提前跟随草稿变化,发布边界仍然是不完整的。

这份快照针对的是内容记录。站点设置和首页区块另有保存路径,不能把它理解为整个站点都支持草稿发布;当前也没有完整的历史版本回滚。

单管理员,也需要处理并发编辑

第一版只有单管理员,但同一个人也会打开两个编辑页。旧页面覆盖新修改,并不需要两个不同的账号才会发生。

保存时,内容模块在事务内通过 SELECT ... FOR UPDATE 读取记录,再比较表单中的 revision 与数据库版本。版本不一致时,返回明确的冲突提示,而不是默默覆盖。

if current != null and (to_int(current.revision) != revision or current.kind != item.kind) {
    throw("内容已被其他操作修改,请重新打开编辑页")
}

字段校验、分类与媒体存在性检查、内容写入、发布快照和操作记录都围绕同一个事务组织。失败进入回滚路径,成功才跳转回编辑页。

已发布内容还限制修改 URL 标识。这是在当前能力范围内保护链接稳定性的选择;真正支持修改公开 URL,还需要重定向等后续机制,不能只放开一个输入框。

主题负责表达,发布规则留在应用里

默认主题的作用,是把企业信息呈现成可阅读的官网。公开数据由 site.hhy 组织,再交给展示逻辑;主题不负责管理员鉴权,也不决定什么时候替换公开版本。

这种边界对 CMS 的研发很重要。企业之间最常变化的是视觉和信息组织,如果每次换外观都要重写权限与发布流程,系统就很难复用。

首页采用预定义区块,提供排序、显示隐藏和内容编辑。它给使用者足够明确的调整空间,同时让布局组合保持可理解。第一版只有一套默认主题,这个代码边界为后续扩展留了位置,但还不能称为成熟的主题生态。

编辑体验要贴近日常动作

到 0.1.2,我补上了可搜索、分页的媒体选择器和所见即所得正文编辑器。这里真正要改善的,是编辑者完成一次内容更新的连续性。

封面和 Logo 可以在当前编辑页选择或上传,上传后立即预览;选中素材只更新表单,保存后才使关联生效。图片选择不应该把正在编辑的正文清空,也不应该要求使用者记住媒体编号。

媒体也有独立于页面的生命周期。上传限制为 PNG/JPEG、单张不超过 2 MiB,并使用系统 file 检查实际类型。删除前检查草稿、公开版本和 Logo 引用,避免后台删掉一张图,官网却留下损坏的封面。

正文编辑使用本地 Quill 2.0.3。编辑器的 Delta 经转换后成为受限 HTML,支持标题、加粗、斜体、列表与引用;服务端继续执行自己的无属性标签白名单处理。

这意味着工具栏并不是内容安全边界。即使请求绕过浏览器编辑器,服务端的输出规则仍然成立。编辑器加载失败时保留 HTML 文本框;前端增强可以失效,基本编辑入口仍然存在。

源码还刻意避免打开编辑页时就重写未修改的历史正文。对于 CMS,显示内容与改写内容必须是两件明确的事。

交付质量藏在失败路径里

鉴权、MySQL 会话、CSRF 校验、参数化 SQL、字段长度限制、登录限流,以及不向页面暴露底层数据库错误,都是当前实现的一部分。它们需要出现在每条实际请求路径里,才有意义。

测试也应当保护这些行为。仓库中的校验用例覆盖 HTML 转义、富文本事件属性、非法 URL 标识、CSRF 不匹配、超长字段等;编辑器序列化另有测试。导航换行的回归用例则提醒我,浏览器表单里的 CRLF 这样的小差异,也会变成用户眼中的“保存不了”。

这些测试并不替代完整的交付验收。我更关注的验收场景是:安装中断能否继续、旧编辑页能否覆盖新内容、草稿是否泄露到官网、仍被公开内容引用的图片是否能被删除。它们直接对应使用者愿不愿意放心把内容交给系统管理。

交付文档同样要说明运行边界。当前默认监听本机,公开部署需要反向代理与 HTTPS;登录限流按直接连接 IP 计算,代理后的共享 IP 影响需要部署者理解。备份则要同时包含数据库、私有配置和上传文件,仅复制源码无法恢复一个已运营的网站。

下一步,让每项能力都能被解释和维护

HHY CMS 目前还是一个范围明确的早期版本:单管理员、一套默认主题,不包含多租户、商城、多语言内容管理或插件市场。这篇文章提供中英文版本,也不代表 CMS 已经实现多语言内容能力。

继续研发时,我会优先考虑升级与恢复路径、更多真实交付场景的验证,以及内容和主题边界的稳定性。新增一种角色或一种内容模型之前,要先回答它如何影响权限、发布、迁移和兼容。

对我来说,这个项目也把 HHY Language、Web Runtime 和 Database 串成了一个具体应用。语言能运行服务,数据库能提交事务,最终都要落到一个人修改正文、保存草稿、确认发布的日常动作上。

我希望交付的 HHY CMS,是其他人能够理解、使用并接手维护的建站产品。研发者的工作,正是把这些看似平常的动作背后的复杂性处理好。

延伸阅读

04 / 41

从 v1.5 到 v1.7:我如何为 HHY 建立可验证的优化链路

从 Database 的资源生命周期,到 VM 画像、调用与展开,再到 HIR/MIR 优化编译器:复盘 HHY v1.5.0—v1.7.0 的研发,以及优化已经交付、却仍默认关闭的原因。
2026/09/08 · 18 分钟阅读

写完 HHY Database 1.0,再回到 Runtime 和 Compiler,我对“优化”这件事的要求变得更具体了。

一个表达式少执行几条指令当然有价值。但当语言已经承载常驻 Web 服务、数据库事务、延迟 Stream 和闭包时,执行得更快只是其中一项要求。错误还要发生在原来的位置,取消还要能够到达,借出去的资源还要被收回,旧程序也不能因为升级突然换一种行为。

从 v1.5.0 到 v1.7.0,我沿着这个问题推进:先把应用的资源生命周期接进 Runtime,再找出执行成本,最后把能够证明的变换放进编译器。

这里先说清版本关系:v1.5.0 已独立发布;v1.6 是一组 VM 画像、实验与决策阶段,相关交付统一进入 v1.7.0。v1.7.0 已完成发布,但新增的 IR、反馈特化和标量替换仍需显式启用。 不能把这段经历写成三个版本轮流默认加速。

本文以 v1.7.0 发行提交 8fb0b8f、当前编译器说明和验收策略为依据。性能数字取自已有的最终发布阶段测量记录,写作时没有重新运行压测。

HHY v1.5 到 v1.7 的研发演进与交付边界

v1.5.0:让资源生命周期成为优化的前提

v1.5.0 的 Database 工作让我处理的不只是 SQL。连接池、远程 TLS、事务、游标、精确类型、取消和 Worker 隔离,都要求 Runtime 对资源有明确的责任。

事务回调失败,连接不能带着未知状态回池;Stream 没有消费完,游标也需要关闭;请求结束时,扩展资源不能继续悬挂在一个已经结束的作用域里。Database 扩展保持独立的 1.0.0 版本,HHY 1.5.0 提供它所需要的 Runtime 集成。

这些约束会直接进入下一阶段的优化设计。调整调用帧会碰到资源展开;改变分配会碰到内存配额和 GC;删除一段代码可能顺手删掉取消检查;重排表达式则可能改变第一次错误或外部副作用发生的时机。

所以,v1.5 给后面的工作留下了一条底线:Runtime 优化必须保留应用已经依赖的生命周期。 当脚本长成服务之后,仅比较最终打印结果,已经不足以证明语义一致。

v1.6:先把 VM 的成本看清楚

路线图把 v1.6 归在 VM Architecture & Runtime。我把它拆成四类问题,而没有把“更多指令、更复杂的 GC”预设成答案。

阶段我实际推进的工作随 v1.7.0 交付的结论
v1.6.0指令选择与 opcode / pair / triple 画像画像与评估工具交付;superinstruction 未准入
v1.6.1调用布局、Closure、异常区域与 unwind可关闭实验和差分验证交付;保留现有捕获语义
v1.6.2名字、调用目标与 Map 查找画像单态 Map slot 实验交付;默认关闭
v1.6.3GC、内存保留与调度需求评估保留现有 GC 和有序、有界 parallel;暂不引入新调度器

首先要避免误读画像。HHY_PROFILE_DISPATCH=1 记录的是递归 switch 的入口序列,包括 opcode 及 pair/triple 次数。它不是可以直接融合的相邻 Bytecode 列表,也不等于纯 dispatch 的 CPU 时间。

一个组合出现很多次,只能说明它值得调查。要把它变成 superinstruction,还需要确认求值顺序、错误位置、资源检查和真实执行收益。最终没有准入新的 superinstruction,是这轮评估的有效交付,而不是被省略的实现承诺。

对我来说,“richer instruction selection”的重点,是让选择建立在可解释的执行证据上。增加 Opcode 的数量本身没有产品价值。

调用与 unwind:快路径也要走完失败路径

调用优化很容易只关注正常返回:少分配一个对象,少查一次函数体入口,复用一个帧。但 Runtime 最难处理的是调用中途退出。

v1.6.1 的实验把 Compiler 生成、Verifier 重建核对的调用布局,与紧凑的逻辑调用记录、异常区域表和版本化 unwind 动作表连接起来。逻辑调用记录保存环境、参数与目标的 roots,以及源码、contract、effect、trace 和 profiler 的恢复位置。

正常返回、语言 Error、取消,以及宿主内存配额触发的跳转,都需要把登记过的状态恢复干净。已经退出的记录必须清零,不能让本应结束的环境被旧引用继续保活。

这并没有把解释器改成 trampoline,机器层面的调用和返回仍然依赖 C 与已有的 setjmp/longjmp。新增的是 Runtime 能够验证、观察和展开的逻辑记录。

Closure 也继续捕获共享 Env。两个闭包读写同一个变量,看到的仍是同一个词法环境;从函数返回的闭包、从异常里传出的闭包、延迟 Stream 捕获的环境,都不能回收到帧池。可选的有界帧池只复用未逃逸环境,最多缓存 64 个 Env、64 KiB GC 分配容量。

我没有同时引入扁平 upvalue 或尾调用消除。前者需要新的捕获与别名证明,后者会改变当前递归深度和调用栈行为。这些都应当有独立的语义与收益证据。

Inline cache、GC 与调度,也需要准入理由

Map inline cache 的实现只记住上一次查找的 slot,不保留 Map 或 Value。每次进入仍核对当前 Map 的元素数量、slot 对应 key 的长度和完整字节,再读取当前值。

这个约束意味着,缓存的是一个经过检查的位置提示,而不是旧结果。对象换了、字段顺序变了、同一个 key 的值更新了,都不能返回过去的值。变化频繁的位置会退回通用路径,不无限增加缓存形态。

观测也必须分清楚:guard_hit 可以只是关闭缓存时的候选命中,cached_reads 才代表真实走了缓存读取路径。把两者混在一起,很容易做出漂亮但无效的命中率报告。

GC 和调度的判断同样来自实际问题。当前保留 Boehm conservative GC,以及有界、按输入顺序交付结果的进程 parallel。慢的第一项造成队头等待,确实是成本;直接改成完成顺序,却会改变已有语义。

这轮没有足够的生产瓶颈与需求证据推动分代 GC、增量 GC 或 async scheduler 重写。“暂不准入”不代表永远没有收益,它意味着我需要先拿到值得承担架构成本的证据。

v1.7.0:把可证明的变换前移到编译期

v1.6 让我看清了 Runtime 的优化边界。v1.7 则开始把重复的证明工作放到编译阶段。

默认执行仍然是 Source → AST → 直接 Bytecode Compiler → Verifier → VM。新增的可选路径是 AST → 结构化 HIR → 六个优化 pass → Bytecode;符合条件的函数还可以携带独立验证的整数寄存器 MIR 计划。AST 引擎永久保留,作为语义 oracle 和显式回退。

HHY v1.7 的默认 Bytecode 路径、可选 HIR/MIR 和运行时回退

这里的 HIR 是版本化、非 SSA 的结构化表示。它保存节点关系、源码位置、局部槽位、类型、常量与 effect,CFG 描述语句控制流、循环阶段、函数归属和保守异常边。表达式仍然遵守语言原本的求值顺序。

我没有把它写成通用 SSA 编译器,也没有加入 LLVM 或 JIT。整数 MIR 目前只覆盖有界的直线表达式,其余语法继续由结构化 Bytecode 执行。代码在编译边界生成,Runtime 不临时编译机器码。

这种范围选择,让我可以在现有语言上逐项验证收益,而不用同时维护另一套函数、错误和内存模型。

Verifier 要能够独立否定编译器

优化器说一个值是常量,不代表它就是常量;说一个表达式没有副作用,也不代表它可以删除。

HIR 为 throw、cancel、allocation 和 external effect 保留独立标记。未知操作保守携带全部 effect,含义是“目前没有足够证明允许删除或重排”,而不是断言它每次都会触发所有行为。

Verifier 独立重建类型、常量、effect、CFG、区域所有权和局部槽位来源。复制传播还要核对最近的先前不可变定义,不能越过 shadowing 或把自引用当成有效来源。每个启用的 pass 后重新 verify,发射前再 verify,Bytecode 生成后继续经过已有独立验证器。

我的要求是:Verifier 不需要相信某个 pass 已经正确运行。 只有它有能力拒绝编译器的错误产物,这道边界才真正有意义。

六个 pass,分别证明自己能改什么

当前执行顺序是 copy propagation、constant propagation、fold、peephole、unreachable、DCE。每个 pass 都可以独立关闭。

Pass能做的事我保留的边界
Copy propagation追溯同一区域内已知不可变标量的复制链不跨遮蔽、动态别名和未知来源
Constant propagation传播顺序区域内已知标量绑定不对 mutable 或跨调用控制流进行推断
Fold折叠能够成功求值的有限标量运算不提前吞掉溢出、除零和分配行为
Peephole简化已证明为 Int 的 +0-0*1未知 x + 0 不能直接当成 x
Unreachable删除已证明不会执行的分支体或终止后缀保留条件、循环 header 和作用域容量
DCE删除非末尾、零 effect 的纯值语句保留末尾值、声明与任何可能产生 effect 的操作

例如 (10 + 20) * (4 + 6) 有明确的标量证明空间;未知类型的 x + 0 却不能仅凭数学直觉简化。删除 block 的末尾表达式,也可能改变隐式返回值。

我还保留执行中原有的分配、闭包捕获、调用和循环取消点。优化减少成功操作的 dispatch 次数是预期现象,但错误位置、退出码、输出、副作用、配额和取消行为仍需差分一致。

MIR:反馈只提供候选,guard 才允许执行

参数类型反馈让 v1.7 可以在受支持的函数里执行整数 MIR。当前每个目标最多 8 个参数、64 条寄存器指令;反馈目标数量也有上限。

同一目标连续 8 次收到 Int 参数后,才允许进入特化路径;此后每次进入仍检查参数类型。类型变化立即退回通用路径,累计 8 次类型不匹配后停用该槽。

稳定调用记录不是未来类型永远稳定的证明。函数重绑定也不能复用旧目标的计划,所以反馈身份绑定当前 chunk 与函数 owner,不保存参数或闭包对象引用。

快路径入口去装箱,中间值放在 C 栈上的 int64 寄存器,出口再构造 Int 或 Bool。支持范围包括经过溢出检查的整数加减乘、取模、取负和关系比较。

如果算术失败,deopt 保存失败指令与操作数,在原源码操作处恢复通用错误处理。它不能从函数开头重新执行,把前面已经发生的分配再做一遍。

标量替换,为什么我仍保留分配预约

v1.7 的逃逸分析边界很窄:单个局部整数 List,直接使用已知有效常量索引,没有其他使用者。嵌套聚合、Map、别名、捕获、返回聚合与调用传递都保守回退。

这种形态可以让选中元素直接通过寄存器返回,减少 List 元素的 Value 写入与读取。但所有元素仍按原顺序求值,包括没有被选中的元素。

更重要的是,实现保留原顺序、相同尺寸和扫描类型的托管存储预约,并保持到表达式结束。因为删掉物理分配,可能让本来触发内存配额错误的程序突然成功,也可能改变 GC 观察到的生命周期。

因此我把它称为标量替换与 Value 存取优化,不把它宣传成已经消除堆分配或节省内存。这个限定决定了发布说明是否值得相信。

性能准入:合成收益不能代替真实收益

我给优化编译器设了联合预算:编译成本不超过直接编译的 2 倍加 500 μs;候选指令数和逻辑 Bytecode 存储不能增长;运行时间不高于基线的 95%;托管分配不高于 101%。候选代码尺寸超预算时,整体回退直接 Bytecode。

这里的运行时间包含 prepare,不能只测已经编译完的热循环。逻辑 Bytecode 字节、IR arena 保留字节、进程峰值内存也是不同指标,不能混用。

下面取最终发布阶段的 macOS arm64 本地预算记录:每模式预热 2 次、保留 15 对样本。静态 IR 和整数 MIR 是两组独立评估,不把它们拼成一条“版本加速曲线”。比值为优化模式 / 对照模式,越小越好。

HHY v1.7 静态 IR 本地预算数据:合成样例获益,通用负载未达准入门槛

负载静态 IR 比值类型特化比值
constant-loop(合成)0.7491
propagation(合成)0.9145
typed-arithmetic(合成)0.8616
typed-scalar(合成)0.8004
core-flow1.00430.9991
json-flow1.04291.0260
call-closure0.99291.0350

静态 IR 的常量循环耗时下降约 25.1%,类型特化的局部 List 样例下降约 20.0%。但 core、JSON、closure 这些代表通用执行路径的负载没有达到 5% 收益门槛,部分还有回退。

这组数字的结论是:实现确实在特定形态上产生了效果,但还不足以让所有人默认承担新增编译成本。它们也不是 v1.5.0 与 v1.7.0 的整版本对比,更不能外推成企业应用的整体提速。

四平台验收通过,和默认启用是两件事

最终发行记录包含 macOS arm64、Linux arm64、Linux x86_64 和 Windows x86_64 的 CI 与发布验收。正确性、打包和兼容通过,不意味着所有优化已经获得跨平台的真实性能准入。

验证链路覆盖 AST、直接 Bytecode 与 IR Bytecode 差分,六个 pass 的 64 种组合、独立 IR/MIR 变异、sanitizer、fuzz、配额、取消和真实项目。现有记录还包括每构建 10,000 次 IR 字段变异与新增类型特化的 285 条执行路径。

我在发布阶段也修正了测量和测试方法:Profiler 改为交错配对采样并保存全部样本,原有阈值不变;重复的大规模完整执行用例使用同构小规模样例,原大规模取消用例和真实 SIGINT 验证继续保留。

这些工作不是为了让结果看起来更好,而是让测量能回答它真正应该回答的问题。最终默认仍然是直接 Bytecode,AST 保留,新优化显式启用。

我希望下一次优化仍然能够被关闭

当前的开关把实验边界直接呈现出来。下面的 program.hhy 代表待验证的业务脚本:

# 显式启用结构化 IR 编译链
HHY_COMPILER=ir hhy run program.hhy

# 保留 IR 链路,关闭全部静态 pass
HHY_COMPILER=ir HHY_COMPILER_DISABLE=all hhy run program.hhy

# 在 IR 路径上启用整数反馈特化与局部 List 标量替换
HHY_COMPILER=ir HHY_FEEDBACK_SPECIALIZATION=1 HHY_SCALAR_REPLACEMENT=1 hhy run program.hhy

# 查看编译指标和报告
HHY_COMPILER=ir HHY_COMPILER_REPORT=1 hhy bytecode --metrics program.hhy

从 v1.5 的资源生命周期,到 v1.6 的画像和 Runtime 实验,再到 v1.7 的 HIR/MIR,我真正积累的是一套能够继续迭代的优化方法:找到成本,说明支持范围,独立验证,保存观测,再按平台和负载决定是否准入。

优化已经实现、验证并发布,而默认保持关闭,可以是一个完整且负责的研发结果。 我希望 HHY 之后的提速,都能说明快在哪里、代价是什么,以及条件不再成立时怎样回到可靠的路径。

参考与关联文章

05 / 41

HHY Database 1.0:我如何把数据库访问做成可长期运行的能力

对照 Go database/sql、Python DB-API 与 PHP PDO,梳理 HHY Database 1.0 的实现取舍:连接所有权、有界池、事务作用域、Stream 背压、精确类型与提交未知。
2026/09/07 · 18 分钟阅读

写完 HHY Web Runtime之后,我开始认真看数据库这一层。

HTTP handler 可以常驻,路由可以返回 JSON,但一个真正的 CMS 很快就会问出更具体的问题:保存文章时怎么同时写修订记录?导出几十万条记录时内存会不会一直涨?请求超时以后,数据库里的那次写入到底停了没有?

这些问题让我重新定义 HHY Database 的 1.0:它应该让应用能够判断一次操作发生了什么,也能够确定连接、事务和结果集最终由谁收尾。

DB 1.0.0 于 2026 年 9 月 7 日随 HHY 1.5.0 发布,数据库扩展独立版本化。 发行范围是 macOS arm64、Linux arm64/x86_64;Windows Runtime 包不包含 DB。新的事务回调、资源作用域和数据库 Stream 要求 HHY 1.5.0 或更新版本。Runtime 发布说明

下面复盘实际交付的实现与取舍。代码及能力说明以本文核对的仓库提交 3af2f67 为基线;性能数字来自已有验收记录,不是我在写文章时重新压测的结果。 HHY Database 1.0 的架构:宿主执行业务,扩展拥有连接,数据库负责数据语义

从四个调用入口,走到有资源生命周期的访问层

0.2.0 的基础是 C 扩展通过 libpq 和 MySQL 客户端库执行 SQL,提供 pingqueryexecutetransaction 四个入口。值参数绑定已经存在:PostgreSQL 使用 $1,MySQL 使用 ? 和原生 statement 绑定。

1.0 保留了这四个旧入口与字符串/null 的默认结果,同时补上结构化数据源、有界池、读写事务、保存点、可复用 statement、批量执行、增量游标、精确类型与取消清理。扩展更新记录

我比较满意的是,这次兼容没有靠“把所有东西藏起来”完成。旧脚本继续使用熟悉的结果,新代码显式选择 typed: true 或 Stream;远程连接使用带授权和 TLS 策略的配置,而不是让旧 URL 悄悄忽略不认识的参数。

1.0 的变化,在于连接、事务、游标和语句都有了能够结束、失效和回收的生命周期。 长期运行的服务,真正需要的是这些保证。

对照 Go、Python、PHP,我看的是职责如何安排

数据库驱动并不是语言本身。Go 的对标对象是 database/sql 加具体驱动;Python 是 DB-API 加驱动和池组件;PHP 是 PDO 加对应数据库驱动。把它们都写成“语言自带数据库连接池”,会掩盖真实差异。

对照对象已有抽象与实现方式对 HHY 的启发
Go database/sqlsql.DB 管理连接池,sql.Tx 绑定事务连接池、连接、事务应有不同职责
Python DB-API 2.0约定 connection、cursor、参数绑定、事务和异常接口稳定契约比统一一套语法更重要
Python Psycopg Pool单独的池组件,用作用域管理借用与归还正常退出与异常退出都要有资源收尾
PHP PDO统一访问接口,提供预处理、事务及连接配置保留驱动差异,避免让业务每次手动管理底层细节

Go 的池配置、事务入口,Python 的接口规范和 Psycopg 的作用域行为,都有各自明确的定义。Go 连接管理Go 事务PEP 249Psycopg Pool

PDO 的持久连接允许连接被复用,但其生命周期与进程运行方式相关,不能直接等同于 Go 的并发连接池。连接复用还会带来会话状态清理问题。PDO 连接管理

我没有为 HHY 复制三种语言的 API。对标真正有意义的部分,是让应用在连接、事务、类型和错误这些常用能力上,得到清楚而可验证的行为。

连接池最重要的工作,是管理借出与归还

短连接的成本很好理解:一次小查询之外,还可能反复支付连接、认证与 TLS 握手的开销。复用连接能减少重复工作,但把连接放进数组,还不能叫一个可靠的池。

HHY 1.0 的池围绕下面这条生命周期组织:

等待配额 → 借出连接 → 独占使用 → 清理会话 → 归还
                                    └→ 无法确认干净 → 销毁

连接归还之前,要处理未消费的结果集、未结束的事务,以及可能被业务改动的会话设置。上一条请求把时区或事务状态改了,下一条请求不应该悄悄继承。

池的身份也不能只看 host。数据库、用户、TLS 策略和凭据版本都影响一条连接是否可以复用。错误地把不同身份的连接放进同一个池,会把性能优化变成隔离问题。

我更看重“哪些连接不能归还”,而不是“怎样尽量少关闭连接”。 状态不确定时销毁连接,会多付一次建连成本,但能避免把异常带给下一位调用者。

这里还有一个值得单独说的实现:1.0 每个扩展最多处理 8 个并发协议请求,调用队列上限 64,每个数据源池的 max_open 默认 4、允许 1–32;每个扩展原生会话总数还受 64 的上限约束。

但单次 HHY 调用仍然是同步调用,Web 并发来自 Worker,也没有把数据库调用宣称为可任意传递给 HHY parallel 闭包的任务。原生协议并发、连接池容量和语言层并发,是三个需要分别说明的数字。 连接与并发契约

多 Worker 之后,连接预算要算乘法

我在 Web Runtime 里引入多 Worker 后,数据库池就不能只盯着一个进程的数字。

假设一种部署有 2 个应用实例,每个实例 4 个 Worker,每个 Worker 1 个数据库扩展实例,每个数据源池上限 8,访问 2 个数据源:

总连接预算 = 2 × 4 × 1 × 8 × 2 = 128

这是总预算示例,不是默认配置,也不一定全部落到同一台数据库;服务端容量还要按各池的实际目标分别汇总。滚动发布时新旧实例重叠,迁移任务或管理脚本额外运行,都要继续计入。

多 Worker 连接预算与事务独占连接的关系

HHY 1.5.0 让各 Web Worker 在 fork 之后惰性启动自己的扩展,不共享父进程管道和数据库 socket。池满时有界等待,超时与队列满分别返回 DB_POOL_TIMEOUTDB_QUEUE_FULL。MySQL 取消查询还会使用短暂的控制连接,服务端容量规划需要另外留出余量。并发与取消说明

还有一个很容易在小池里暴露的错误:事务已经占住唯一连接,事务内某段代码却又通过普通池执行查询。它会等待自己释放的连接。Go 官方文档也提醒,连接上限会带来类似锁或信号量的等待关系。Go 连接管理

因此事务内的调用应该使用已绑定连接,不能重新走一次普通池借用。

事务真正难的部分,是让业务逻辑留在同一连接上

CMS 发布文章通常不止一条 INSERT。它可能先读取文章版本,判断是否被别人编辑,再更新内容,写入修订记录,最后提交。

固定 SQL 列表适合预先知道所有操作的批处理;涉及读取与分支时,我需要的是一个受作用域约束的事务。

下面是三种生态里同一思想的简化控制流程,省略连接配置、业务 SQL 和完整错误处理;它们用来说明连接归属,不是可以直接部署的业务代码:

// Go: all transaction work goes through tx.
tx, err := db.BeginTx(ctx, nil)
if err != nil { return err }
defer tx.Rollback()

if err := updateArticle(ctx, tx); err != nil { return err }
return tx.Commit()
# Psycopg Pool: the borrowed connection scopes the transaction.
with pool.connection() as conn:
    update_article(conn)
# On normal exit, an open transaction commits; on exception, it rolls back.
// PDO: use the same connection and explicitly handle failure.
$pdo->beginTransaction();
try {
    updateArticle($pdo);
    $pdo->commit();
} catch (Throwable $error) {
    if ($pdo->inTransaction()) {
        $pdo->rollBack();
    }
    throw $error;
}

Go 使用事务对象,Psycopg Pool 使用连接上下文,PDO 则提供显式事务方法。需要注意,catch 中尝试回滚不能证明一次失联的 COMMIT 没有成功。Go 事务Psycopg PoolPDO 事务

HHY 的实现多跨了一层进程边界:业务函数在宿主执行,连接在扩展进程里。1.5.0 的做法是把闭包留在宿主,由 with_transaction 把闭包内的数据库操作绑定到同一个事务资源。

下面是 1.0 已支持的 MySQL 事务写法。config 是应用预先建立的可信数据源配置,不来自 HTTP 请求;参数值只是示例:

import database

let before = config |> database.with_transaction { tx ->
    let current = database.query(tx,
        "SELECT balance FROM accounts WHERE id = ? FOR UPDATE", [1])
    database.execute(tx,
        "UPDATE accounts SET balance = balance - ? WHERE id = ?", [10, 1])
    current.rows
}

这里的尾随闭包属于 HHY 的管道语法,不是 database.with_transaction(config) { ... }。回调正常结束提交,失败回滚;所有操作都使用 tx。示例只展示作用域,真实扣款还需要余额、账户状态及幂等检查。事务 API

资源 token 由扩展随机生成,绑定宿主请求作用域,不能跨请求、跨 Worker 传递,也不能序列化成持久 ID。事务和游标有初始操作 deadline 对应的租期;关闭后失效。

Web 请求与 embedded hhy_call 在成功或失败边界都会清理泄漏的数据库资源。这个兜底把回收放进请求执行过程,而不等待 GC。连接失联时则不能靠“尝试回滚”宣称数据库一定回到了原状态。宿主资源集成

保存点也要按数据库原有语义解释。它可以让外层事务回到中间位置,但不是独立提交的一层“嵌套事务”。

Stream 的价值,要从数据库读取那一刻开始成立

HHY 的 Flow 和 Stream 很适合表达导出管道。但这里最容易做出一个表面流式的实现:驱动先把全部结果读进内存,然后包装成 Stream,让业务逐条遍历。

这种实现只改变了消费接口,没有改变内存峰值。

0.2.0 的分析指出了全量缓冲的问题。1.0 仍保留有界的普通 query,但把大结果读取交给真正的增量 cursor 和惰性 Stream。普通查询最多返回 10,000 行,也可能更早触及字节预算,调用者必须检查 truncated

1.0 的惰性数据库 Stream 让拉取需求从下游往上游传递:

HTTP 客户端可继续接收
    → 输出端请求下一批
    → HHY Stream 请求 fetch
    → 扩展从数据库读取有界批次
    → 转换并写出,再等待下一次需求

从客户端消费能力到数据库 fetch 的背压与关闭链路

每批不仅限制行数,还要限制字节数、单字段大小与整体执行预算。一行文本可能比一千行小记录更大;Protocol v1 每行 1 MiB 的限制,也要求把 JSON 编码及二进制编码膨胀计入预算。

fetch 默认每批 100 行,字段上限 64 KiB,行或批次还受约 128 KiB 解码后、256 KiB 编码后的预算约束。这些限制必须同时成立;二进制十六进制编码会膨胀,也算在协议成本里。

我不会把这个边界解释成“任意数据都不可能瞬间超出内存预算”。README 明确说明,libpq 可能先接收到一个大行,再检查字段限制。流式内存与批次和最大驱动输入行有关,并不只由最终保留的行数决定。结果限制

提前 take、下游异常和请求关闭会触发资源清理;未完成或被污染的连接不能回到空闲池。事务里提前终止结果还可能使事务失效,需要回滚外层操作,因此回调返回前必须消费完其中的 Stream。

流式也有代价:慢消费者会长时间占住连接,甚至延长事务快照。deadline、导出并发预算和必要时的分任务处理,仍然是应用需要考虑的事情。Stream 生命周期

精确类型,比自动转成数字更重要

默认继续返回字符串或 null,保留了旧脚本的行为。但业务还需要知道一个字符串究竟是金额、主键、日期还是普通文本。

1.0 通过 typed: true 显式开启类型化结果。可表示的标量进入 HHY Int/Float/Bool;Decimal、超范围整数、时间、JSON 等保留带 type / value 的明确表示。类型契约

数据1.0 保留的语义
Decimal精确十进制值,不绕道 Float
大整数主键不先经过浮点表示;超出 HHY Int 范围时采用显式无损表示
null与空字符串、零、没有查询到行分开
时间区分有无时区,明确非法值与零日期行为
Bytes有界十六进制 envelope,宿主转换为 BytesBuffer
重复列名保留位置访问,或明确报冲突,不能静默覆盖

比如 9007199254740993 这样的整数,一旦经过不能精确表示它的 binary64 浮点转换,再转回字符串也补不回精度。协议层“统一成 number”看似方便,实际上可能改变业务主键。

生成主键同样绑定产生它的那次写入。MySQL 的结果来自对应连接上的写入;PostgreSQL 可以通过 RETURNING 表达。不能写完以后,随便从池里借另一条连接去问“刚才生成了什么”。

影响行数也需要保留差异。MySQL 兼容保留 CLIENT_FOUND_ROWS,匹配了行但值没变化,和确实修改了行,不能含糊地都叫“更新成功了几条”。统一访问接口,不意味着抹平数据库语义。

比重试更重要的是,先知道自己是否有资格重试

我认为这次最值得保留的一个错误类别,是 DB_COMMIT_UNKNOWN

假设数据库已经收到 COMMIT,也已经完成提交,但确认响应在返回途中丢了。应用看到超时,无法仅凭这个超时判断事务失败。

如果扩展自动重放整段写入,就可能把文章修订、库存扣减或业务流水再做一次。

1.0 的错误处理明确区分不同失败阶段;应用也需要据此选择处理方式:

失败位置应用可以据此做什么
池等待阶段,尚未发送 SQL根据剩余时间和业务策略决定是否再次尝试
认证或 TLS 验证失败修正配置,不做无意义的重复连接
约束冲突、死锁、序列化失败按具体事务状态和业务语义处理
执行中失联明确结果可能未知,不默认重放写入
提交时失联返回提交未知,通过幂等标识或业务记录核对

扩展不会在错误后自动重放业务 SQL;提交遇到连接丢失或超时,返回 DB_COMMIT_UNKNOWN,不把它冒充成回滚成功。错误与事务语义

取消也类似。调用者收到“超时”只说明它不再等待,不足以证明数据库已经停止工作。Go 的 Context 提供了沿调用链传递取消的方式;HHY 1.5.0 则把 Runtime 取消与数据库扩展连接起来。Go 数据库取消

实现上,MySQL 用独立的短暂控制连接取消自身查询,libpq 17+ 使用异步取消,旧版 libpq 使用旧取消接口。取消失败时能够保证的是连接处置,不是数据库服务端工作立即结束;未知写入结果仍要由应用核对。

超时也进入资源租期。HHY 原生 Duration 会转换为毫秒参数,因此 timeout_ms: 5s 是有效配置;字段名带 _ms,业务仍可以用语言本身的时间单位。MySQL 原生连接与 socket 配置还有秒级粒度差异,不能把统一选项理解成完全相同的底层精度。时间与取消契约

云数据库与 CMS,把抽象拉回真实使用

远程数据源在 1.0 中采用结构化配置,并通过 allow 显式授权 host:port;旧 URL 入口仍用于 loopback。授权边界来自可信脚本的数据源配置,不是 OS 网络沙箱。HTTP 请求不能直接提供 credentials、SQL 或 allow 列表。数据源配置

TLS 配置区分 requiredverify_caverify_identity 等模式,默认验证身份,错误验证不会回退明文。使用 MariaDB 客户端库构建时,支持身份验证,但拒绝仅 verify_ca 的模式;驱动差异明确返回,而不是装作支持。

RDS 可以按远程数据源配置,但真实 RDS 网络、认证、故障切换验收仍待专用实例。交付远程连接能力,不等于完成某个云部署环境的生产认证。 连接边界

CMS 的 install.hhy 则检验另一种边界:驱动负责执行和返回可靠结果,安装工具负责迁移顺序、状态记录、中断恢复和配置写入。

MySQL 部分 DDL 会隐式提交,因此“用事务包住全部建表语句”并不能保证安装整体回滚。安装应记录已完成步骤,重跑时先核验,再继续,而不是假设一切要么全有、要么全无。MySQL 隐式提交说明

这个首个应用也让我能克制范围:DB 1.0 优先把 MySQL/PostgreSQL 的常用访问能力做扎实。ORM、分库分表、分布式事务,都不应该仅因为别的生态有,就一起塞进驱动。

1.0 的验收里,我最看重哪组数字

验收记录包含 MySQL 8.4、PostgreSQL 17 的池、事务、游标、类型测试,以及 AST/Bytecode、双 prefork Worker、异常资源回收、TLS 负例与扩展崩溃恢复。CMS 测试是最小安装 fixture,覆盖中断恢复、重复安装、升级失败和逻辑备份恢复,不是一套随扩展发布的完整 CMS。验收记录

本地 macOS 的增量结果测试,每行使用 64 字节 payload 加一个 ID:

数据库10 万行耗时100 万行耗时扩展峰值 RSS:10 万 / 100 万行
MySQL0.210 s1.961 s14,024,704 / 14,254,080 字节
PostgreSQL0.172 s1.585 s23,707,648 / 23,937,024 字节

两条路径的结果行数增加到十倍,扩展峰值 RSS 在这组负载下都只增加 229,376 字节,约 224 KiB。这比单独列出一个每秒行数,更能说明增量读取有没有避免随着总结果规模累积完整结果。它测的是扩展进程,不是整个 Web 服务,也不是任意行宽或查询计划的保证。原始数据与复现方式

另一个本地单客户端测试持续 300 秒:MySQL 完成 1,583,501 次 SELECT,PostgreSQL 完成 2,752,244 次;结束时各保留 1 条连接,pinned / in-use 都为 0。这提供了连接复用与资源归还的证据,但不能外推成多 Worker CMS 吞吐,也不是 Go、Python、PHP 的对照成绩。

24 小时长稳和真实 RDS 故障切换尚未完成。跨语言比较也仍需在同数据库、SQL、索引、TLS、网络和总连接预算下测量,并公开各自进程模型。验收范围

HHY Database 1.0 最值得做好的,是把 HHY 的 Flow、Stream、结构化错误与进程扩展机制,落到一套能够长期运行的数据访问语义上。 一次顺利的查询很容易展示;连接耗尽、导出中断、提交失联之后仍然知道发生了什么,才是我愿意把真实业务接进来的理由。

参考与阅读基线

DB 1.0.0 于 2026-09-07 随 HHY 1.5.0 发布。本文从早期设计文档出发,以提交 3af2f67f8a889afd65a0215dd5423430e7ea677e 的正式说明与验收记录核对实际交付范围。

06 / 41

把 GPT 拆到标量:我如何理解 MicroGPT 的完整训练算法

沿着字符、计算图、因果注意力、交叉熵和 Adam,拆解 Karpathy 的 MicroGPT:一个不依赖深度学习框架的小模型,如何从随机参数走到逐字符生成。
2026/09/07 · 22 分钟阅读

之前写从零训练 Transformer时,我更关注完整工程链路:数据怎么准备,Tokenizer 怎么选,模型如何保存,以及低 Loss 为什么不等于真实能力。这次读 Karpathy 的 MicroGPT,我想再往下一层。

如果暂时拿掉 MLX、PyTorch、张量算子和 GPU,GPT 的训练究竟还剩下什么?

我的答案是:一个给下一个 token 分配概率的函数,一张记录计算依赖的图,以及一套根据误差修改参数的规则。 文本生成听起来很复杂,但在这个尺度上,每一次乘法如何影响最终概率,都可以追到具体的数字。

本文以 MicroGPT 源码快照 14fb038 为阅读基线。下面的推导、数值例子和配图是我的拆解;数值例子用于解释计算,不是训练成绩。我也不会把一个名字生成器的行为写成通用语言能力。

MicroGPT 从字符到概率,再从损失回到参数的算法闭环

先确定它到底在学什么

假设一条训练数据是 emma。模型学习的是一串条件概率:

P(emma, END | START)
= P(e | START)
× P(m | START,e)
× P(m | START,e,m)
× P(a | START,e,m,m)
× P(END | START,e,m,m,a)

这是概率链式法则在序列上的展开。GPT 用同一组参数实现每一个条件分布,输入前缀不同,输出概率不同。

在这个版本里,字符被映射为整数,特殊 token BOS 同时放在序列两端。因此,概念上的 START 和 END 实际对应同一个 ID。它既教模型如何开始,也教模型何时停止。

位置当前输入可见前缀预测目标
0BOSBOSe
1eBOS em
2mBOS e mm
3mBOS e m ma
4aBOS e m m aBOS

训练标签向右错开一位,注意力只能使用当前及以前的输入。两件事一起成立,才是在预测未来。 如果标签没有错位,模型可以学复制;如果未来位置可见,模型可以直接偷看答案。

训练时下一步喂入真实字符,这叫 teacher forcing。模型这一刻猜错了 m,下一位置仍然会收到训练数据中的 m。生成时则不同,下一步输入来自模型刚刚采样的结果,错误会改变后续整个前缀。

一个参数,怎样知道自己该往哪边改

我觉得理解 MicroGPT 最好的入口不是 Attention,而是一个乘法节点。

a = 2b = 3,计算 u = a × b,再计算 L = u + a。前向结果是 L = 8,反向要回答的是:稍微改变 ab,L 会变化多少?

∂L/∂u = 1
∂u/∂a = b = 3
∂u/∂b = a = 2

∂L/∂a = (∂L/∂u)(∂u/∂a) + 1 = 4
∂L/∂b = (∂L/∂u)(∂u/∂b)     = 2

这里 a 有两条通往 L 的路径,贡献必须相加。把梯度写成赋值而不是累加,会悄悄漏掉一条路径。

标量计算图中两条路径的梯度如何累加

一个自动求导标量至少要保存四类信息:当前数值、当前累计梯度、它依赖的输入节点,以及输出相对各输入的局部导数。运算时建立这些依赖,反向时沿依赖传播梯度。

局部运算对输入的局部导数
z = a + b对 a、b 都是 1
z = a × b对 a 是 b,对 b 是 a
z = a^kk × a^(k−1),这里 k 为常数
z = log(a)1/a
z = exp(a)exp(a)
z = ReLU(a)a 大于 0 时为 1,小于 0 时为 0;零点采用 0

这些规则足以拼出线性层、归一化、Softmax 和损失。矩阵只是标量的容器;在最朴素的实现里,一次矩阵乘法仍然是很多次乘法与加法。

反向传播需要逆拓扑顺序:先处理更靠近损失的节点,等它所有下游贡献到齐,再向输入传播。起点设置 ∂L/∂L = 1。概念上只有一句:

输入节点的梯度 += 输出节点的梯度 × 这条边的局部导数

遍历节点时去重,传播边时却不能把重复输入去掉。例如 a × a 对 a 的导数是 2a,两条输入边都必须贡献一次。

这也解释了为什么共享参数能训练。同一个 embedding 行可能在多个位置被使用,最终只有一个参数对象,但来自不同位置的梯度会汇总到它身上。

把网络尺寸算清楚

源码配置是 1 层、16 维隐藏状态、4 个头、16 个上下文位置;每个头 4 维,MLP 中间宽度 64。字符词表大小记作 V,矩阵按“输出维度 × 输入维度”存放。

参数形状参数量
Token embeddingV × 1616V
Position embedding16 × 16256
Q、K、V、O 四个投影各 16 × 161,024
MLP 第一层64 × 161,024
MLP 第二层16 × 641,024
输出 LM headV × 1616V
合计无 bias、无可学习归一化增益32V + 3,328

若词表是 26 个字母加一个 BOS,V = 27,总参数量就是 4,192。 这是按形状计算出的值,不是所有自定义数据都固定有 4,192 个参数。输入 embedding 和输出 head 在这个版本中是独立矩阵,没有共享权重。

Token ID 本身不是语义坐标。ID 为 20 的字符不会天然比 ID 为 10 的字符“大两倍”;ID 只是用于取出一行可学习向量。

位置向量则为同一个字符加入“出现在第几个位置”的信息。模型接收到的是字符向量与位置向量之和,而不是直接把整数 ID 送进乘法。

一次前向计算,数据经过了哪些地方

为避免张量维度遮住主线,我用单个位置的列向量来描述。记 R 为 RMSNorm,E 为字符表,P 为位置表:

x₀ = R(E[token] + P[position])

u = R(x₀)
q = Wq u,  k = Wk u,  v = Wv u
h = x₀ + Wo · MultiHeadAttention(q, K≤t, V≤t)

r = R(h)
x₁ = h + W₂ · ReLU(W₁ r)

logits = Wout x₁
probabilities = softmax(logits)

这是对当前一层实现的结构表达。不要在结尾自行补一个 final norm:这个快照从最后的残差输出直接进入 LM head。它也不是原样复刻 GPT-2,而是保留了 decoder-only 主干的一种简化。

MicroGPT 单个位置的前向路径与两条残差连接

RMSNorm:先控制输入尺度

对 d 维向量 x:

mean_square = (x₁² + ... + x_d²) / d
R(xᵢ) = xᵢ / sqrt(mean_square + ε)

例如 x 为 [3, 4],忽略很小的 ε,分母是 sqrt(12.5),结果约为 [0.8485, 1.1314]。它没有减去均值,也不会把每个元素变成同一个值;它主要调整整体尺度,同时保留方向信息。

MicroGPT 使用的版本没有额外可学习的缩放向量,ε 为 1e-5

开头连续出现两次归一化容易让人想删掉一个。但第一份归一化后的 x 同时进入残差支路,第二次归一化只位于注意力支路。即使它们前向数值可能很接近,改动第一个也会改变残差路径及其梯度,不能仅凭“看起来重复”就认为等价。

残差:让每一块学习修正量

残差结构可以写成 y = x + F(x),因此导数包含一条直接路径:∂y/∂x = I + ∂F/∂x。网络既能保留已有表示,也能加入新的修正。

这有助于梯度传播,但不意味着任何深度、任何学习率都会稳定。残差不是一张免除数值检查的通行证。

Attention 到底在计算什么

我习惯把三个投影理解成三种职责:Q 决定当前位置如何寻找信息,K 决定历史位置如何参与匹配,V 提供被汇总的内容。它们都是从隐藏状态学出的向量,不是程序员手工定义的字段。

对当前位置 t、某一个注意力头:

score(t,j) = dot(q_t, k_j) / sqrt(d_head)     j ≤ t
weight(t,j) = exp(score(t,j)) / Σ exp(score(t,r))
output_t = Σ weight(t,j) × v_j

分母与加权求和都只遍历当前可见位置。四个头分别完成这个过程,各输出 4 维,拼成 16 维后再做一次输出投影。这是缩放点积与多头注意力在当前尺寸下的应用。

为什么除以 sqrt(d_head)?在分量独立、零均值、方差适当的理想化假设下,点积方差随维度增长。缩放可以避免仅因为维度变大就让 Softmax 过度尖锐。这里每个头 4 维,因此除数是 2,而不是 4 或 16。

看一个我构造的例子。当前 q 为 [1, 0, 1, 0],三个可见 k 分别为 [1, 0, 0, 0][0, 1, 0, 0][1, 0, 1, 0]

点积             = [1, 0, 2]
除以 sqrt(4)     = [0.5, 0, 1]
Softmax 权重     ≈ [0.3072, 0.1863, 0.5065]

若三个 v 分别为:
[1, 0, 0, 0]、[0, 2, 0, 0]、[0, 0, 3, 0]
则输出约为:
[0.3072, 0.3726, 1.5194, 0]

它不是只挑中一个位置,而是按权重混合多个位置的信息。注意力权重也不是字符最终被输出的概率;前者在历史位置上归一化,后者在词表上归一化,中间还隔着投影、残差和 MLP。

没有显式 Mask,为什么仍然是因果注意力

批量计算通常先构造所有位置之间的分数矩阵,再把未来位置设为负无穷,使其 Softmax 权重为零。MicroGPT 则按位置前进:算出当前位置的 K、V,追加进当前层列表,然后只访问已有列表。

计算 t 时,列表中只有 0...t。未来信息尚未进入可访问的数据结构,因果约束由执行顺序实现。

因果注意力的可见位置与保留计算图的 KV 列表

训练时,这些 K、V 仍然连接着计算图。后面位置的损失可以通过注意力,回到前面位置的 K/V 投影与 embedding。向前不能偷看未来,不代表反向梯度不能从后面的损失流向前面的计算。

每个新文档、新生成样本都应重新建立这些列表;不同层也要有各自的 K/V。推理时可以把历史 K/V 当作无需梯度的数值缓存,训练时如果直接 detach,会截断原本需要的梯度路径。

另外,这里不是一个自动滑动的无限窗口。位置表只有 16 行,训练取序列前面最多 16 个预测位置,生成也最多循环 16 次。换成长文档后,后面的内容不会自动变成新窗口;需要自己增加切片策略,否则连结尾标记都可能被截掉。

MLP、Softmax 与交叉熵如何接上

Attention 负责跨位置汇总信息,MLP 对每个位置的表示进行非线性变换。在这里,它把 16 维扩到 64 维,经过 ReLU,再投影回 16 维。

没有非线性时,两次线性变换可以合并成一次:W₂(W₁x) = (W₂W₁)x。ReLU 让这个合并不再普遍成立,也让模型能够根据输入激活不同的特征组合。

LM head 随后给每个候选 token 一个 logit。logit 不是概率,可以为负,也不需要加起来等于 1。Softmax 才把它们变成分布:

pᵢ = exp(zᵢ − c) / Σⱼ exp(zⱼ − c)
c = max(z)

减去相同常数不会改变概率,因为分子分母共同的因子会抵消;选择最大值能避免较大的正数进入指数。把 c 作为普通数值使用不破坏这里的正确导数,因为 Softmax 对整体平移不敏感。不过极端小概率仍可能下溢;生产训练一般使用稳定的 log-softmax / 交叉熵组合,而不是先算很小的概率再取 log。

目标字符为 y 时,单位置损失是 L_t = −log(p_y)。正确字符概率从 0.1 升到 0.5,损失就从约 2.3026 降到 0.6931。整个文档取各位置损失的平均值,而不是只训练最后一个字符。

这个组合的导数尤其值得记住。由 L = −z_y + log(Σ exp(z_j)) 可以直接得到:

∂L/∂zᵢ = pᵢ − 1[i = y]

假设预测 [0.2, 0.5, 0.3],正确答案是第一项,则 logit 梯度为 [-0.8, 0.5, 0.3]。梯度下降会直接提高正确项的 logit、降低其他项;再通过链式法则把这个误差信号传回所有相关参数。对 n 个位置取平均后,每个位置的这份贡献还要除以 n。

在均匀猜测的参照下,27 类的损失是 ln(27) ≈ 3.2958,困惑度为 27。这是理论基线,随机初始化并不保证输出严格均匀,也就不保证第一步恰好打印这个值。

Adam 如何把梯度变成参数更新

拿到梯度以后,最直接的做法是 θ ← θ − ηg。Adam 还会维护梯度的一阶、二阶指数移动平均,为不同参数调整更新尺度。下面直接展开它的更新规则。

用 s 表示从 1 开始的优化步数,避免与 token 位置混淆:

m_s = β₁ m_(s−1) + (1−β₁) g_s
v_s = β₂ v_(s−1) + (1−β₂) g_s²

m̂_s = m_s / (1−β₁^s)
v̂_s = v_s / (1−β₂^s)

θ_s = θ_(s−1) − η_s × m̂_s / (sqrt(v̂_s) + ε)

偏差修正是因为 m、v 从零开始,早期估计会被零值拉低。源码使用 β₁ = 0.85β₂ = 0.99,初始学习率 0.01,并按步数线性衰减;这是 Adam,没有 AdamW 的解耦权重衰减项。

例如第一次梯度为 0.2,则 m 为 0.03、v 为 0.0004,修正后分别为 0.2 和 0.04。忽略极小 ε,第一次更新约为减去 0.01。这个例子说明“梯度大多少,参数就一定多改多少”并不是 Adam 的规则。

训练循环的职责可以独立地写成下面的伪代码;这是阅读用结构,不是复制一份可直接运行的 GPT:

初始化参数 θ,以及 Adam 状态 m、v
每一步:
    取一条文档,编码并加入边界标记
    为每层建立新的 K/V 列表
    对每个有效位置,用真实前缀计算下一个 token 的损失
    对这些损失取平均,执行一次反向传播
    用 Adam 更新 θ,清零参数梯度

每条文档平均后再更新一次,意味着这里每一步的采样单位是文档。它不自动等同于把整个语料所有 token 放在一起求平均:不同长度文档会获得不同的每 token 相对权重。

默认 1,000 步也不等于 1,000 个 epoch。一次 step 处理一条文档;只有覆盖完整个数据集才构成一次遍历。学习率公式使用从 0 开始的 step,因此最后一次更新仍有一个很小的正学习率,而不是恰好为零。

生成时,学习已经停止

训练后,从 BOS 开始重复以下流程:计算 logits,按温度变成概率,采样一个 token,把它作为下一次输入。采到 BOS 就结束,否则最多生成 16 个字符。

pᵢ(T) = exp(zᵢ / T) / Σⱼ exp(zⱼ / T)    T > 0

若两个候选的 logit 差为 1,T 为 1 时,它们的概率比是 e¹ ≈ 2.72;T 为 0.5 时是 e² ≈ 7.39。降低温度使偏好更集中,但不会增加知识,也不保证事实更正确。T 可以大于 1;T 为 0 时不能直接套用除法,通常要另行实现贪心选择。

推理不执行损失反传和 Adam 更新,所以“读过了当前前缀”改变的是激活和缓存,不是长期参数。这个极简实现复用自动求导运算,因此推理仍有建图开销;没有调用 backward,不代表已经具备框架中的 no-grad 执行模式。

生成一个像名字的字符串,能说明模型捕捉到某些字符组合规律;不能仅凭结果新颖就断言没有记忆训练数据。要讨论泛化,还需要保留集、重合率检查,以及与任务对应的评价。

我会怎样验证自己的实现

短代码并不天然正确。我会先用能够手算的输入检查计算,再看训练曲线。

  1. 共享节点梯度L = a×b+a 在 a=2、b=3 时,应得到 4 和 2;a×a 应得到 2a
  2. 数值梯度:对选定参数比较自动求导结果与中心差分 (L(θ+h)−L(θ−h))/(2h);检查时避开 ReLU 的零点。
  3. 因果性:保留相同前缀、改变后缀,前缀位置的 logits 应保持一致;若改写为并行版本,再与逐位置版本对照。
  4. 损失与更新:核对 Softmax 总和、交叉熵导数、第一次 Adam 更新,以及参数梯度是否在每步后清零。
  5. 数据边界:检查 BOS 配对、长文档截断和词表覆盖;最后才做小样本过拟合与独立验证。

我为本文准备了一个不依赖第三方库的计算核对脚本,覆盖共享节点反传、中心差分、注意力数值、交叉熵梯度和 Adam 首步更新。它核对的是文中的数学例子,不是完整 GPT 的训练或性能测试。

想直接运行原作者实现,可以在一个独立空目录保存上述固定版本为 microgpt.py,执行 python3 microgpt.py。首次没有 input.txt 时,脚本会联网下载默认名字数据;使用自己的文件时,每行应为一条非空样本,并留意字符词表与 16 位置截断规则。原始 Gist 的当前代码及修订记录也值得与固定版本对照。

读完之后,我怎样理解“完整算法”

MicroGPT 对我最有价值的地方,是把几件经常分开学习的事情连成了一条可追踪路径:字符决定输入向量,注意力混合上下文,输出层给出概率,损失产生梯度,优化器修改参数,下一次预测因此发生变化。

但从这个闭环到一个可用的大模型,中间仍有大量会影响能力与可靠性的决策。数据质量、Tokenizer、训练目标、模型结构、评测和后训练,都不能简单归结为“跑快一点”。GPU、批处理和融合算子主要改变执行效率;换语料、换监督方式,改变的则是模型究竟在学什么。

回到我自己的工程习惯,这篇代码提供了一种很好的调试顺序:预测不对,先查目标是否错位;训练不动,查梯度是否断开;Loss 异常地好,查未来是否泄漏;采样很奇怪,查概率和结束条件。

我希望自己对模型的理解,最终能落到这些可以检查的关系上。知道每个数字从哪里来,才有依据判断下一步应该改哪里。

参考链接

07 / 41

从脚本到常驻服务:我如何实现 HHY Web Runtime

复盘 HHY v1.4.3 Web Runtime:从可重复调用的解释器、HTTP 请求解析,到 GET/POST、流式背压与多 Worker,以及百万次请求背后的性能边界。
2026/09/04 · 16 分钟阅读

前面两篇文章,我分别写了 AST 解释器优化Bytecode VM。那时我关心的是:同一段 HHY 程序,能不能在保持语义一致的前提下跑得更快?

到了 Web Runtime,问题发生了变化。

脚本执行完,进程退出,很多生命周期问题会被操作系统替你收尾。服务却要一直活着:第一万个请求不能读到上一个请求留下的数据,一次 handler 异常不能带走整个进程,客户端读得慢也不能让服务无限积累输出。

所以我做 HHY Web 的起点,是让 Runtime 经得起重复调用。等这件事成立,路由、JSON API 和框架才有落脚点。

HHY v1.4.3 的发布验证记录里,有两组我比较看重的数据:同一加载上下文重复调用 100,000 次;16 个并发客户端完成 1,000,000 次本机 HTTP 请求,零失败,耗时 131.439 秒,约 7,608.1 请求/秒。 前者验证常驻调用,后者验证特定短请求负载。它们都不是所有 Web 场景的性能承诺。发布记录

HHY Web 架构:反向代理、C HTTP Server、常驻 Runtime 与薄框架

先把解释器变成可以长期调用的 Runtime

我把 v1.4 的工作拆成四个能力阶段,最终统一在 v1.4.3 正式交付。这里的版本表示开发边界,不意味着用户需要依次安装四个版本。

阶段先解决的问题交付的能力
v1.4.0程序能否只加载一次、反复调用?opaque C handles、常驻上下文、JSON ABI
v1.4.1网络请求怎样进入 HHY?HTTP/1.1、Router、请求对象与响应对象
v1.4.2API 怎样长成一个应用?Middleware、静态文件、上传、CORS、Cookie、开发重载
v1.4.3服务怎样承受持续运行?Stream、SSE、Range、多进程 Worker、日志与指标

这个顺序对我很重要。如果一开始只盯着 GET /hello,很容易把每次请求做成一次新的脚本执行。能返回 JSON,却把进程启动、源码加载和执行环境初始化都放进了请求路径。

常驻模型把这部分固定工作移到启动阶段,后续请求重复调用 handler。公开 embedding API 用 HhyApplicationHhyContext 隐藏内部表示,宿主通过 JSON 边界传参和取结果,不直接依赖 HHY 的 Value 内存布局。

一个 application 必须比它创建的 contexts 活得更久;一个 context 也不能被多个线程随意同时调用。这里的生命周期约束,比 API 名字是否简洁更重要。

Web 服务同样复用已经准备好的应用状态。AST 和 Bytecode 仍然共享语言语义,Bytecode 是默认引擎;AST 则继续提供差分验证。顶层可变绑定在 embedding context 中被拒绝,避免把全局变量变成隐式的跨请求状态。单次 handler 异常返回 500,后续请求继续服务。Runtime 设计

Runtime 和框架,我把它们分成两层

HHY Language 内置的 import web 负责请求、路由、响应、Stream 和 Worker。独立仓库里的 HHY Web 0.1.0 则是一层普通 HHY 代码,要求语言版本至少为 v1.4.3。

框架补的是应用组织方式:默认 Request ID、可选 CORS 和 gzip、JSON 错误、Bearer 鉴权,以及更直接的路由函数。网络栈和 Runtime 不需要再实现一遍。

例如 Blueprint,在这里就是一个接收 application、返回 application 的函数:

fn api(application) {
    return application
        |> hhyweb.get("/api/books/:id", book)
        |> hhyweb.post("/api/books", create_book)
}

mount 调用这个函数就够了。模块组合继续使用 HHY 原来的函数和 Flow,不需要引入另一套注册语法。框架真正的价值,是减少每个项目都要写的重复代码,同时保持执行过程可以顺着源码读下去。HHY Web 源码

一个 HTTP 请求,怎样走到 handler

可以先把一个普通请求拆开:

GET /api/books/42?lang=zh HTTP/1.1
Host: example.com
Accept: application/json

这一行里有三个不同维度:GET 是方法,/api/books/42 是路径,lang=zh 是查询字符串。它们最后分别影响路由选择和 handler 的输入。

底层收到的却不是“请求对象”,而是一段段 TCP 字节。一次 recv 可能读不完请求头,也可能连请求体的一部分一起读进来。解析器必须自己识别消息边界。

请求从 TCP 字节到 HHY handler 的解析过程

当前 C Server 先累积数据,寻找 \r\n\r\n,再拆分请求行和 Header。它检查方法 token、以 / 开始的请求目标,以及 HTTP/1.1 版本;随后把路径和原始 Query 分开。

请求体的长度由 Content-Length 决定。长度要能解析为合法数字,也要低于配置的 max_body;没有接收完整,就继续读取。超过请求体上限返回 413,读取超时走 408,畸形输入走 400。进入 HHY 业务代码之前,网络层先把这些边界处理好。

这里有一个容易误解的细节:当前服务支持 chunked 响应,但不接受带 Transfer-Encoding 的请求体。 请求和响应两个方向的能力并不对称。上传接口不能因为服务支持流式输出,就假设它也能接收 chunked 上传。

进入 Runtime 后,请求被组织成 WebRequest:路由参数放在 params,解码后的查询参数放在 query_params,另有 headerscookies、文本 body 和二进制 bytes。例如匹配 /api/books/:id 后,42 才成为 request.params.id

Router 需要同时看方法和路径。没有匹配路径是 404;路径存在而方法不匹配是 405。Middleware 可以提前返回响应,例如拒绝缺少凭据的请求;通过后再调用 handler。最后由 Runtime 组织响应,C Server 写回 Header 和 Body,并结束连接。HTTP Server 实现

GET 和 POST 的区别,不只是参数放在哪里

开发 API 时,我更愿意从“这次请求表达什么操作”选择方法。

方法典型用途安全 / 幂等语义HHY Web 中的入口
GET读取资源、查询列表安全、幂等hhyweb.get
POST创建资源、提交一次操作不保证安全或幂等hhyweb.post
PUT按目标 URI 创建或替换资源状态不安全、幂等hhyweb.put
PATCH局部修改资源不安全,不保证幂等hhyweb.patch
DELETE删除目标资源不安全、幂等hhyweb.delete

这里的“安全”指方法语义上不请求修改资源,不代表接口有鉴权或数据经过加密。“幂等”指同一请求重复执行的预期效果相同,不要求每次状态码和返回内容完全相同。DELETE 第一次返回成功、第二次返回资源不存在,仍可以符合幂等语义。

这些语义需要业务代码兑现。把扣款逻辑注册到 GET,不会因为用了 get 就变安全;POST 如果要支持可靠重试,需要应用额外设计幂等键或去重机制。HTTP 方法语义PATCH 语义

GET、POST 与其他方法的输入位置和业务语义

Query 也不专属于 GET,POST 的 URL 同样可以包含 Query。JSON、表单或二进制则是请求体格式,不能单靠方法名判断。GET 请求体没有通用定义的语义,实际 API 中应避免依赖它。

HHY Web 的 JSON helper 做得很直接:对 request.body 执行 parse_json,解析失败转成稳定的 400 JSON 错误。它并不自动替业务完成字段校验,也没有在这个 helper 里强制验证 Content-Type。需要严格媒体类型约束的接口,应在应用层补上检查。

仓库里的创建图书示例就是这个边界:

fn create_book(request) {
    let parsed = hhyweb.request_json(request)
    if not parsed.ok {
        return parsed.error
    }
    return hhyweb.created({ id: "new-book", book: parsed.value })
}

它演示的是 JSON 解析和 201 响应,没有实现数据库持久化。真正接入业务时,下一步是校验字段、执行存储操作,再返回已创建的资源。

HEAD 和 OPTIONS 也值得单独理解:前者表达读取响应元数据而不传回响应体,后者用于询问通信选项,浏览器的 CORS 预检会用到它。HHY Runtime 提供 CORS 预检能力,但当前薄框架公开的是上表五种路由 helper,不能从 HTTP 标准反推每一种方法都有同名框架函数。

Stream 的价值,在于控制生产速度

普通 JSON 响应通常先完成序列化,再发送一段确定长度的 Body。导出大量数据或持续推送事件时,这样做会把等待时间和内存占用一起推高。

web.stream 把输出转换为 chunked 响应。它的关键约束是:上一块写出之后,才向 Stream 请求下一项。客户端读取速度会通过 socket 写入压力影响服务端的生产速度。

这就是这里的背压。它避免网络输出端无止境地预取数据,但如果应用已经提前创建一个巨大数组,再把数组转成 Stream,前面的内存开销仍然存在。

SSE 则在 Stream 之上增加事件格式,适合单向通知和逐步输出。静态文件还有大文件流式发送和单段 byte Range;缓存验证使用 ETag / Last-Modified,能够减少不必要的实体传输。

这些机制分别解决不同成本:Stream 控制输出积累,Range 缩小读取范围,缓存验证减少重复传输。它们不能合并成一句“支持流式,所以性能更高”。

百万次请求,究竟说明了什么

正式发布记录里的压测结果如下。这是已有发布证据的引用,不是这篇文章重新运行的测试。

项目发布验证记录
请求总数1,000,000
并发客户端16
失败数0
总耗时131.439 s
吞吐7,608.1 requests/s
网络范围loopback,本机回环

结合压测脚本,才能理解这组数字:Python 客户端使用线程池,每次新建 HTTP 连接,发起 GET /,读取响应并检查状态码及 JSON 内容,随后关闭连接。服务来自验收 fixture,配置了两个 Worker;测试关闭访问日志。因此它测的是包含连接、协议处理、handler、JSON 响应和客户端校验的短请求链路。压测脚本服务 fixture

这比只测一个空函数更接近服务,但还没有覆盖数据库等待、公网延迟、TLS、复杂业务、大请求体和慢速 SSE 客户端。Python 压测端也可能成为约束之一。

发布记录没有同时给出机器型号、CPU 使用率、RSS 曲线和 p95 / p99 延迟,因此我不会拿它和 Go、Node.js 或其他框架做横向排名。也不能用 1 / RPS 得出单个请求的平均延迟:这是一组并发负载。

前一篇 Bytecode 文章里约 2.7 倍的收益,来自特定 CPU Flow 负载,同样不能直接套到 HTTP。Web 请求的总时间还包括读写 socket、解析、分配、路由和响应编码。常驻加载减少固定开销;Bytecode 缩短部分执行路径;实际瓶颈仍要逐层测量。

多 Worker 的收益和限制,都要写清楚

当前源码采用 prefork 模型:多个 Worker 进程共享监听 socket,父进程监控并补起退出的 Worker。每个 Worker 在接受连接后,同步完成读取、handler 执行和响应写入,再接受下一个连接。

源码里有 select,但它等待的是监听 socket。它不意味着已经实现了对所有客户端连接的非阻塞事件循环。

当前响应还显式使用 Connection: close。也就是说,这个版本的性能形状是多进程、单 Worker 同步处理、短连接。增加 Worker 可以提高同时处理能力,但不会自动变成海量连接调度器;一个读取很慢或持续时间很长的连接,仍会占住一个 Worker。

这也解释了为什么“有 SSE”和“能承受大量 SSE 在线连接”是两个阶段。背压控制了输出积累,却没有消除连接占用。真正要做大规模长连接,需要进一步设计非阻塞 I/O、连接调度、超时和取消协作,再用慢客户端混合负载验证。

从当前实现还能看到另一个成本:每次处理连接,接收缓冲会按 Header 与 Body 的配置上限申请容量。max_body 因此既是输入边界,也会影响分配规模,不能为了省事无限放大。后续是否改成渐进分配,要由分配热点和内存测量决定。

我会优先补齐短请求与长连接混合场景的尾延迟、Worker 占用和 RSS 变化,再判断优化路由查找、分配策略还是连接模型。只有明确哪部分占了时间,优化才有方向。

把服务真正放到浏览器前面

在线 Dashboard 是这条链路的一个直观入口:HHY handler 返回 HTML,浏览器再调用 /api/status/api/hello,把 JSON 展示出来。

它适合确认页面、路由、Query 和 Request ID 的链路已经连通。不过示例源码里的 Runtime 版本、引擎名和 Worker 数量是显式填写的展示字段,不能把这些卡片当成实时进程探针。真实运行状态还需要结合健康接口、日志、指标和进程监控判断。Dashboard 源码

生产边界也保持明确:HHY 服务监听内部地址,由 Nginx、Caddy 或云负载均衡器终止 TLS / HTTP/2;v1.4 不包含 WebSocket。只有直连客户端全部来自可信代理时,才启用 trust_proxy

开发过程中,我更在意失败之后的行为。错误的 JSON 是否返回 400?Body 超限是否返回 413?handler 抛错后,下一个请求能否成功?上传的临时文件在成功和失败路径上是否都被清理?这些都比首页显示“服务器正在运行”更能说明常驻服务是否成立。

从能执行一段代码,到能持续接住请求

写完 Web Runtime,我对 HHY 的要求又具体了一层。

原来,Flow 把文件、进程、HTTP 客户端和 Stream 连成一个任务。现在,同样的语言能力可以放进常驻 handler,对外提供一个持续运行的服务。框架保持轻,生命周期、错误隔离和资源边界由 Runtime 接住。

百万次短请求零失败,是这条路上的一份证据。同步 Worker、短连接和长流占用,也给下一步划出了清楚的问题范围。

一个 Runtime 能长期服务,不只因为成功请求足够快,也因为失败、等待和资源释放都有明确的去处。

这才是我从脚本走向 Web 时,真正想补齐的能力。

参考

08 / 41

旅行不是打卡:我如何在路上不断修正对世界的想象

走过多少公里、到过多少城市只是轨迹。旅行真正留下的,是一次次推翻预设,让我重新理解地方、他人、技术与自己。
2026/09/02 · 7 分钟阅读

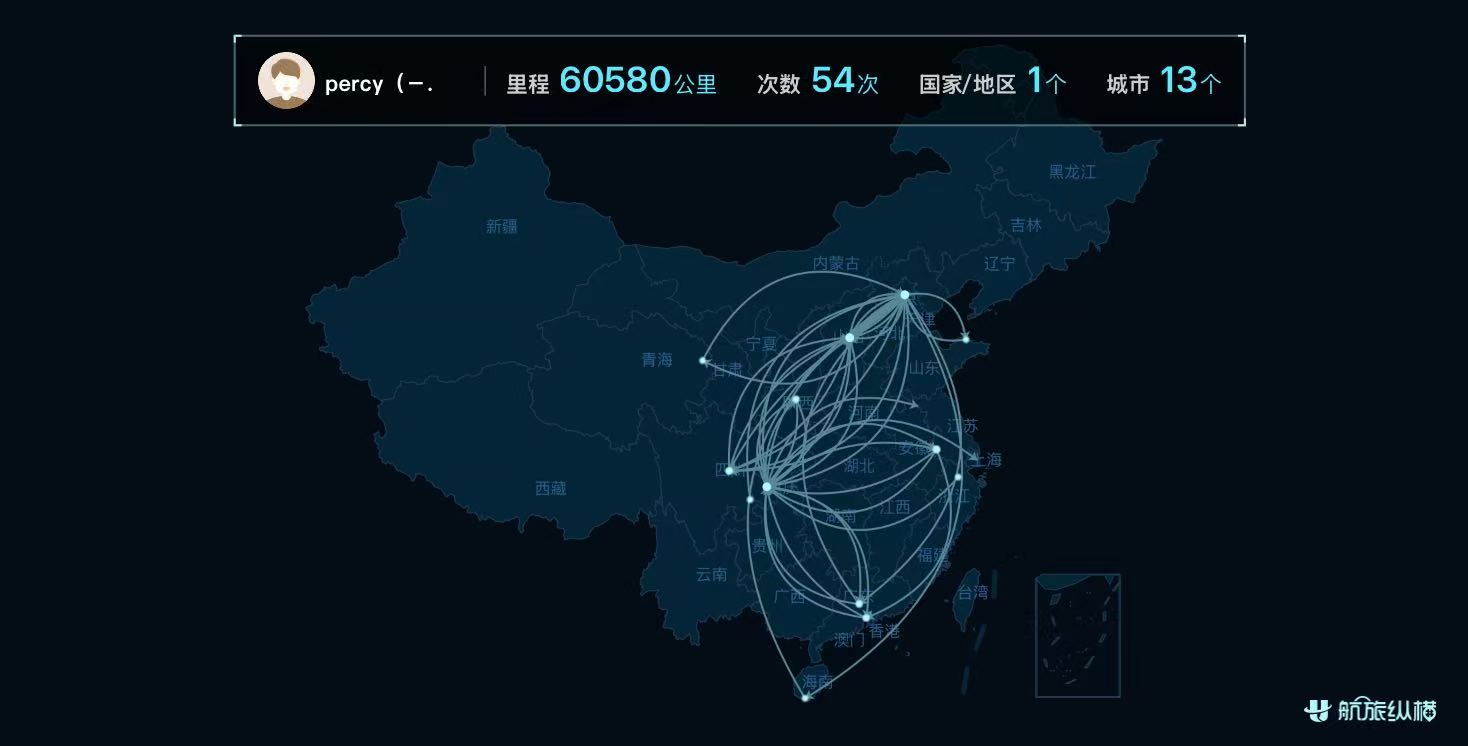
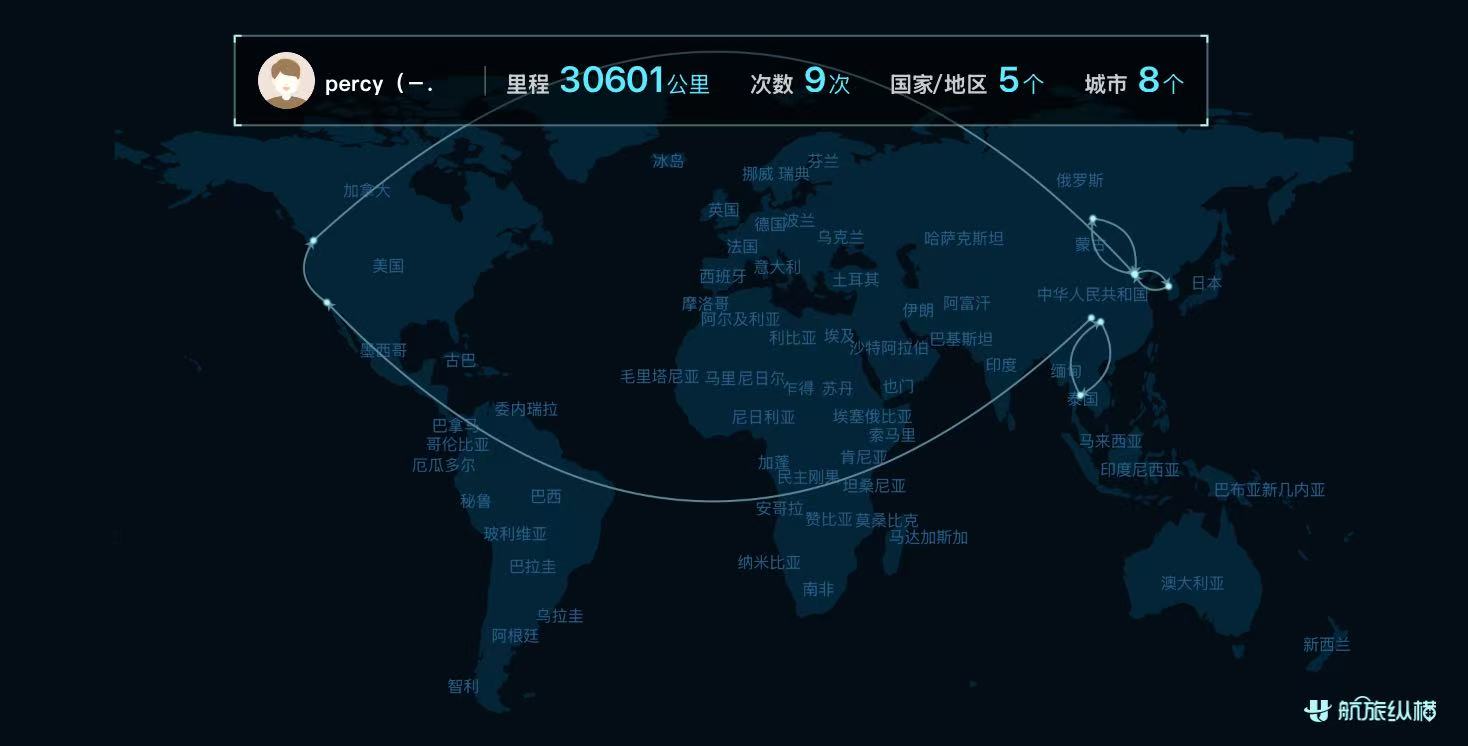
整理这些年的旅行记录时,我看到两组数字:国内 60580 公里,54 次,13 个城市;境外 30601 公里,9 次,5 个国家和地区,8 个城市。

数字很容易制造一种完成感。地图上的线越来越密,去过的地方越来越多,好像世界正在被我一点点收进履历。

但我现在更愿意这样理解它们:这些线记录的不只是我去过哪里,更是现实一次次修正我原有想象的过程。

旅行的意义不是打卡,而是不断修正自己对世界的想象。

这些年的国内旅行轨迹

地图能记录距离,却记录不了偏见怎样松动

没去一个地方之前,我们其实已经“认识”了它。

这种认识来自新闻、书、电影、社交媒体,也来自别人的经验。北方应该是什么样,南方应该是什么样;大城市意味着效率,小城市意味着缓慢;国外更开放,国内更方便;名校里都是天才,热门景点一定值得抵达。

这些判断未必完全错误,但它们通常过于整齐。真实世界很少那么整齐。

我在国内不同城市之间往返,越来越清楚地看到,同一种生活在不同地方有完全不同的解法。城市的性格不只藏在地标里,也藏在早高峰的速度、街边店铺的距离、人与陌生人说话的方式,以及一件小事要经过多少层流程。

有些地方在想象中很遥远,真正抵达后却觉得亲切;有些地方照片里非常耀眼,身处其中却没有多少共鸣。旅行让我意识到,我们对一个地方的判断,经常不是在描述它,而是在暴露自己的经验边界。

这些年的境外旅行轨迹

跨过国境线,我最先修正的不是知识,而是尺度

第一次把脚步放到更远的地方时,我会本能地比较:道路、建筑、大学、公司、服务方式,哪些更先进,哪些更方便,哪些值得学习。

后来我发现,只做横向比较,仍然是一种游客视角。它把复杂社会压缩成一张排行榜,却忽略了每一种秩序背后的历史、成本和选择。

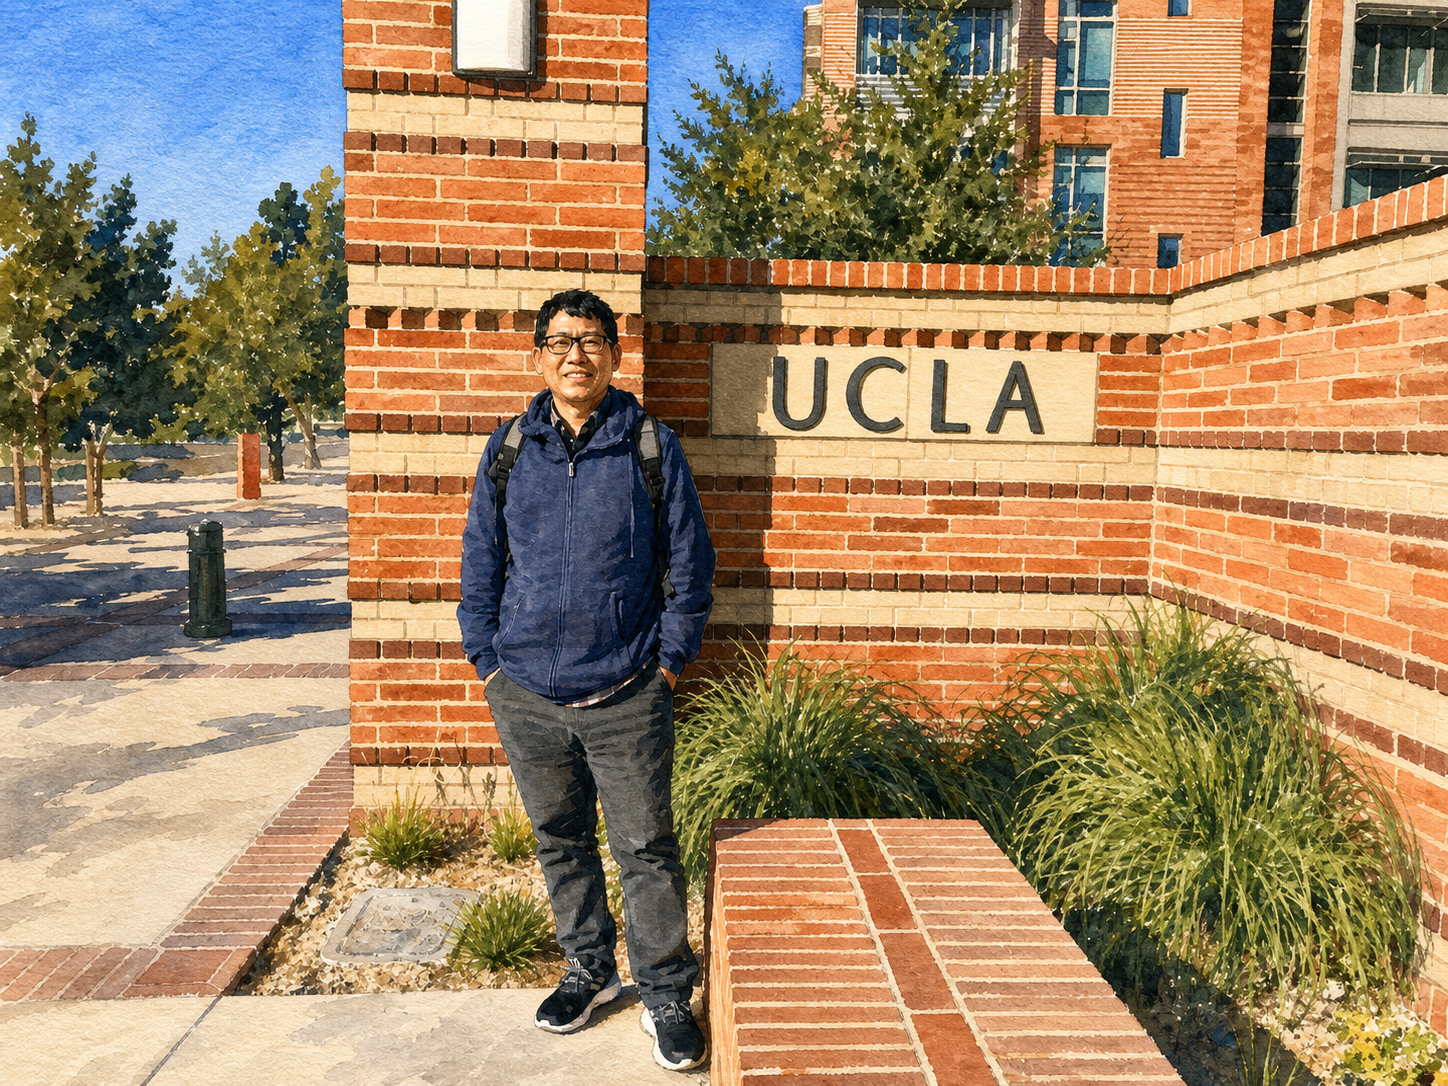
站在 UCLA 的校园里,我当然会看建筑、实验室和学术环境。但真正让我思考的,不是“这所学校有多有名”,而是一个环境如何允许年轻人提问,如何让不同背景的人协作,又如何把知识转化为长期积累。

这也反过来修正了我对技术和创新的理解。创新不是几座漂亮大楼,也不是几个流行概念。它需要容许试错的空间、稳定的制度、开放的交流,以及愿意把一件事做很多年的普通人。

在 UCLA,地标之外更值得观察的是知识如何生长

世界变大之后,我反而更少轻易下结论

旅行没有让我变成一个“见多识广”的人,至少我不愿意用这个词形容自己。它更明显的影响,是让我对确定的答案保持警惕。

在工程工作中,我们习惯抽象、建模和归纳。这些能力帮助我处理复杂系统,但也容易带来错觉:只要收集了足够多的信息,就能快速理解一件事。

旅行不断提醒我,人的生活不是接口,城市不是一组指标,文化也不是可以用几个关键词概括的配置文件。很多东西必须走近之后才看得见,而即使走近,也只能看到其中一部分。

因此,当我后来面对一个陌生行业、一种新的技术路线,或者与我经验完全不同的人时,我会多问一句:我现在看到的是事实,还是自己投射出来的地图?

这份迟疑不是优柔寡断。恰恰相反,它能减少建立在错误前提上的果断。

与谁同行,比抵达哪里更能改变记忆

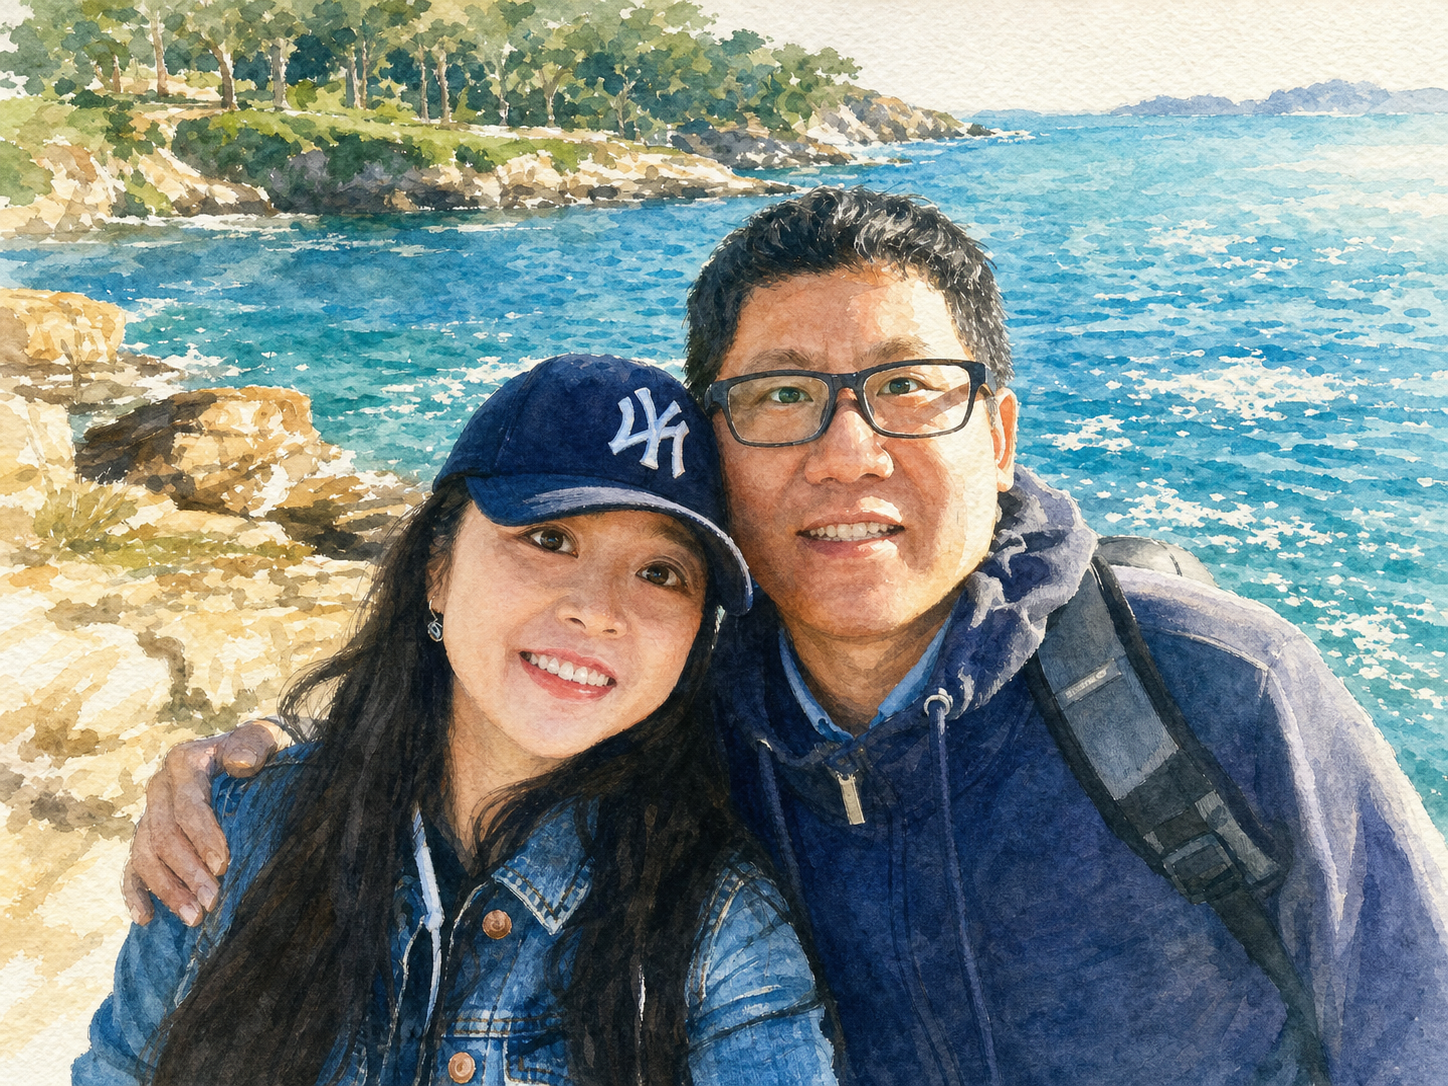
多年后,我们往往记不清某一天去了几个景点,却会记得海边的风、两个人靠在一起时的温度,以及当时谈过的一句话。

旅行把人从熟悉的分工里暂时移开。在日常生活中,我们被工作、家庭角色和计划表包围;到了陌生地方,导航可能出错,天气会变化,语言不一定通,计划也常常被打乱。正是在这些细小的不确定里,我重新认识同行的人,也重新认识自己。

我看见自己什么时候焦虑,什么时候固执,什么时候愿意放弃计划;也看见好的关系并不是两个人永远意见一致,而是当现实偏离预期时,仍然愿意一起寻找新的路线。

多年后留下来的,常常不是景点,而是共同经历过的那一刻

我不再用“去过”定义旅行

“去过”是一个太轻的词。它可能只意味着身体曾经出现在某个坐标,拍下一张照片,然后迅速离开。

对我来说,一次旅行是否真正发生过,要看它回来以后改变了什么:

  • 是否推翻了一个原本深信不疑的判断;
  • 是否让我对另一种生活少一点傲慢;
  • 是否让我重新理解身边习以为常的便利;
  • 是否改变了我做产品、带团队或与人相处的方式;
  • 是否让我承认,世界远比自己的经验更复杂。

如果什么都没有改变,那么里程再长,也可能只是移动。

反过来,有时不需要去很远。认真走进一条陌生街区,与一个不同背景的人长谈,或者在一个地方停留得足够久,同样能让想象与现实发生碰撞。

下一段路,不是为了填满地图

我还会继续旅行,也仍然会拍照、记录路线、保存那些数字。记录没有错,地标也并非没有意义。问题只在于,不要把记录误认为收获,把抵达误认为理解。

地图上的每一条线,看起来都从一个城市通向另一个城市。但真正发生的变化,往往是在人的内部:原来确信的事情变得松动,原来陌生的人生变得可以理解,原来狭窄的尺度被重新拉开。

所以,下一次出发时,我不想只问“还缺哪个地方没有去”。

我更想问:这一次,我愿意让现实修正自己什么?

世界不需要被我完成。它只需要被我一次次认真地重新认识。

09 / 41

不是模型战争:我如何理解跨太平洋 AI 棋局

从 Dimension Capital 的中国 AI 观察出发,讨论算力稀缺、工程效率、开放权重、能源、商业化与资本如何共同塑造中美 AI 的系统性竞争。
2026/09/01 · 14 分钟阅读

最近我读到 Dimension Capital 写给 LP 的一封信:《The Cross-Pacific AI Chessboard》

它表面上讨论中美 AI,真正有价值的地方却不是预测哪一个国家会赢,也不是重新排列一次模型榜单,而是把 AI 竞争拆成了一个相互耦合的系统:模型、芯片、电力、工程效率、开放权重、数据、推理服务、商业收入和资本市场。

这更接近我理解 AI 产业的方式。

过去两年,我们习惯用一个简单坐标观察竞争:谁的 benchmark 更高,谁的模型更大,谁先发布下一代能力。但模型只是系统最可见的一层。一个能力能不能训练出来、部署出去、进入生产环境、形成收入,再把收入变成下一轮算力,取决于整条链路是否闭环。

我的核心判断是:

中美 AI 竞争已经不是模型战争,而是两套被不同稀缺条件塑造出来的生产系统之间的竞争。

跨太平洋 AI 系统地图

稀缺不会只降低速度,它会改变技术文化

Dimension 的第一个观点是“稀缺催生进化”。出口限制压缩了中国实验室获得先进算力的空间,也迫使团队把优化继续向下推进:从模型结构进入 Optimizer、Compiler、Kernel、PTX、推理服务,甚至芯片与互连。

我很认同这个观察,但需要把它说得更准确一点:稀缺本身不会自动产生创新。稀缺也可能让团队停滞。真正产生变化的是,当目标不能降低,而资源又无法线性增加时,工程组织会重新定义什么值得优化。

在算力相对充足的环境里,增加 GPU 可能是边际收益最高的选择;在算力受限的环境里,减少一次内存搬运、提高并行利用率、压缩推理成本,可能比扩大模型更重要。

久而久之,两边形成不同的默认动作:

资源相对充足 → 扩大规模 → 追求能力前沿
资源相对稀缺 → 压榨效率 → 追求单位算力产出

这不是谁更聪明,而是激励函数不同。技术文化往往不是从口号产生的,而是从每个季度真正限制交付的那个瓶颈产生的。

中国获得了 workload,但还没有获得同等 revenue

这封信里最值得记住的一句话,是中国模型正在获得西方的 workload,却没有获得对应的 revenue

开放权重改变了软件进入生产环境的路径。传统企业软件需要供应商评估、采购合同、数据协议和长期服务承诺;一个可以下载、微调并部署在自己基础设施里的模型,却可能由工程团队先开始使用,再逐渐成为系统依赖。

这解释了为什么 Qwen、DeepSeek、Kimi、GLM 等模型可以迅速出现在海外开发者工具、Agent 和推理平台中。它们传播的是能力,而不是传统 SaaS 席位。

但 workload 不等于收入。价值可能留在多个不同位置:

  • 提供 GPU 和推理 Token 的云平台;
  • 把模型包装成工作流的应用公司;
  • 拥有企业客户与分发渠道的平台;
  • 提供数据、评测和验证的基础设施;
  • 最后才可能回到模型开发者。

开放权重可以降低模型层的价格,却未必降低整条应用链路的价值。它更可能重新分配价值:模型能力商品化,部署、分发、数据与业务闭环获得更强议价权。

因此,“中国模型被大量使用”与“中国模型公司商业化成功”是两个完全不同的问题。技术渗透率不能代替收入质量。

AI 能力已经横跨太平洋两次

Dimension 描述了一条很有意思的循环:

美国前沿模型
  → 中国实验室蒸馏与工程化
  → 开放权重模型
  → 美国应用公司采用
  → 卖给美国企业客户

如果把数据、GPU 和海外数据中心也放进去,这条链会更复杂。中国团队可能租用东南亚的 NVIDIA 算力,模型吸收美国前沿能力,开放权重再由全球推理平台部署,最后进入另一家美国公司的生产环境。

AI 能力跨太平洋循环

这说明“美国模型”和“中国模型”正在变成过于粗糙的标签。模型的研发组织有国别,实际能力链路却已经跨越硬件、数据、训练、蒸馏、部署与应用市场。

政策当然可以改变成本和速度,却很难只切断一条边就让整个网络停止。复杂系统会寻找替代路径:远程算力、第三地数据中心、开放权重、模型路由、蒸馏、合成数据和新的供应商都会重新连接断点。

所以真正的问题不是“有没有连接”,而是:连接的成本由谁承担,收入流向谁,谁掌握关键节点的议价权。

美国缺电,中国缺芯片

这封信把双方的约束压缩成一个很有传播力的对照:美国拥有更多先进芯片,但越来越受电力、数据中心空间和电网建设限制;中国电力基础设施扩张更快,却受先进 GPU、制造良率与封装能力限制。

我认为这个框架比“谁的算力更多”更有用,因为算力不是一个单一变量:

有效算力 = 芯片 × 电力 × 网络 × 数据中心 × 软件效率 × 可用时间

任何一项接近零,昂贵芯片都只是无法充分利用的库存。反过来,电力充足也不会自动变成训练能力,仍然需要芯片、互连、软件栈和工程组织。

未来几年,双方都在尝试把自己的短板变成可替代要素:美国通过能源合同、专用数据中心和更高效模型缓解电力限制;中国通过国产芯片、集群工程、模型压缩和开放生态缓解先进 GPU 限制。

竞争的关键不只是优势有多大,而是谁能更快降低自己最稀缺要素的约束强度

技术差距与收入差距不是同一条曲线

Dimension 的另一个重要判断是,中美 AI 的商业收入差距远大于模型能力差距。信中引用了 OpenAI、Anthropic 以及中国模型公司的年化收入估计,但这些数据来自私人市场与行业转述,口径不完全一致,应该把它们当作方向性信号,而不是审计后的财务报表。

即使不依赖具体数字,结构性差异仍然很清楚。

美国头部实验室拥有更成熟的企业付费市场、API 生态、开发者渠道和资本循环。收入可以购买算力、吸引人才、扩建数据中心,再推动下一代模型。中国拥有巨大的用户规模和快速传播的开放模型,但消费者软件付费、企业合同金额以及模型层的价值捕获仍然更弱。

这会形成两种循环:

高收入 → 更多算力 → 更强模型 → 更高价值产品 → 高收入

开放权重 → 更多采用 → 更多反馈与生态 → 更低模型价格 → 更广采用

第一条循环擅长集中资本、冲击能力上限;第二条循环擅长扩散能力、压低采用门槛。未来格局取决于两条循环能否解决自己的弱点:闭源高价值模型能否持续覆盖不断增长的基础设施成本,开放生态能否把使用量转化成可持续收入。

真正的竞争是激励机制

把 DeepSeek、Qwen、Kimi、豆包、GLM 放在一起看,会发现中国实验室之间的竞争强度可能比抽象的“中美竞争”更直接。团队首先面对的是产品节奏、推理成本、模型排名、用户增长和下一轮融资,而不是宏大叙事。

同样,美国实验室的行为也由自身激励塑造:API 收入、企业客户、资本开支、算力合同和安全承诺会共同决定模型是否开放、能力何时发布、采用什么定价方式。

国家提供约束条件,企业和研究组织在约束中优化。最终形成的生态差异,往往来自一系列局部理性决策的累积,而不是一张中心化设计图。

这也是为什么我不愿意把这场竞争理解成围棋棋盘上的两个玩家。它更像两个高度连接的市场,各自内部有激烈竞争,同时又通过模型、硬件、数据和收入相互依赖。

RSI 的关键不是“会不会发生”,而是谁能验证

信中后半部分谈到一种较弱形式的递归自我改进:模型参与自己的研究、编码、实验和迭代,加速下一代模型开发。

我更愿意把它称为“研发循环压缩”,而不是直接使用带有强烈想象的 RSI。今天已经可以看到模型生成实验代码、分析失败、提出候选方案、辅助数据筛选和自动评测,但它仍然依赖人类定义目标、设计验证和承担错误成本。

真正稀缺的可能不只是计算,而是高质量验证:

  • 结果是否真的比基线更好;
  • 提升是否来自数据泄漏;
  • 能力是否能在真实任务复现;
  • 安全、成本和延迟是否一起恶化;
  • 谁能判断一次自动实验值得进入下一轮。

如果自我改进主要受算力约束,美国优势更明显;如果受验证、工程效率和实验吞吐约束,中国形成的效率文化与开放协作可能更有价值。

模型可以越来越快地产生答案,但系统仍然需要越来越可靠地判断哪些答案是真的。

我从这封信里真正带走的三点

第一,稀缺决定优化方向。芯片、电力、收入和验证能力的短缺,会塑造完全不同的研发文化。

第二,能力流动与价值捕获已经分离。一个国家的模型可以服务另一个国家的 workload,但收入可能留在云、推理、应用和渠道层。

第三,系统竞争不能用单点指标解释。模型排名、GPU 数量、发电能力、用户规模或公司估值都只是一层。真正重要的是这些要素能否形成可持续反馈循环。

Dimension 的信带有明确的投资视角,其中一些渗透率、收入和模型来源需要进一步核验。但它提供了一个值得保留的观察框架:中美 AI 已经深度纠缠,竞争不再发生在一条直线上。

我不认为最后会出现一个简单的赢家。更可能的结果是,模型能力继续跨境流动,基础设施逐渐区域化,开放与闭源长期并存,而价值在模型、算力、数据、应用与分发之间不断重新分配。

真正值得持续观察的,不是谁在某一次榜单领先,而是谁先把自己的稀缺要素,变成别人无法复制的工程能力。

参考

10 / 41

从 AST 到 Bytecode:我如何让 HHY 的默认执行引擎快 2.7 倍

复盘 HHY v1.3.10 的 Bytecode VM 研发:从 AST 语义基线、Compiler 与 Verifier,到 Stream Kernel、Profiler、缓存取舍和六种 Runtime 性能对比。
2026/09/01 · 15 分钟阅读

几天前,我写了一篇文章:《不换 Bytecode,我如何优化 HHY 的 AST 解释器》。当时我的判断很明确:先用 Resolver、静态 Slot、轻量调用帧和逃逸安全复用消除重复工作,不因为“做语言就应该有 VM”而重写 Runtime。

今天,HHY v1.3.10 已经默认执行 Bytecode。

这不是路线反转,而是同一条工程原则的下一步:当 Profile 和固定负载证明 AST dispatch 成为值得解决的成本时,再引入新的执行层;引入后,也必须继续用 AST 守住语义。

最终的 CI 数据是:在 1M Core Flow CPU 负载上,Bytecode / AST 墙钟比为 0.3695,也就是 Bytecode 约快 2.71 倍;短任务为 1.0088,几乎持平;持续 JSON 负载为 1.0207,Bytecode 约慢 2.1%。这组差异比一句“Bytecode 更快”更重要,因为它说明不同负载的瓶颈根本不同。

HHY 从 AST 语义基线到默认 Bytecode 引擎的执行架构

我没有删除 AST,而是改变了它的职责

HHY 的前端没有因为 VM 出现而分裂。两条执行路径共享同一套 Lexer、Parser、Checker 和 Resolver:

UTF-8 Source
  → Lexer / Parser
  → Checker / Resolver
  ├→ AST Evaluator
  └→ Bytecode Compiler → Verifier → Execution Plan → VM

AST Evaluator 现在仍然完整存在,并且可以通过以下方式显式选择:

hhy run --engine ast script.hhy
HHY_ENGINE=ast hhy run script.hhy

我把它定义为永久的语义 oracle,而不是等待删除的旧代码。每个完整 fixture 和真实项目都分别在 AST 与 Bytecode 下运行,比较 stdoutstderr、退出码、诊断、资源限制与取消行为。

这样做会多维护一条执行路径,但它给 Bytecode 优化提供了非常清楚的边界:只要两条路径结果不同,先把它当成 VM bug,而不是重新解释语言规范。优化器不能获得定义语义的权力。

Bytecode 不是把 AST 换个名字

HHY 的 Bytecode Compiler 会把每个 AST 节点降低成显式 Opcode,同时保留源码位置、子节点与子树结构、常量引用,以及 Resolver 已经计算出的局部 Slot 元数据。

hhy bytecode examples/00-hello.hhy

这个命令只做编译、验证和反汇编,不执行结果。对我来说,可反汇编不是一个展示功能,而是一种治理能力:当 Runtime 选择某条路径时,我必须能看到 Compiler 到底生成了什么。

Bytecode 解决的核心问题,是把树形调度转换成更紧凑、更连续、可以提前验证的执行表示。AST 不再需要在每个节点上重复解释结构;VM 沿着已经准备好的指令和操作数形状执行。

但我没有让 Bytecode 绕开原有 Runtime。闭包、异常、GC、取消、Stream、effect 和资源限制仍然由共享 Runtime 唯一负责。新的执行层改变“如何到达一次操作”,不建立第二套 Value、Stream 或 Error 语义。

Verifier 是默认启用 Bytecode 的前提

如果 Bytecode 只是进程内临时数据,很容易产生一种错觉:Compiler 是自己写的,所以输出天然可信。这个假设经不起 fuzz、内存损坏和未来缓存格式的考验。

因此,Compiler 之后必须经过独立 Verifier。它会拒绝:

  • 未知 Opcode 和非法常量引用;
  • 畸形树、过深嵌套与非规范 HALT
  • 越界的 Slot 元数据;
  • 非法的 Stream Kernel 类型流和栈形状;
  • 终止 RETURN 之后仍存在的指令。

执行计划还会提前验证 instruction、frame 和 operand 的有界形状。Runtime 不能绕开 Compile、Verify 和 Prepare;这条内部边界有独立版本,并由静态治理测试约束。

我愿意让 Bytecode 成为默认引擎,不是因为它跑通了 benchmark,而是因为错误输入能够 fail closed,AST 回退始终可用,并且两个引擎有持续差分证据。

从通用 Bytecode 到 Stream Kernel

HHY 是一门 Flow-first 的系统脚本语言。只优化通用表达式调度,却不理解最常见的 Stream 组合,收益会很有限。

在 v1.3.7 之前,Runtime 内部已经有少量 Stream Int 快路径,但选择逻辑依赖 magic kind,难以解释,也难以验证。后续版本把这条路径逐步收紧:

  1. v1.3.7 用具名操作和集中 metadata 取代 magic kind,并给出稳定 fallback reason;
  2. v1.3.8 把表达式形状识别从 Runtime 前移到 Compiler,生成版本化 Stream Kernel IR;
  3. 独立 Verifier 检查 Opcode、类型流、栈形状、常量和 RETURN
  4. Runtime 只执行已验证 Kernel,未知或动态闭包无损回退通用 Bytecode;
  5. v1.3.9 让普通执行与 Profiler 使用完全相同的优化选择。

这条设计里,“可回退”不是性能失败,而是正确性机制。Compiler 只能特化它可以证明的情况;无法证明时,通用 Bytecode 必须保持完整语义。

性能比较:快在哪里,也慢在哪里

最终 RC 门禁使用配对、交错采样,比较同一份源码在 AST 和 Bytecode 下的 fresh-process 墙钟时间。

工作负载Bytecode / AST解释
Core Flow 1M0.3695Bytecode 约快 2.71×
Basic Flow 短任务1.0088基本持平,Bytecode 约慢 0.9%
JSON Flow 持续负载1.0207Bytecode 约慢 2.1%

Core Flow 会生成 0..999999,乘以 2,保留能被 3 整除的值,稳定去重、物化并计数。它放大的是表达式调度与 Stream 处理成本,所以 Bytecode 和已验证 Kernel 能产生明显收益。

短任务则主要受进程启动和固定初始化成本影响,执行引擎很难改变总时间。JSON 负载包含解析、Map 与内存操作,Bytecode 当前没有表现出优势。这两个结果没有被隐藏,因为它们直接告诉我下一阶段不应该盲目增加 Opcode,而应该继续从 Profile 找真实热点。

Profiler 本身也被纳入门禁。最终开销为 1.0269×,增加约 2.786 ms,低于 1.35× 和 12 ms 的限制。Profile JSON v2 会记录选择原因、Kernel 版本与 Opcode,并把 CPU 和 Heap 热点归因到实际执行路径。

与其他 Runtime 的同机比较

为了给性能一个更直观的位置,我又在 macOS 26.6.2 arm64 上,用同一个 1M CPU / materialization 负载比较了 Go、Lua、PHP、Java、HHY 和 Python。每种实现都返回 333334;两轮各自先预热两次,再进行七次 fresh-process、确定性随机交错采样。Go 与 Java 的编译时间不计入,Runtime 启动时间计入。

六种 Runtime 在同一 1M Flow 负载上的两轮中位数

Runtime第一轮中位数第二轮中位数
Go 1.27.07.995 ms7.969 ms
Lua 5.5.118.368 ms17.957 ms
PHP 8.5.1043.174 ms43.549 ms
Java 26.0.2.149.394 ms48.153 ms
HHY 1.3.1055.297 ms53.404 ms
Python 3.14.781.747 ms86.459 ms

在这个特定负载上,HHY 比 Python 快,接近 PHP 和 Java,但仍明显慢于 Lua 和 Go。这个结果不是语言排行榜,更不能推导出文件、HTTP、进程或真实爬虫任务的总体快慢。它只能说明:在一个确定的 CPU 与物化负载里,HHY 的默认 Bytecode Runtime 已经进入可比较的区间,同时还有很清楚的优化空间。

我更看重完整公开测量方法和全部 84 个样本,而不是挑一个最好数字做标题。

为什么我没有顺手加入 Bytecode 缓存

有了 Bytecode,下一步很容易想到 .hhyc、进程内缓存或外部预编译文件。但缓存会引入失效、兼容、安全与原子写入问题,不能因为功能看起来完整就默认需要。

v1.3.10 先测量再决策。五个固定真实负载各做 21 组配对 fresh-process 测量,compile + verify 中位数只有 0.004–0.012 ms,占冷启动 Bytecode 墙钟的 0.0078%–0.1341%。它既没有达到至少 1 ms,也没有达到至少 20% 的联合准入门槛。

所以当前明确没有:

  • 进程内 Bytecode 缓存;
  • 磁盘 .hhyc 缓存;
  • 外部预编译 Bytecode 加载器;
  • 对外公开的 Bytecode ABI。

这不是少做了一项功能,而是避免用几乎不可见的收益交换一整套攻击面和兼容负担。未来如果数据触发门槛,缓存必须绑定源码与递归依赖摘要、HHY / Bytecode / Kernel 版本、Compiler feature、target 和安全策略;缓存命中后仍要经过 checksum、有界解析、完整 Verifier 和执行计划验证。

从“不换 Bytecode”到“默认 Bytecode”

回看这条演进路径,我认为最重要的不是 AST 和 Bytecode 谁更先进,而是每一步有没有回答当时最真实的问题。

v1.1.1 先优化 AST,是因为主要成本来自重复名称查找、通用环境分配和 Frame 生命周期;Resolver 与 Slot 在同一 Fibonacci(30) 基准上带来了约 3.39 倍提升。那一步也为后来的 lowering 准备了稳定的 Slot 和作用域元数据。

当这些重复工作被拿掉,Profiler 才更清楚地暴露剩余 dispatch 成本。此时引入 Bytecode,不再是架构愿望,而是有测量依据的工程选择。

我的结论没有变:

先把语义证明变成更短的路径,再让数据决定是否需要新的执行层。

HHY v1.3.10 默认使用经过 Compiler 和 Verifier 的 Bytecode,AST 永久作为语义 oracle 与紧急回退。CPU 密集 Flow 已经得到显著收益,短任务和 JSON 路径仍然提醒我保持克制。

VM 的完成标准从来不是“能跑指令”,而是它能否在更快的同时,仍然让语言的每一项承诺可解释、可回退、可验证。

参考

11 / 41

纠缠、黑洞与真气:我对宇宙和人的三个猜想

从量子纠缠、韦伯望远镜与黑洞宇宙论,到我们是否生活在信息构成的虚拟环境,以及我为什么相信所谓真气对应着一种真实的生命体验。
2026/08/30 · 12 分钟阅读

我经常觉得,科学真正迷人的地方,不只是它不断给出答案,而是它会在我们以为世界已经被解释清楚的时候,突然打开一道更大的缝隙。

量子纠缠告诉我们,分离不一定等于毫无关联;黑洞研究让我们开始用信息、熵和计算重新理解时空;韦伯望远镜则不断把早期宇宙中那些“不该这么早出现”的天体摆到人类面前。

这些事实还不足以证明人与人之间存在量子感应,也不能证明我们生活在虚拟世界,更不能把“真气”直接写进现代物理学。但它们让我越来越愿意认真思考三个猜想:

  1. 人与人之间的缘分,也许像量子纠缠一样,一旦真正发生,就不会被距离简单抹掉;
  2. 我们所在的现实,也许本质上是一个持续处理信息的环境,而黑洞是其中最极端的量子信息系统;
  3. 古人所说的“真气”未必是迷信,它可能是身体、呼吸、注意力与意识共同形成的一种真实体验,只是我们还没有找到足够准确的语言描述它。

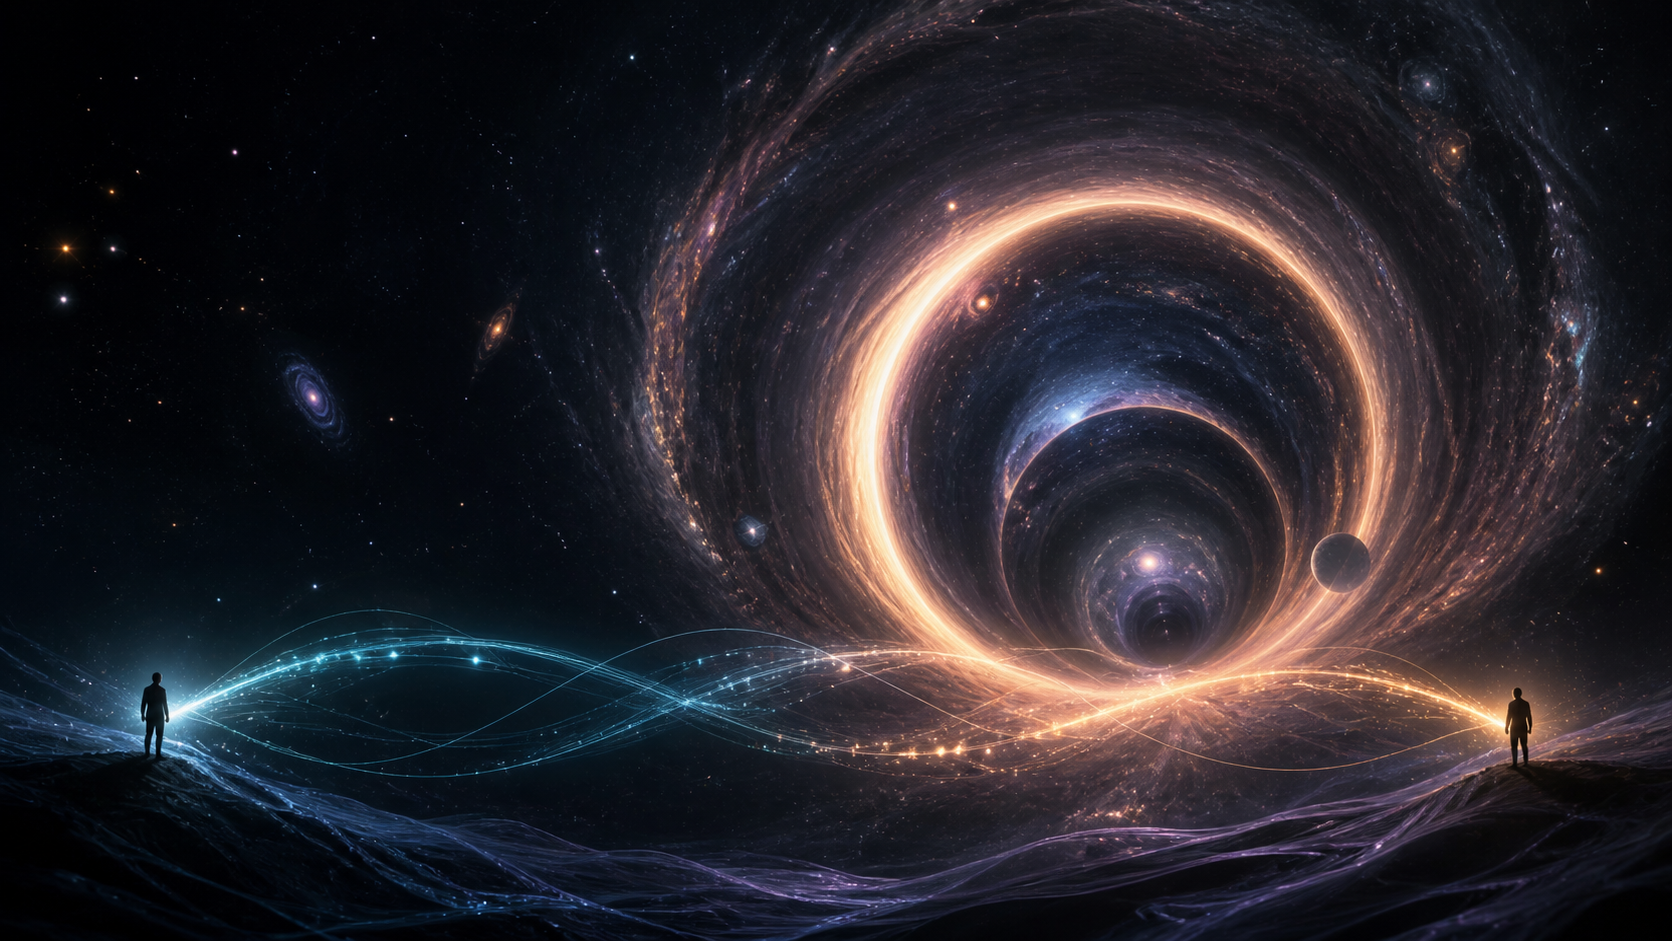
纠缠、黑洞与生命能量的宇宙意象

这篇文章不是科学结论,而是我站在科学边界前的一次个人思考。

量子纠缠:距离无法取消已经建立的关系

量子纠缠最容易被误解成:两个粒子无论相隔多远,一个发生变化,另一个都会立即“感应”并收到消息。

更准确的说法是,两个纠缠粒子要作为一个整体来描述。即使它们相距很远,对它们进行测量时,结果仍会呈现经典局域理论无法解释的关联。2022 年诺贝尔物理学奖表彰的贝尔不等式实验,进一步确认了这种量子关联不是简单的局域隐藏变量造成的。

但纠缠不能用来超光速传递一条由人控制的信息。单独看任何一端,测量结果仍然是随机的;只有双方后来用普通通信方式比较数据,关联才会显现。

这一区分很重要。科学上的纠缠不是心灵感应,也不能直接证明所谓缘分。

但作为一种比喻,它仍然打动我。

人与人真正相遇之后,也会共同形成一段无法还原为两个孤立个体的历史。一句话、一次信任、一段并肩经历,会同时改变两个人之后看待世界的方式。后来即使相隔很远,不再频繁联系,那段共同经历也已经进入彼此的记忆、选择和性格。

我理解的缘分不是神秘力量在远处替我们发送信号,而是:

两个人一旦真正参与过彼此的生命,就已经改变了对方的初始条件。距离可以中断交流,却不能让已经发生的关系从历史中消失。

所以我喜欢用量子纠缠描述缘分,不是因为两者在物理上相同,而是它提醒我:世界的基本单位也许并不总是“孤立的东西”,关系本身同样可以是现实的一部分。

韦伯看到的,是一个过早成熟的宇宙

过去的宇宙演化图景大致是:大爆炸之后,物质逐渐冷却,第一批恒星和星系慢慢形成,小结构经过漫长的合并与吸积,才长成今天看到的巨大星系和超大质量黑洞。

韦伯望远镜没有推翻这幅图景,却让它变得不再轻松。

韦伯在大爆炸后几亿年的宇宙中看到了数量丰富、异常明亮而致密的天体。有些早期星系的亮度、质量或结构成熟度高于原先模型的直觉预期;一些黑洞也出现得太早、长得太快。问题未必是“大爆炸错了”,更可能是我们对大爆炸之后第一代星系和黑洞如何形成的理解还不完整。

“Little Red Dots”就是最有代表性的谜团之一。这些小红点大量出现在宇宙诞生后的前十五亿年。早期解释在年轻致密星系、尘埃和活跃黑洞之间摇摆,而新的深度光谱证据正在把部分对象指向一个更奇特的图景:超大质量黑洞被高温、致密、部分电离的气体茧包裹,形成所谓的“black hole star”模型。

2026 年,韦伯对 GLIMPSE-17775 的光谱中识别出四十多条谱线,多项特征都支持“被致密气体包裹、快速吸积的黑洞”这一解释。另一个小红点 Abell2744-QSO1 的研究,则为某些超大质量黑洞可能在宿主星系成熟前就已迅速形成提供了证据。

这些发现真正动摇的,不一定是宇宙有一个炽热早期阶段,而是我们过去习惯的先后顺序:

旧直觉:小星系 → 恒星死亡 → 小黑洞 → 缓慢长成超大质量黑洞

新可能:致密气体直接坍缩 → 巨型黑洞种子 → 黑洞与星系共同塑造彼此

韦伯像是把人类的视线向宇宙出生的方向又推进了一层。我们看到的不是标准模型被一夜推翻,而是它的空白处开始发光。

我们会不会生活在一个黑洞内部?

“黑洞宇宙论”提出了一种大胆可能:黑洞内部未必终于无限密度的物理奇点。在某些包含挠率、量子引力或高密度反弹机制的模型中,继续坍缩的物质可能在极端密度下发生反弹,形成一个新的膨胀时空。

如果这个模型成立,那么站在母宇宙看,一个区域坍缩成了黑洞;站在黑洞内部看,经历的却可能是一次类似大爆炸的宇宙诞生。

母宇宙
  ↓ 恒星或物质坍缩
黑洞与事件视界
  ↓ 极端密度下避免奇点并反弹(假说)
子宇宙开始膨胀
  ↓ 产生恒星与新的黑洞
更多子宇宙(进一步推论)

事件视界会把内外两个区域在因果关系上隔开。因此即使我们真的生活在某个黑洞内部,也很难直接看到所谓母宇宙。对外部观察者而言,那只是一个黑洞;对内部观察者而言,空间却可能广大而持续膨胀。

这个理论最吸引我的地方,是它把“大爆炸”从“一切凭空出现”改写为一次传承:我们的宇宙也许不是绝对起点,而是另一个宇宙中某次坍缩的内部延续。每个宇宙产生黑洞,每个黑洞又可能孕育宇宙,于是现实形成一种层级繁衍的结构。

但必须说清楚:目前没有观测证据证明我们的宇宙位于黑洞内部。韦伯发现早期黑洞和小红点,也不能直接证明黑洞宇宙论。两者的关系是“新的异常让边缘理论值得重新讨论”,而不是“新的异常已经证实了边缘理论”。

黑洞是一台量子计算机吗?

如果把计算理解为“物理状态按照规律变化,并处理信息”,那么黑洞确实很像宇宙中最极端的信息处理系统。

黑洞的熵与事件视界面积相关;落入黑洞的信息如何保存、混合并可能通过霍金辐射重新出现,是现代物理最深的难题之一。在量子信息理论中,研究者会把黑洞描述成极快的信息扰乱器,也会用量子电路、纠缠和纠错的语言研究它。

因此我说“黑洞是一台量子计算机”,更准确的意思不是里面放着芯片、程序和屏幕,而是:

黑洞可能把物质、能量、时空和量子信息压缩在同一个物理过程里。它不是人造计算机,却可以被理解为一种遵循量子规律的信息处理系统。

再向前一步,就会进入“宇宙是否是一场计算”的问题。有些理论把时空看成从更底层的量子信息处理之中涌现出来。假如空间、时间和物质都是系统内部的状态,那么我们所谓的“现实”,确实会像一个巨大的运行环境。

但“像计算”不等于“由某个程序员模拟”。模拟宇宙假说目前没有决定性证据,也很难提出可区分于普通物理定律的检验。对我而言,“虚拟”不是说眼前的一切都是假的,而是说:

我们体验到的现实,也许只是更底层规则呈现给观察者的一层界面。

桌子依然坚硬,感情依然真实,选择依然产生后果。即使世界由信息构成,生活也不会因此失去意义。电子游戏里的角色不知道晶体管,但这不妨碍它所在层级拥有稳定规则;同样,我们看不到现实的最底层,也不代表我们经历的一切不真实。

真气:也许不是一种粒子,而是一种整体状态

我相信所谓的真气是有的。

但我不急着把它说成一种还未被发现的基本粒子,也不认为只要科学暂时解释不了,就可以随意把任何感觉都归为能量。

人在呼吸变深、注意力集中、身体放松或持续练习时,确实可能感到温热、流动、充盈、震动,甚至某种贯穿身体的力量。现代生理学可以从多个方面解释这些体验:呼吸影响自主神经系统,姿势改变肌肉张力与血流,专注放大内感受,长期训练改变人对身体信号的分辨能力。

这些解释并没有取消体验,反而说明体验有真实的身体基础。

我更愿意把“气”理解成古人对一个复杂整体状态的压缩命名:

呼吸节律
+ 神经系统状态
+ 血流与肌肉张力
+ 身体内部感觉
+ 注意力与情绪
+ 长期形成的动作模式
= 被体验为“气”的整体生命状态

现代科学习惯把系统拆成变量,传统经验则更习惯从整体感受出发。两套语言可能指向同一具身体,只是切入角度不同。

现有证据还不能确认存在一种脱离这些生理过程、可独立测量并在人体间传递的“真气能量”。这是我必须承认的边界。但我也不愿意因为一种经验暂时没有对应的仪器读数,就断言它毫无价值。

对我来说,真气首先是一种可被训练、感知并改变行动质量的生命体验。将来它也许会被更细致地拆解为神经、呼吸、筋膜、循环和意识之间的耦合;也可能有一部分始终保留在人类第一人称体验的语言里。

三个猜想,其实在追问同一件事

量子纠缠讨论的是:关系是否比距离更根本。

黑洞宇宙论讨论的是:终点是否也可能是另一个起点。

真气讨论的是:生命是否能被拆成零件之后完全解释。

它们跨越的尺度完全不同,也没有科学上的直接因果关系。我把它们放在一起,不是要构造一个“量子玄学统一理论”,而是因为它们共同挑战了三种过于简单的直觉:个体彼此孤立、宇宙只有单一起点、身体只是零件之和。

我的观点可以浓缩成三句话:

缘分不是量子纠缠,但纠缠让我重新理解关系。

黑洞未被证明孕育宇宙,但它让“大爆炸之前是什么”有了另一种想象。

真气未被证明是一种独立能量,但人对自身生命流动的体验是真实的,值得研究,也值得尊重。

科学的价值,不是替所有未知盖上“迷信”的印章;想象力的价值,也不是把所有愿望包装成“科学已经证明”。真正困难、也真正迷人的位置,恰好在两者之间。

我愿意保留怀疑,也愿意保留惊奇。

也许有一天我们会发现,宇宙、生命和意识都只是同一个巨大信息过程在不同尺度上的表现。也许不会。

但只要我们仍在认真观察、诚实区分证据与信念,并不断提出更好的问题,这场探索本身就已经有意义。

延伸阅读

12 / 41

不要只经营一份工作:关于职业窗口、第二曲线与持续进化

职业发展既要懂得在时代红利与个人优势重叠时兑现价值,也要提前设计第二曲线,并用持续学习保留面对变化的选择权。
2026/08/28 · 8 分钟阅读

工作这些年,我越来越相信,职业发展不能只用“稳定”或“跳槽”来解释。

一个人能获得怎样的回报,既取决于能力,也取决于所处的行业周期、城市、平台、团队和家庭阶段。努力当然重要,但努力发生在什么时间、什么位置,同样重要。

我把自己的思考归纳成三件事:在窗口期兑现价值,提前设计第二曲线,持续理解正在发生的变化。

职业窗口、第二曲线与持续进化共同构成长期选择权

在天时、地利、人和重叠时,尽可能兑现自己的价值

每个行业都有窗口期,每个人也有自己的窗口期。

移动互联网高速发展的阶段,程序员供不应求。对不少人来说,两年左右更换一次平台,确实可能更快获得薪资增长、职责升级和技术视野。那不是因为“跳槽”本身值得追求,而是市场愿意为稀缺能力支付更高价格。

但职业选择从来没有一条适合所有人的公式。

如果身处一家真正优秀的公司,业务在增长,团队值得信任,个人能够承担更大的责任,并且有机会通过股权、长期激励或组织成长分享结果,那么留下来可能比频繁更换工作更有价值。腾讯这样的公司在高速成长阶段,就让一部分长期同行的人获得了远超工资的回报。

反过来,如果一家中小企业缺少增长空间,管理方式长期消耗人,老板只强调忠诚却不愿分享结果,薪资、能力和责任持续错配,那么“稳定”可能只是把个人最有价值的几年低价出售。

我认为更诚实的职业判断是:

在不突破法律、职业道德和长期信用的前提下,选择最适合自己、能够让长期利益最大化的路线。

这里的“利益”不只是当期工资,还包括能力增长、行业位置、身体状态、家庭需要、可迁移的人脉、作品和未来选择权。

因此,既不要为了一个短期涨幅机械跳槽,也不要因为习惯、恐惧或老板画出的远景无条件留下。真正需要判断的是:这个平台还在放大我,还是已经开始消耗我?我分享到了增长,还是只承担了增长的成本?

第二曲线,不应该等主业出问题后才开始

经济上行时,人很容易高估一份工作的稳定性;经济下行时,组织会用最直接的方式重新计算成本。

程序员尤其容易陷入一种错觉:只要技术还不错,只要在一家公司持续交付,职业路径就会自然延长。但公司里的职位、权限和认可,很多时候属于组织,不完全属于个人。一旦岗位被取消,曾经熟悉的流程、内部影响力和头衔,未必能直接转换成外部市场价值。

如果一个大龄程序员被动离开公司后,才开始更新简历、了解市场、补充新技术、寻找新的身份,压力往往会集中到同一时间爆发。焦虑不只来自暂时没有工作,更来自只有一条收入曲线、一个职业身份和一种被市场定价的方式。

所以,第二曲线不是失业后的补救措施,而是主业仍然稳定时就要开始的长期建设。

它不一定意味着辞职创业,也不等于随便找一个副业。它可以是:

  • 在主技术栈之外,建立 AI、产品、数据或管理能力;
  • 持续写作、开源和公开表达,把经验变成外部可见的作品;
  • 参与真实项目,形成不依赖当前公司的交付记录;
  • 建立咨询、课程、工具、内容或小产品的最小闭环;
  • 经营跨公司、跨年龄和跨行业的可信关系;
  • 逐步积累能够独立解决某类问题的个人品牌。

第二曲线早期通常很弱,短期回报也可能远低于主业。它真正的价值,是让能力、影响力和收入来源不再完全绑定在一个组织上。

第一曲线负责今天的确定性,第二曲线负责明天的选择权。

当环境变化时,有第二曲线的人不一定不会焦虑,但不会从零开始。他已经有作品、有市场反馈、有新的能力组合,也知道公司之外的世界如何评价自己。

周末不是用来透支,而是用来保持进化

我赞成利用周末学习,但不赞成把所有休息都变成另一种加班。

持续进化的关键不是偶尔熬夜学一门新技术,而是建立一种长期可重复的节奏:每周留出几个小时,阅读、实践、写作、交流,或者做一个足够小但真实的项目。

这种积累在当下尤其重要。AI 正在改变获取知识、编写代码、构建产品和组织协作的方式。很多旧经验仍然有价值,但经验如果不能与新工具、新场景结合,也可能变成限制判断的惯性。

除了学习技术,我也认为要持续了解年轻人在想什么、使用什么、为什么做出不同选择。

这不是为了刻意模仿年轻人,更不是追逐每一个热点,而是避免只用过去成功的经验解释今天。年轻人的内容习惯、工具选择、消费方式、工作期待和表达方式,往往最早反映新的产品机会和组织变化。

真正的“保持年轻”,不是语言上跟风,而是仍然愿意对陌生事物保持好奇,愿意承认自己的知识结构需要更新。

把职业当成一个需要主动设计的系统

职业安全感不等于拥有一份长期合同,也不等于在某家公司待得足够久。

更可靠的安全感来自一组可以跨环境工作的能力:我能不能持续解决真实问题,能不能让市场看见结果,能不能在平台变化后重新组合资源,能不能在收入暂时中断时拥有缓冲,能不能与不同年龄和背景的人继续合作。

如果把职业看成一个系统,我会长期观察四个问题:

  1. 窗口:我所在的行业和岗位,是在扩张、成熟还是收缩?
  2. 价值:当前平台给我的回报,是否匹配我承担的责任和创造的结果?
  3. 曲线:除了现在的工作,我是否在积累另一种被市场需要的能力和身份?
  4. 更新:我是否仍在接触新工具、新一代用户和新的工作方式?

这四个问题没有一次性的答案。人生阶段会变,家庭责任会变,行业周期也会变。最重要的不是永远做出“正确选择”,而是不要把选择权长期交给一家公司、一个老板或一种技能。

最后

回头看,职业发展中最遗憾的事,往往不是某一次没有抓住涨薪机会,而是在自己的窗口期里没有认真判断价值;也不是某一天突然失去工作,而是在一切看起来稳定时,从未为变化做准备。

该进攻的时候,要敢于进攻。在个人能力、行业红利和现实条件重叠的阶段,应该主动争取更合理的回报,不必用廉价的“忠诚”安慰自己。

该积累的时候,也要耐心积累。第二曲线很少在一开始就带来明显收益,但它会逐渐把焦虑变成准备,把被动等待变成主动选择。

而学习,是贯穿两条曲线的底层能力。利用周末保持输入、实践和交流,不是为了让自己永远忙碌,而是为了在世界变化时,仍然看得懂、跟得上,也有能力重新出发。

最好的职业策略,不是预测哪家公司永远安全,而是让自己在任何阶段都保有重新选择的能力。

13 / 41

实战多 API 数据采集器:异构来源如何汇成一张增量表

用 HHY 并发采集 OpenAlex、Crossref 和 GitHub,统一字段、隔离分页失败,并按复合键增量合并 CSV。
2026/08/27 · 8 分钟阅读

采集一个 API 不难。真正有工程价值的问题是:三个来源的分页规则、JSON 结构和指标完全不同,如何让它们进入同一条可靠 Flow,并且第二次运行不会把第一次结果简单覆盖?

这个项目同时采集 OpenAlex 学术成果、Crossref 论文元数据与 GitHub 仓库。默认每个来源两页、每页五条,最终统一成七个字段:sourceexternal_idtitleurlrecord_typemetric_namemetric_value

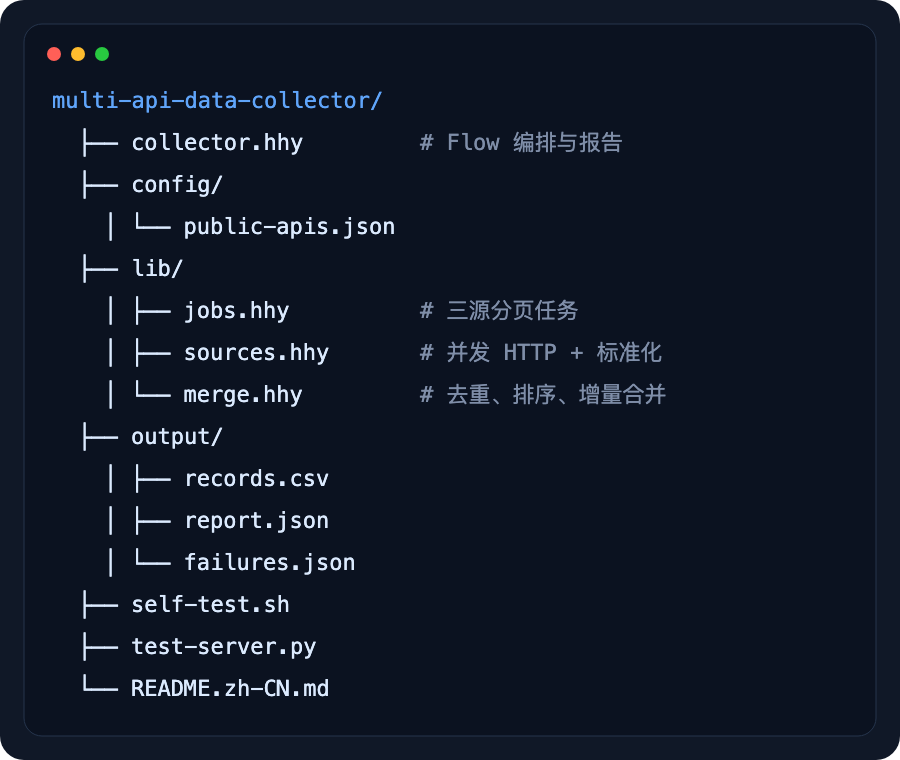
多 API 数据采集器的真实项目目录

先把分页差异变成 Job

OpenAlex 和 GitHub 使用 page,Crossref 使用 offset。jobs.hhy 不试图抹掉这个差异,而是把它变成显式任务:

for page in range(1, config.pages + 1) {
    jobs = append(jobs, { source: "OpenAlex", page: page, offset: 0 })
    jobs = append(jobs, { source: "Crossref", page: page, offset: (page - 1) * config.per_page })
    jobs = append(jobs, { source: "GitHub", page: page, offset: 0 })
}

六个 Job 进入 parallel(3)。每个请求前等待 250 ms,并设置 10 秒 timeout、两次 retry 与 500 ms backoff。这不是严格的全局 rate limiter,但能避免示例在启动时瞬间向公开 API 发出一组突发请求。

GitHub 未认证搜索额度较低。生产环境需要更低频率或通过安全的进程扩展注入认证请求,而不是把 token 写进配置和仓库。

统一 Schema,但不伪装语义相同

三种 API 分别有自己的 request 与 normalize 函数。OpenAlex 的指标是 citations,Crossref 是 references,GitHub 是 stars;它们共享 metric_name/metric_value 形状,却没有被错误地塞进一个含义模糊的 score

OpenAlex → work id / display_name / citations
Crossref → DOI / title / references
GitHub   → full_name / repository / stars
                    ↓
source / external_id / title / url / type / metric_name / metric_value

统一字段是为了让存储、去重和消费简单;保留指标名是为了不牺牲来源语义。

下载成功后解析仍可能失败,因此网络阶段和 normalize 阶段都有独立的 attempt。失败结果记录 source、page 和 error,并写入 failures.json。成功页仍可继续进入合并,但总报告会 ok=false 并返回 1。

增量合并需要稳定身份

程序先尝试读取已有 CSV,再把旧记录与新记录展开到同一条 Stream。复合键使用 source + external_id

[existing, incoming]
    |> stream
    |> flat_map { records -> records |> stream }
    |> group_by { record -> join([record.source, record.external_id], ":") }
    |> map { group -> group.values[length(group.values) - 1] }
    |> sort_by { record -> join([record.source, record.external_id], ":") }
    |> collect

旧记录在前、新记录在后,因此同键时保留最后一条,新数据自然覆盖旧数据。最后按相同复合键稳定排序,避免 API 返回顺序变化制造无意义 diff。

CSV、运行报告和失败列表都原子写入。输出记录保留原始 URL,让每一行都能回到来源核验。

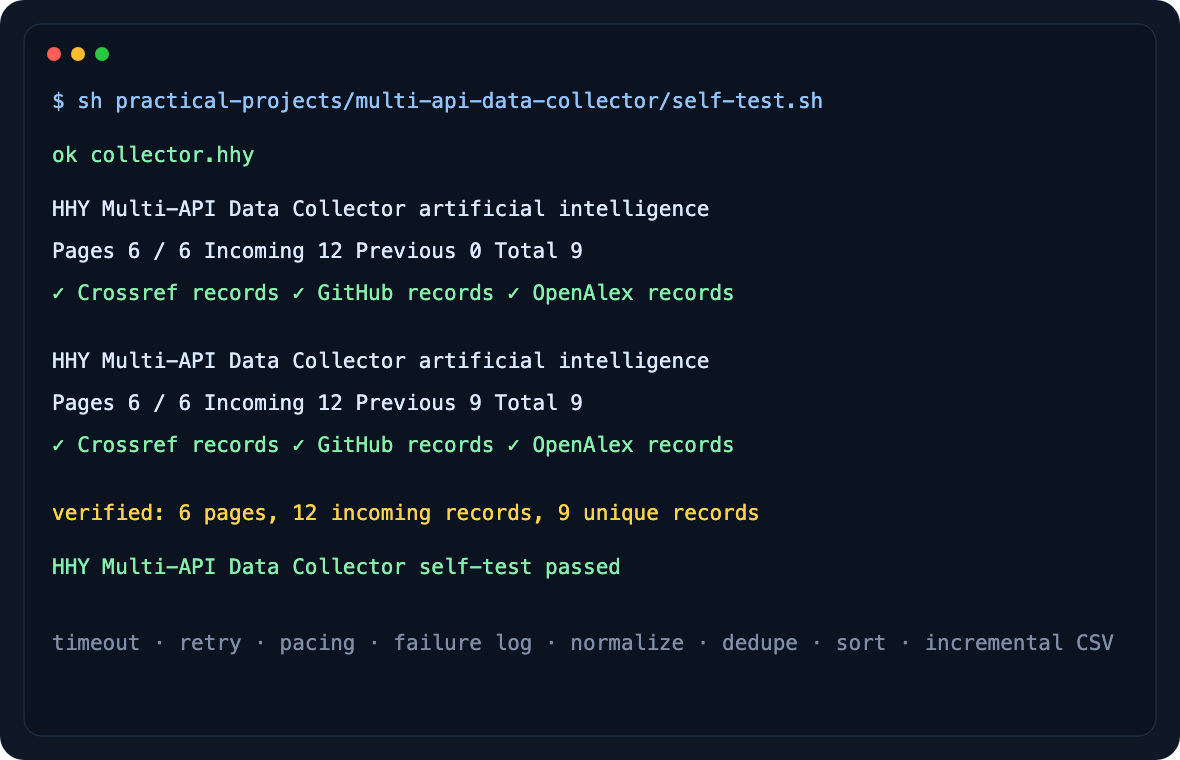
多 API 数据采集器连续两次运行的增量验证

为什么测试要连续运行两次

本地 fixture 第一次返回 12 条跨页输入,去重后得到 9 条唯一记录。第二次运行先读取这 9 条旧记录,再采集、覆盖和合并,最终仍然是 9 条。

sh practical-projects/multi-api-data-collector/self-test.sh

只测试第一次运行,只能证明“可以导出 CSV”;连续两次才验证复合键、覆盖方向、稳定排序和幂等形状。测试服务使用本机随机端口和临时目录,退出后删除,不会把 fixture 数据写进正式 output。

这条采集 Flow 的边界

parallel 在这里优化的是 HTTP 等待,不是把数值计算包装成并发故事。retry 处理短暂故障,不会修复错误 Schema。增量合并保留最新观测,也不等于拥有完整历史。

把边界讲清楚以后,这个项目才真正展示 HHY 的方向:用少量可组合原语处理网络、Stream、错误和原子文件,让可靠性策略直接出现在业务 Flow 里。

参考

14 / 41

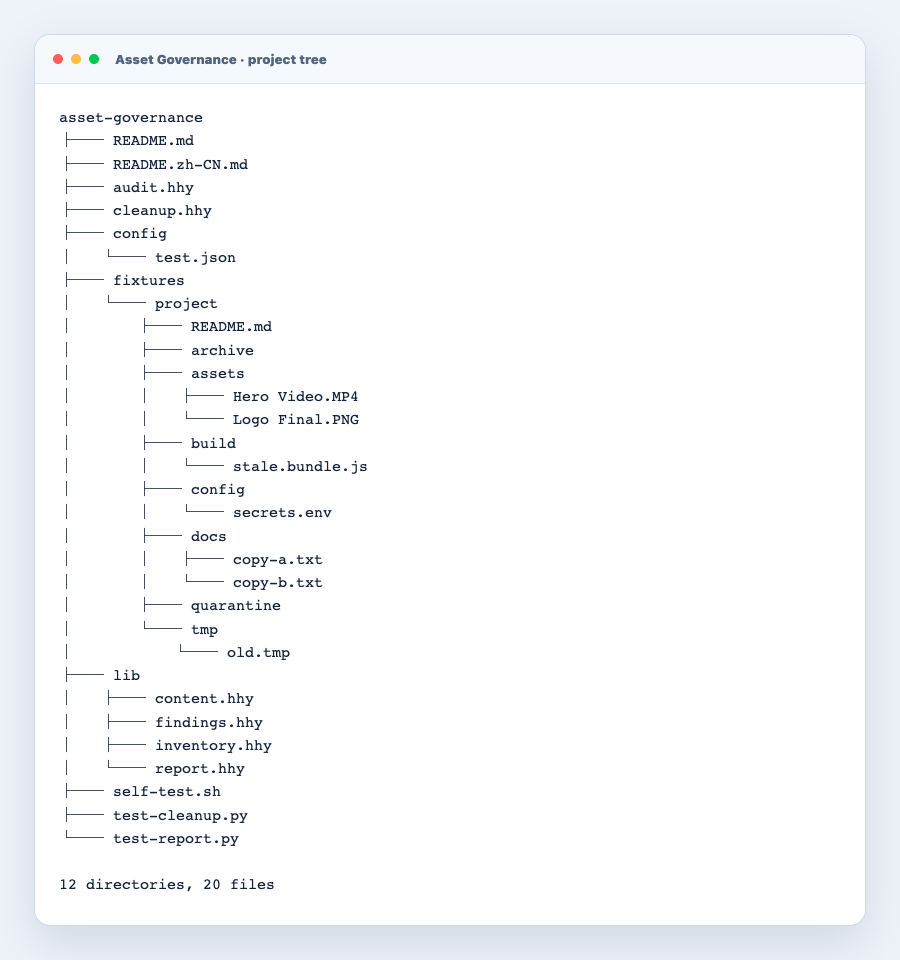
实战 Asset Governance:先审计,再让副作用发生

用 HHY 扫描大文件、旧资产、命名、重复内容与疑似凭据,并通过报告白名单和 Runtime dry-run 安全执行整改。
2026/08/27 · 7 分钟阅读

清理脚本最危险的地方,往往不是它不能删除文件,而是它太容易删除文件。

Asset Governance 因此被我拆成两个程序:audit.hhy 只观察并生成报告,cleanup.hhy 只执行报告中明确列出的 copymoveremove。判断与副作用之间保留了一道可以阅读、评审和 dry-run 的边界。

自动化越接近破坏性操作,计划越应该成为一等产物。

Asset Governance 的真实项目目录与风险 fixtures

审计器先建立资产清单

inventoryfiles("**/*") 收集文件,以 Bytes 累计总大小,并检查三类元数据:超过配置阈值、文件名包含大写或空格、修改时间超过 365 天。

if file.size > limit {
    findings = append(findings, finding(
        join(["large", file.name], "."),
        "large_file",
        "warning",
        "File exceeds configured size limit",
        file.name
    ))
}

内容检查只读取明确支持的文本扩展名。疑似凭据会生成 critical finding,但原文绝不进入报告。重复文本通过 group_by { record -> record.content } 识别,输出也只包含文件名列表。

这里有意没有把图片和视频交给解码器。这个项目治理的是文件元数据和放置规则;如果目标只是发现超大 MP4,没有必要为它引入媒体解析依赖。

报告既是证据,也是整改输入

报告包含 inventory 统计、findings 和配置提供的 actions。出现 critical 时 audit.hhy 返回 1,但报告仍会完整原子写入。

这和直接在扫描循环中移动文件有本质区别。审计失败不等于程序失控,它意味着程序成功发现了一个必须处理的问题;操作者仍然拿得到完整证据。

cleanup.hhy 不接受自由格式命令,只识别三个动作:

if action.kind == "copy" {
    copy(source, path_join(root, action.target), { overwrite: true })
} else if action.kind == "move" {
    move(source, path_join(root, action.target), { overwrite: true })
} else if action.kind == "remove" {
    remove(source)
} else {
    exit(3)
}

动作来源受报告约束,执行也不经过 shell。这把注入面和不可预测命令排除在模型之外。

Dry-run 应该由 Runtime 保证

我没有在 cleanup.hhy 中写一套 if dry_run。同一个程序直接通过:

hhy run --dry-run practical-projects/asset-governance/cleanup.hhy PROJECT report.json

Runtime 的 EffectDispatcher 拦截 copy、move、remove 等副作用并输出计划。业务代码走过相同分支,却不会真的改变文件。相比在每个调用点手工维护预览逻辑,这种语义更统一,也更难遗漏新的副作用。

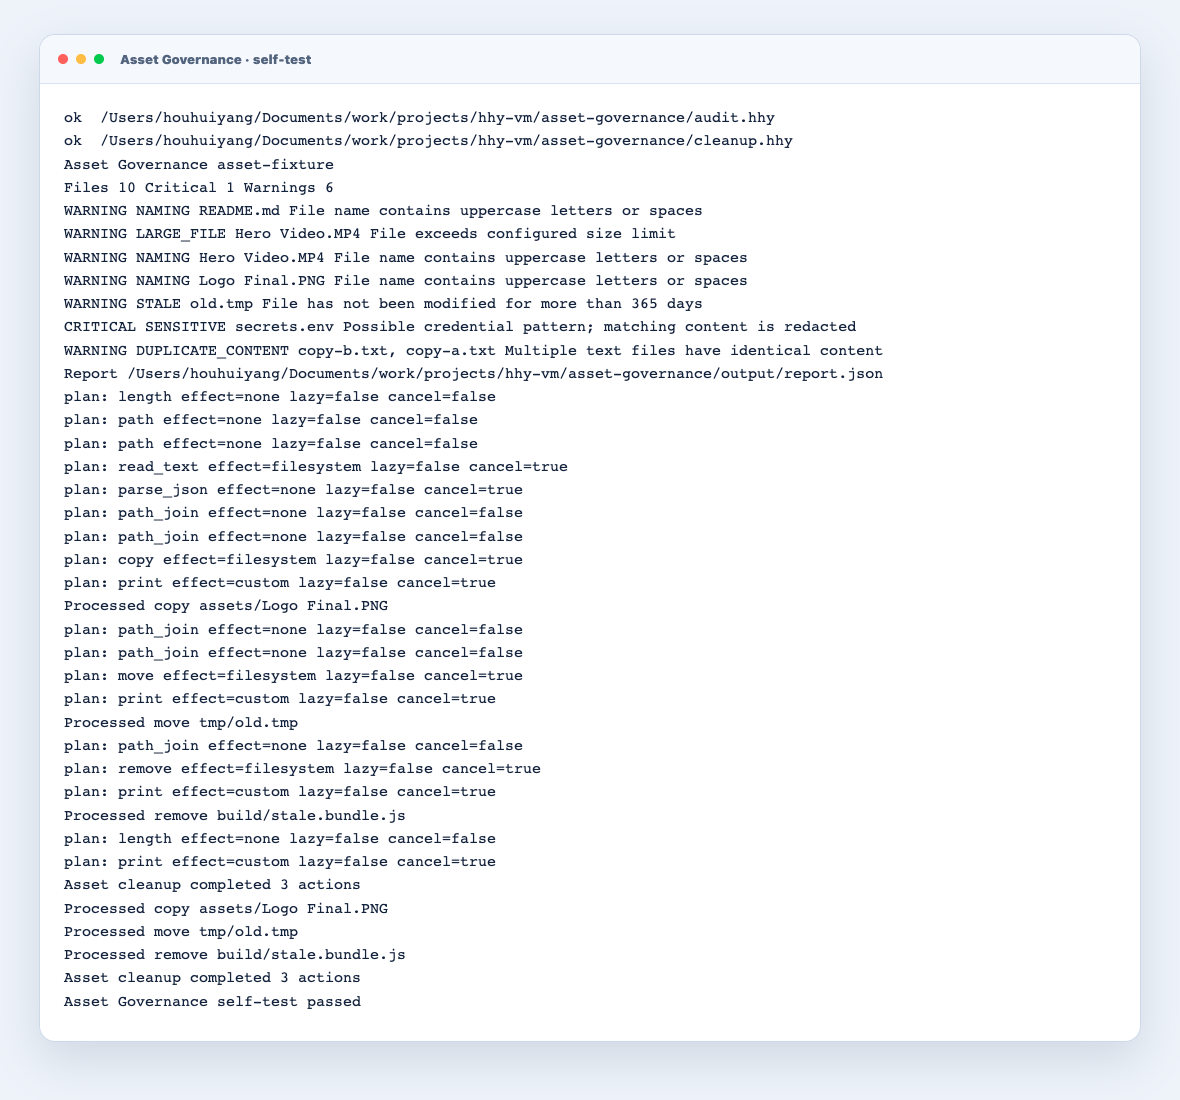
Asset Governance 的审计、dry-run 与正式整改自测

自测用 mktemp 创建隔离工作区,先验证 large、naming、stale、sensitive 和 duplicate findings;dry-run 后逐项确认文件完全不变;正式执行后再确认 copy、move、remove 都生效。

我保留的工程原则

安全自动化不是永远不做危险操作,而是把观察、决定和执行分开,让每一步都有可检查的输入输出。

Asset Governance 最重要的产物不是清理后的目录,而是这条可审计链:文件事实形成 findings,findings 与人工配置形成 actions,actions 经过 dry-run 才进入真实副作用。HHY 的原生 Path、Bytes、Duration、Regex 和 Effect 模型让这条链不需要退回字符串拼接。

参考

15 / 41

实战 DataFlow ETL:用一条 HHY Flow 串起 CSV、JSON 与 HTTP

从客户 CSV、事件 JSON 到并发画像补全、部门聚合和原子双输出,我如何用 HHY 写一条完整 ETL 管道。
2026/08/27 · 7 分钟阅读

ETL 很适合检验一门语言的数据抽象是不是只停留在语法层。

真实管道不会只有一个整齐的 JSON 数组。输入可能同时来自 CSV、文件目录和 HTTP;中间会遇到脏字段、无效记录和远程失败;输出既要给人看,也要给下游程序继续消费。

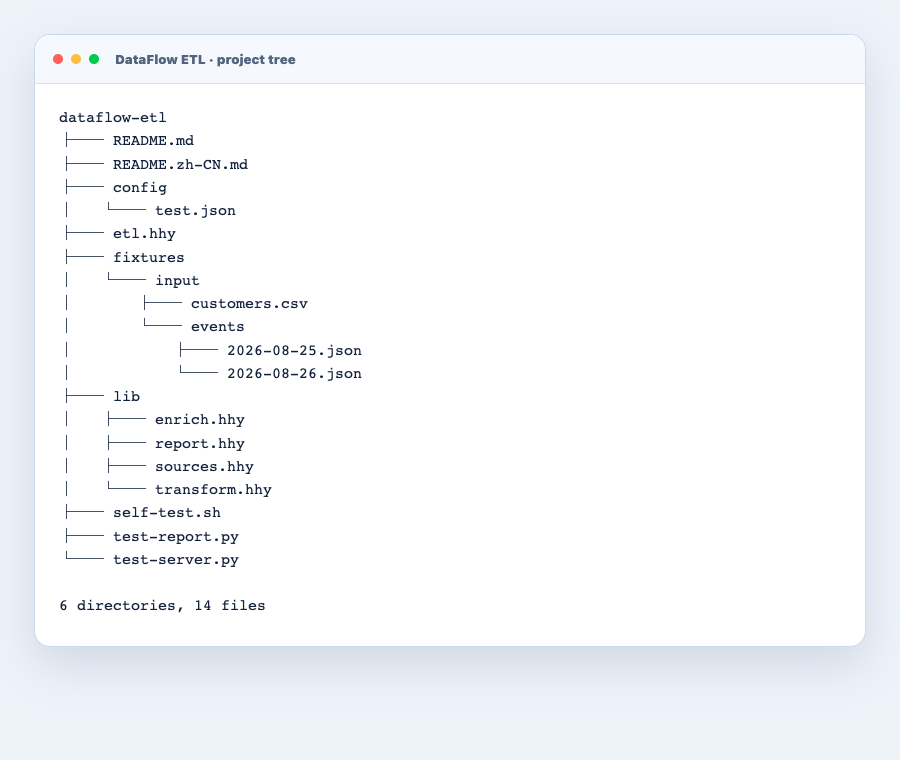
DataFlow ETL 读取客户 CSV 与事件 JSON 目录,统一字段,过滤停用客户,并发请求画像 API,再按最低消费筛选、按部门汇总,最后原子写出 JSON 报告和 CSV 明细。

DataFlow ETL 的真实项目目录

先把不同输入变成明确的数据

客户 CSV 在进入主流程时完成 trim、邮箱小写化、布尔值和整数转换:

export fn load_customers(input_root) {
    return path_join(input_root, "customers.csv")
        |> read_lines
        |> parse_csv({ header: true })
        |> map { row ->
        return {
            id: trim(row.id),
            name: trim(row.name),
            email: lower(trim(row.email)),
            department: trim(row.department),
            active: lower(trim(row.active)) == "true",
            spend: to_int(row.spend)
        }
    }
        |> collect
}

事件则通过 files("*.json") 遍历目录。这里我没有做一个万能 Loader:CSV 和 JSON 的读取方式不同,但它们离开 source 模块时都已经是业务可以理解的 Map。

并发补全,但不丢失失败信息

停用客户没有必要请求远程画像,因此过滤发生在 HTTP 之前。有效客户进入 parallel(4),每个请求带 3 秒超时和一次重试。

let profile = attempt {
    http.get(join([api_base, "profiles", customer.id], "/"))
        |> timeout(3s)
        |> retry({ count: 1, backoff: 50ms })
        |> send
        |> response_body
        |> parse_json
}

补全失败的客户不会消失。结果仍保留原始字段,同时写入 enriched: false 和错误消息。最终报告只有在所有入选客户都补全成功时才 ok=true。这比 silently drop 更诚实,也让重跑和排障有依据。

Stream 负责关系,数组负责边界

最低消费筛选与排序是一条短 Flow:

customers
    |> stream
    |> where { customer -> customer.spend >= minimum_spend }
    |> sort_by({ order: "desc" }) { customer -> customer.spend }
    |> collect

部门统计则用 group_by 后对每组的 spend 求和。我的习惯是在可以惰性处理的阶段保持 Stream,到要并发、复用或写入报告的边界再 collect。这样生命周期一眼可见,也不会让同一条 Stream 被意外消费两次。

双输出不是复制两套逻辑

JSON 报告保存客户、事件、部门汇总和来源统计,适合诊断;CSV 只投影下游需要的七个字段。二者都使用原子写入,旧文件不会在进程中途失败时留下半份新内容。

report |> encode_json({ pretty: true }) |> save_text(report_path, { atomic: true })
customers |> csv_rows |> encode_csv({ header: true }) |> save_lines(csv_path, { atomic: true })

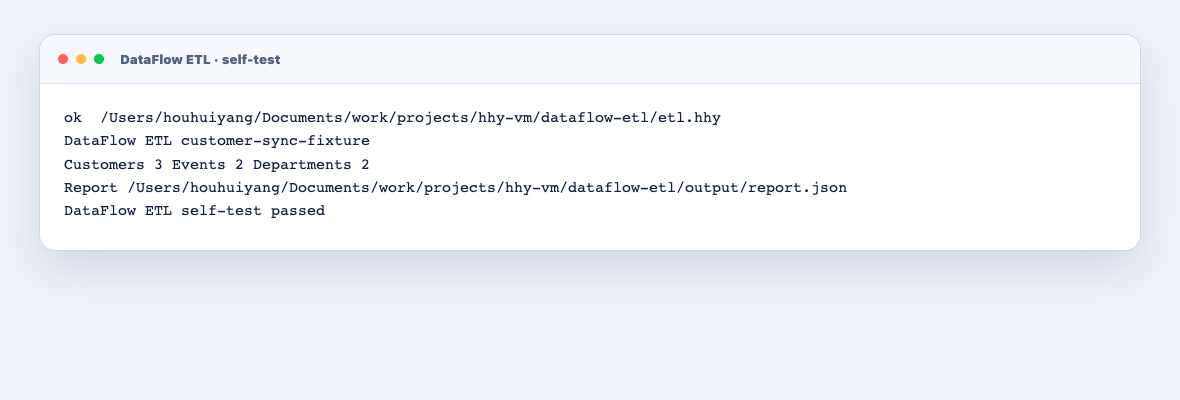
DataFlow ETL 的端到端自测结果

自测固定验证 3 条合格客户、2 个事件文件和 2 个部门汇总,还检查邮箱清洗、消费排序、region/tier 补全以及 JSON/CSV 两份输出。

sh practical-projects/dataflow-etl/self-test.sh

我从这条 Flow 得到的判断

ETL 的复杂度通常不在某个 map,而在边界:什么时候清洗,失败是否保留,远程调用是否受控,输出能否安全替换。

HHY 的价值也在这些边界上。Pipe 让数据方向清楚,Stream 表达筛选与分组,attempt 把失败变成数据,Runtime 则统一超时和原子副作用。最后得到的不是一段“像 SQL 的语法”,而是一条可以运行、失败、解释和重跑的工程管道。

参考

16 / 41

实战 FlowGuard:我用 HHY 写了一个可进 CI 的项目质量门禁

用 HHY 把文件检查、凭据扫描、质量命令、HTTP 健康检查和结构化报告串成一条可验证的 CI/CD Flow。
2026/08/27 · 8 分钟阅读

我一直不太愿意用“能打印 Hello World”证明一门语言已经可用。

对 HHY 这样的系统脚本语言,更有价值的问题是:它能不能接住一个有文件系统、子进程、HTTP、并发、失败隔离、结构化输出和稳定退出码的完整任务?FlowGuard 就是我给出的第一个实战答案。

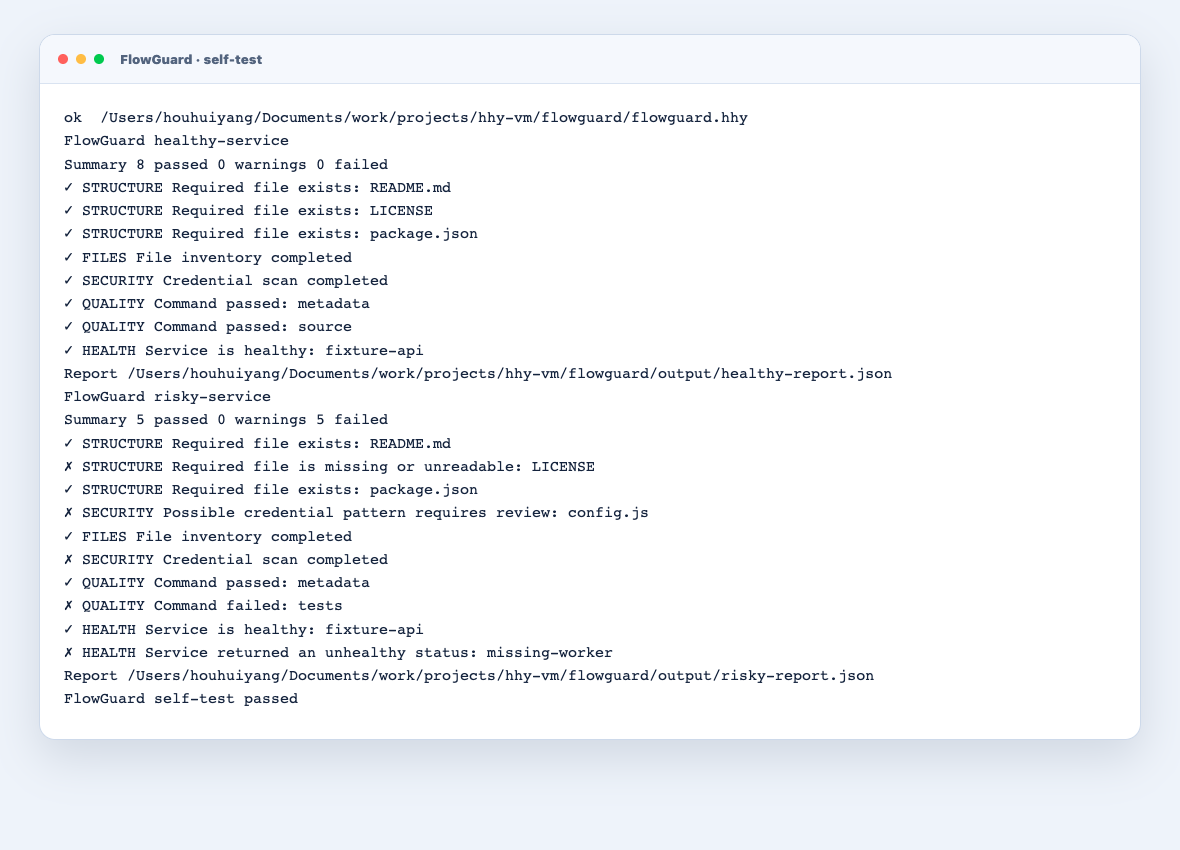
它接收项目目录、JSON 配置和报告路径,检查必需文件,扫描大文件与疑似凭据,并发执行质量命令与服务健康检查,最后原子写入 JSON 报告。没有失败返回 0,有失败返回 1,参数错误返回 3。

质量门禁不是一串命令,而是一条即使局部失败,也必须完整收集事实的工作流。

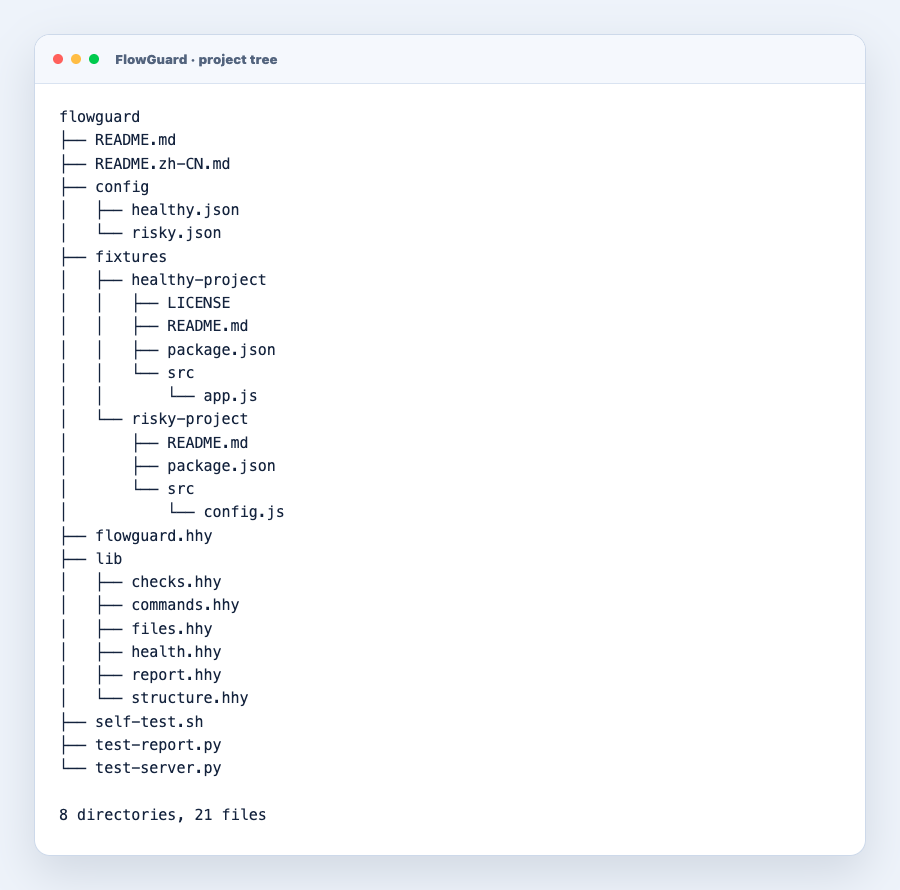
FlowGuard 的真实项目目录

入口只负责编排

flowguard.hhy 没有塞进所有业务细节。结构、文件、命令、HTTP 和报告分别放进六个模块,入口只负责组合:

let structure_checks = inspect_structure(root, config.required_files)
let file_checks = inspect_files(root, config.limits.large_file)
let command_checks = inspect_commands(root, config.commands)
let health_checks = inspect_health(config.health_checks)
let checks = combine([structure_checks, file_checks, command_checks, health_checks])
let report = build_report(config.project.name, args[0], checks)

report
    |> encode_json({ pretty: true })
    |> save_text(output_path, { atomic: true })

这段代码是我希望 HHY 表达出来的形状:输入、变换、副作用和结果边界都清楚。模块不是为了展示语法,而是为了让某一类检查可以独立修改和测试。

attempt 比“一遇错就退出”更重要

门禁最常见的错误,是第一项失败后整个脚本退出。这样 CI 只能告诉你测试失败,却来不及继续检查健康接口、缺失文件和凭据风险。

FlowGuard 把每条外部命令包装进 attempt,将运行错误变成普通数据;HTTP 检查也采用同样方式。失败会形成一条 status: "fail" 的检查记录,而不是终止整份报告。

let execution = attempt {
    run(command.argv, {
        cwd: root,
        timeout: 15s,
        max_output: 1mib
    })
}

命令参数始终以 argv 数组交给 run,不拼接 shell 字符串;每个命令还有 15 秒和 1 MiB 输出上限。这里的重点不是少写几行,而是默认把注入、失控进程和无限输出排除在正常路径之外。

并发需要上限,扫描需要脱敏

质量命令使用 parallel(3),健康检查使用 parallel(4)。这些任务大多在等待进程或网络,有界并发能缩短总时间,又不会让配置里增加十几个服务后瞬间打满资源。

文件扫描会寻找私钥头、DEMO_TOKEN=password= 等模式,但报告只保存文件名与 content_redacted: true。检测工具发现秘密,不代表它有权复制秘密。

Bytes 也直接进入业务逻辑。文件大小不是模糊的数字,配置里的 256b1kib4kib1mib 会被解析成 Bytes 后再比较,避免单位被藏在变量名和约定里。

测试失败场景,才能证明门禁有效

自测准备了两个确定性项目。healthy-project 包含必需文件、成功命令和 2xx 健康接口,八项检查全部通过。risky-project 故意缺少 LICENSE,放入假的 DEMO_TOKEN,执行失败命令并请求 404 接口。

第二个场景返回 1 不是测试失败,而是门禁正确工作。测试脚本随后读取报告,断言五项失败都被记录,敏感内容没有泄露。

FlowGuard 健康与风险场景的端到端自测

sh practical-projects/flowguard/self-test.sh

这个项目验证了什么

FlowGuard 让我确认,HHY 最有辨识度的方向不是替代某一条 shell 命令,而是把文件、进程、HTTP 和 Stream 放进同一套可读的错误与资源模型。

Shell 很适合把几个成功路径连起来;当任务开始要求并发上限、错误聚合、脱敏报告、原子写入和稳定退出码时,脚本已经在长成一个应用。HHY 要做的,就是让这个增长过程仍然保持直接。

参考

17 / 41

实战 HHY Collector Framework:我没有从复刻 Scrapy 开始

用 HHY 的 HTTP、Stream、有界并发与官方 HTML 扩展,构建一个配置可审计、资源有边界的静态文档采集框架。
2026/08/27 · 10 分钟阅读

数据抓取很适合 HHY。

一个采集任务天然包含 Seed、HTTP、重试、超时、并发、解析、标准化、去重、失败记录和持久化。它几乎把 HHY 的 Flow、Stream、Effect 和资源边界一次全部拉进真实场景。

但我不想从“HHY 版 Scrapy”开始。

Scrapy 背后有成熟的 URL 调度、Middleware、Downloader、Item Pipeline、缓存、robots.txt 和扩展生态;Playwright 还要承担浏览器进程、JavaScript、页面生命周期和交互状态。如果第一版同时承诺这些能力,语言 Runtime、扩展协议和框架 API 会一起膨胀,最后很难判断哪一层真的稳定。

所以我把项目定义成:

HHY Collector Framework:面向 API 与静态文档的 Flow-first、配置可审计、资源有边界的数据采集框架。

HHY Collector Framework 的实现架构

第一个边界:它是 Collector,不是浏览器

当前版本适合 JSON API、CSV/JSON 数据集和静态 HTML。它不执行 JavaScript,不处理登录验证码,不绕过 robots.txt、认证和反爬策略,也不承诺无限响应流。

这不是“以后再补”的免责声明,而是架构边界。HHY 的 HTTP Response Body 当前完整缓冲,默认受 max_http_body 限制;parallel(n) 是有界并发并默认保序。对文档页和普通 API,这些行为带来清楚的资源上限。对视频、归档、海量 NDJSON 或浏览器渲染页面,它们就不是正确工具。

动态页面以后可以接外部 Browser Worker。HHY 负责计划、资源、数据和失败,浏览器负责执行页面;没有必要让 Runtime 自己长成浏览器。

HTML DOM 不应该用 Regex 伪装

项目最初缺少的不是 HTTP,而是 HTML 结构。

splitreplace 和 PCRE2 可以处理规则化文本,却不应该承担通用 HTML 抽取。真实页面有容错解析、嵌套、实体、属性和 Selector 语义。为此,我实现了官方 html 进程扩展,底层使用 Lexbor 的 HTML5 Parser 与 CSS Selector。

一个字段抽取配置如下:

{
  "root_selector": "section.card",
  "max_results": 10,
  "schema": {
    "title": {
      "selector": "h2",
      "value": "text",
      "required": true
    },
    "anchor": {
      "selector": "h2",
      "value": "attr",
      "name": "id"
    }
  }
}

Engine 一次把 HTML、根 Selector、Schema 和结果上限交给扩展:

html.extract(
    fetched.value,
    root_selector,
    schema,
    { max_results: max_results }
)

扩展返回普通 List<Map>,随后继续进入 HHY Stream。

这个 API 是一个有意的取舍。Process Extension Protocol 只能传 Null、Bool、数字、String、List 和 Map,不能传 Opaque DOM Handle 或 Stream。如果模仿浏览器 DOM,写成 parse → node handle → select → text,就必须先扩大协议与对象生命周期。

第一版直接用“HTML + Selector + Schema → List<Map>”,把 DOM 留在扩展进程内部。它牺牲了一部分任意遍历能力,却换来简单的所有权、明确的序列化边界和可以立即验证的业务 API。等真实项目证明需要 Node 逻辑值,再讨论它是否应进入 Core。

Engine 只有一条主路径

crawler.hhy 负责参数、配置、统计和三个原子输出。真正的执行逻辑在 lib/engine.hhy

export fn crawl(config) {
    let user_agent = config.user_agent
    let root_selector = config.root_selector
    let schema = config.schema
    let max_results = config.max_results

    return config.seeds
        |> stream
        |> distinct
        |> parallel(config.parallelism) { url ->
        crawl_seed(url, user_agent, root_selector, schema, max_results)
    }
        |> collect
}

Seed 先去重,再进入配置指定的有界并发。HTTP 请求使用可识别的 User-Agent、10 秒 timeout、两次 retry 和 500 ms backoff。这里没有无限 Worker,也没有隐藏的全局线程池。

单个 Seed 有两个 attempt 边界:一个包住 Fetch,一个包住 HTML Extract。

单个 Seed 从请求到输出的执行 Flow

let fetched = attempt { fetch_page(url, user_agent) }
if fetched.ok != true {
    return { ok: false, url: url, records: [], error: fetched.error.message }
}

let parsed = attempt {
    html.extract(fetched.value, root_selector, schema, { max_results: max_results })
}
if parsed.ok != true {
    return { ok: false, url: url, records: [], error: parsed.error.message }
}

网络失败和 Selector/Schema 失败都变成普通结果,不会让同批其他 Seed 丢失。成功记录还会统一加入 source_url,因为采集数据如果不能回到来源,就很难审计、更新和纠错。

三份输出承担三种责任

程序最终写出:

  • records.json:抽取后的结构化记录;
  • report.json:请求页数、成功页数、失败页数与记录数;
  • failures.json:失败 URL 和结构化错误。

三份文件都使用 atomic: true。部分成功时,成功记录仍然有价值,失败页也不会藏在 stderr 里;但报告 ok=false,进程返回 1,让自动化系统知道这不是完整成功。

这种设计比“第一次错误立即退出”更适合采集,也比“无论如何都返回 0”更诚实。

配置是 Spider 的第一版语言

默认任务抓取 https://hhylang.dev/zh/learn/cli-reference,用 main article h2 抽取二级标题及 id

{
  "project": "HHY Documentation Crawler",
  "seeds": ["https://hhylang.dev/zh/learn/cli-reference"],
  "parallelism": 2,
  "user_agent": "HHY-Collector/1.0 (+https://hhylang.dev)",
  "root_selector": "main article h2",
  "max_results": 100,
  "schema": {
    "title": { "selector": "", "value": "text" },
    "anchor": { "selector": "", "value": "attr", "name": "id" }
  }
}

空 selector 表示字段直接读取当前根节点。字段支持 texthtmlattr,也可以声明 allmax_results 同时在配置和扩展边界出现,避免错误 Selector 把整页成千上万个节点带回 Runtime。

目前 Spider 是纯数据定义。我刻意没有让配置引用 HHY 函数,因为 JSON 不能可靠表达可执行闭包。等分页、follow request 与 normalize hook 进入框架时,它们更适合由 .hhy Spider 模块导出,而不是把代码字符串塞进 JSON。

扩展安装必须是项目局部的

init.sh 把官方 html 扩展安装到项目自己的 .hhy-extensions,重复运行安全,也不污染用户级 Extension Home。

make
./practical-projects/my-crawler/init.sh
./practical-projects/my-crawler/run.sh

运行时显式设置 HHY_EXTENSION_HOME。这让项目携带自己的扩展版本与配置,避免“我的机器上全局装过,所以可以运行”的隐式依赖。

自测不应该依赖公网

真实任务用于证明 HHY 能访问真实文档,自测则只验证代码契约。

self-test.sh 启动本机 fixture server,动态生成配置,选择两个 section.card,断言结果标题是 First itemSecond item,Anchor 是 onetwo,每条记录都有本地 source_url,报告记录数为 2,失败列表为空。

./practical-projects/my-crawler/self-test.sh

外部页面改版不应该让框架回归测试变红;反过来,本地 fixture 通过也不能证明真实站点 Selector 仍然有效。真实 Smoke Test 与确定性测试承担不同责任。

它还不是我最初设想的完整框架

当前实现已经证明“Seed → Fetch → Extract → Provenance → Output”这条最小闭环,但它还没有:

  • 分页策略和 Follow Request;
  • URL 标准化与相对 URL 解析;
  • 域名级限速和 robots.txt;
  • 请求指纹与已访问集合;
  • 增量 Checkpoint 和失败重放;
  • 条件请求、缓存与内容哈希;
  • JSON/CSV/数据库多 Storage Adapter;
  • parallel(..., { ordered: false }) 这样的非保序完成流。

大部分能力可以继续用 HHY 编写,不需要立刻修改 Runtime。优先级应该由真实 Spider 驱动。我会先增加分页、请求身份、Checkpoint 和域名 Admission,再观察保序并发是否真的成为吞吐瓶颈。

这次实现让我更确信的事

框架的价值不在于拥有最多的概念,而在于把失败、资源和副作用放在可以看见的位置。

HHY Collector Framework 现在只有一个 Engine、一个声明式 Schema 和一个 HTML 扩展,但每个请求有超时,每批并发有上限,每次抽取有结果上限,每条数据有来源,每次运行有失败审计,每份文件是原子输出。

这些边界比先拥有几十个 Middleware 名字更重要。

我没有从复刻 Scrapy 开始,因为 HHY 不需要靠模仿另一个生态证明自己。它更应该先证明:一条采集 Flow 可以足够直接,同时在网络、解析和文件副作用面前仍然可信。

参考

18 / 41

不换 Bytecode,我如何优化 HHY 的 AST 解释器

复盘 HHY Language v1.1.1 的解释器优化:Resolver、静态 Slot、轻量调用帧、标识符缓存与逃逸安全复用,如何在不改变语言语义的前提下降低函数调用成本。
2026/08/27 · 12 分钟阅读

HHY Language v1.1.1 仍然是一台 AST Interpreter。

源码经过 Lexer、Parser 和 Checker 后,Runtime 直接遍历 AST 执行。它没有先降低成 Bytecode,也没有 JIT。对一门系统脚本语言来说,这条路径足够直接:源码位置容易保留,错误容易解释,语义改动也不需要同时维护另一套指令系统。

但“直接”不等于“每次都从头查找”。当递归、闭包和高频函数调用进入真实负载后,最先暴露的成本不是 Parser,而是 Runtime 在一遍遍回答相同的问题:这个名字属于哪一层作用域?参数放在哪里?一次调用是否必须分配新的环境对象?调用结束后,这个 Frame 还能不能安全复用?

这次优化的目标很克制:

保留 AST Interpreter,先消除执行路径里可以提前确定、可以直接寻址、可以安全复用的工作。

HHY AST 解释器优化后的执行路径

先用 Profile 找问题,而不是先重写 Runtime

解释器优化很容易从一个漂亮方案开始:设计 Opcode、写 Compiler、实现 VM,再希望性能自然变好。但 Bytecode 不是免费的抽象。它会带来新的中间表示、跳转规则、调试映射、错误栈、闭包捕获和兼容测试。

我更愿意先问一个简单问题:当前成本到底在哪里?

HHY v1.1.1 提供了内置 Profile:

hhy profile examples/09-profile-algorithms.hhy -- fibonacci 20
hhy profile --cpu examples/09-profile-algorithms.hhy fibonacci 20
hhy profile --heap --format json --output profile.json \
  examples/09-profile-algorithms.hhy fibonacci 20

profile 会真实执行脚本。CPU 报告记录采样和调用次数,Heap 报告记录托管内存的累计分配、对象数量、峰值与 GC 后占用。报告默认写到 stderr,脚本自己的 stdout 不会被污染,退出码也保持原样。

诊断基线也把问题量化了。朴素递归 Fibonacci(30) 会进入 HHY 函数 2,692,537 次。早期路径累计产生 32,310,598 次分配和约 1.98 GB 分配流量;这不是 Heap 同时占用了 1.98 GB,而是几百万次调用制造并很快丢弃了大量短命对象。

这套数据让我把调用问题拆成两类:

  1. 名称解析和环境查找在高频调用中被重复执行;
  2. 每次函数调用都构造完整环境,会产生不必要的对象和初始化成本。

这两类问题都不要求立刻引入 Bytecode。它们首先要求 Runtime 不要忘记语言前端已经知道的事实。

优化完成后,在相同 Fibonacci(30)、预热 3 次、固定随机顺序交错执行 20 次的测试里,HHY 中位数从 681.27 ms 降到 200.79 ms,累计提升约 3.39 倍。更重要的是 Profile 中算法和 2,692,537 次函数调用都没有变化:

指标优化前阶段Slot Frame变化
HHY 中位数681.27 ms200.79 ms约 3.39×
Profile 分配次数4,038,9471,346,440-66.7%
Profile 累计分配328.7 MiB61.6 MiB-81.3%
Heap 峰值2.1 MiB2.1 MiB基本不变

Fibonacci 不是 HHY 的目标负载,但它适合放大函数调用成本。这个结果证明快路径减少了通用 Runtime 工作,并不代表文件、HTTP 或进程型 Flow 会得到同等比例的端到端加速。

Resolve Pass:把重复判断移到执行之前

最初的解释器面对一个 Identifier 节点,只知道它有一个名字。执行到 total 时,Runtime 从当前环境开始逐层查找,直到找到绑定,或者继续查到全局与 builtin。

这在语义上正确,但在循环和递归里很浪费。相同 AST 节点的词法归属通常不会因为第 10000 次执行而改变。

v1.1.1 增加了预解析阶段。函数执行前,Resolver 遍历 AST,并尽可能把名称分类:

  • 参数绑定到当前函数的 Slot;
  • 确定的局部变量绑定到 Slot;
  • 跨函数边界的闭包捕获、全局名称和 builtin 保留 Env 路径;
  • 含动态 import 的作用域不强行固定布局;
  • 不能直接 Slot 化的 Identifier 记录可复用的查找信息。

这里的关键不是“缓存字符串”,而是把词法作用域中稳定的关系变成执行期可以直接使用的元数据。

Identifier("total")
  before: lookup(env, "total")
  after:  slots[3]

Parser 仍然只负责结构,Checker 仍然负责语义约束,Resolver 则把已经确定的作用域事实翻译成 Runtime 的快速寻址信息。三者职责没有混在一起。

Slot:局部变量不必每次按名字查找

确定的参数和局部变量进入 slots[] 后,读取路径从“按名字遍历环境”变成“按索引读取数组”。

Local / Param       → slots[index]
Closure / Global    → Env lookup
Builtin             → Env lookup

我没有把所有名称都强行压进 Slot。闭包捕获会跨越函数生命周期,全局变量属于共享命名空间,builtin 还涉及运行时注册。对这些情况保留 Env 慢路径,语义更清楚,也避免为追求统一而制造复杂的失效规则。

这是一条我很认同的优化原则:快路径服务常见且可证明的情况,慢路径负责完整语义。 两条路径不是妥协,而是职责分工。

HHY 标识符的 Slot 快路径与 Env 兼容路径

Lightweight CallFrame:调用不再等于完整环境

Slot 解决了“值放在哪里”,下一步是“每次调用需要创建什么”。

函数调用真正需要的核心状态并不多:当前函数、参数与局部 Slot、必要的父级或捕获环境,以及返回和错误传播所需的信息。为每次调用构造一套通用 Map/Env,不仅查找更慢,也会制造更多托管分配。

因此我把高频调用路径收敛成 Lightweight CallFrame。实现上它没有另造一套与 Env 平行的对象模型,而是让 Env 同时具备连续 Binding 容量、escaped 标记和空闲链指针:

CallFrame
├── function
├── slots[]
├── parent / captured env
└── runtime state

函数调用根据 Resolver 计算的 frame_slot_count 一次准备连续容量。参数在进入函数时按顺序写入,局部绑定随后落在稳定 Slot;函数体 Block 直接使用调用 Frame,不再额外创建一个只有父指针的 Block Env。只有遇到闭包、全局或动态路径时,查找才沿兼容的 Env 链继续。

这并不是把动态语言偷偷改成静态语言。HHY 的值仍然是动态的,变化的是绑定位置:值的类型可以在运行时决定,但一个确定的局部名称不必在每次读取时重新寻找地址。

Identifier Cache:慢路径也不必永远从零开始

不能 Slot 化不代表只能接受最慢路径。

对于仍需 Env lookup 的 Identifier,Runtime 会在 AST 节点上缓存 cached_env_depthcached_binding_slot。下一次执行时先按深度和 Slot 定位,然后再次比较名称长度与内容;只有验证通过才命中。环境形状不符合预期时,缓存立即失效,Runtime 退回完整查找并重新绑定。

缓存必须附着在语义稳定的对象上,也必须有明确的失效条件。把一个进程级“名字到地址”Map 当万能缓存,会在递归、模块与闭包之间制造错误共享。HHY 的缓存面向 AST 节点和对应作用域关系,而不是仅仅面向字符串。

性能优化最危险的结果不是“没有变快”,而是“在大部分输入上更快,但偶尔读到错误绑定”。因此,缓存命中永远不能绕过作用域语义。

Frame Pool:复用之前先回答是否逃逸

轻量 Frame 仍然需要初始化。如果一个函数被高频调用,调用结束后立刻丢弃 Frame,再等待 GC 回收,仍然会形成分配压力。

最自然的下一步是 Pool,但 Frame 复用不能只看“函数已经 return”。闭包或 Stream 可能保存了当前环境;从函数调用栈看它已经结束,从对象生命周期看它仍然活着。如果此时 reset 并交给下一次调用,旧闭包看到的变量就会被新调用覆盖。

所以 HHY 的 Frame Pool 有一条硬边界:

未逃逸 Frame  → reset → pool → reuse
已被闭包捕获  → mark escaped → 不复用 → 交给 GC
已被 Stream 捕获 → mark escaped → 不复用 → 交给 GC

这也是为什么我把它称为“逃逸安全复用”,而不是简单对象池。Pool 只是机制,逃逸判定才是正确性。

优化过程中不能改变什么

解释器优化的验收标准不是 benchmark 能跑多快,而是语言承诺没有被悄悄改变。

至少要守住这些边界:

  • 错误仍然指向原始源码位置,而不是优化后的内部结构;
  • 闭包捕获的值和生命周期保持不变;
  • 局部、模块、全局与 builtin 的遮蔽顺序保持不变;
  • Stream 的惰性、单次消费和取消传播保持不变;
  • hhy checkhhy ast--dry-run 与真实运行看到同一套语义;
  • 资源限制、退出码和异常清理路径不能被快路径绕过。

因此这类改动需要的不只是性能样例,还需要递归、深层作用域、同名遮蔽、闭包逃逸、Stream 捕获、错误栈和 GC 后存活对象等回归测试。新增的 frame-slots-escape.hhy 同时创建两个计数器闭包,并在外层函数返回后分别修改捕获的可变 Slot;它还返回一个捕获局部变量的惰性 Stream,延迟到函数返回后才 collect。实际输出 1112101[8, 9, 10],证明两个 Frame 没有被错误复用,Stream 也没有读到已经清空的状态。

Release 全量测试、ASan/UBSan 全量测试和 Multi-API Data Collector 自测也需要一起通过。优化器必须证明自己可以被拿掉而不改变程序结果。

为什么现在还不上 Bytecode VM

Bytecode VM 仍然是 HHY 的可能方向,但它应该由数据触发,而不是由路线图的想象触发。

Resolver、Slot、Lightweight Frame 和安全复用解决后,如果 Profile 继续显示 AST dispatch 是主要剩余热点,而且这个热点在真实 Flow、模块和系统调用负载中足够重要,那么 Bytecode 才有明确收益。到那时,现有 Resolver 也不会浪费:它已经把名称、Slot 与闭包边界整理成更适合 lowering 的信息。

反过来,如果脚本主要时间花在文件、HTTP、进程和 Stream 上,那么把 AST dispatch 再压缩一半,端到端体验也可能没有明显变化。系统脚本语言的优化不能只盯着 Fibonacci。

我现在更愿意把演进顺序写成:

Profile
  → eliminate repeated semantic work
  → direct-address stable bindings
  → reduce call-frame allocation
  → reuse only non-escaping state
  → profile again
  → consider Bytecode when AST dispatch becomes the bottleneck

这次优化带给我的判断

做解释器性能优化后,我更确信:性能问题经常不是“抽象太多”,而是系统没有消费自己已经知道的事实。

Checker 已经知道局部变量属于哪个作用域,Runtime 就不该每次重新猜;一次调用没有逃逸,Frame 就不必交给 GC 走完整生命周期;一个 Identifier 的环境位置稳定,慢路径也不必永远从根开始。

真正有效的优化不是跳过语义,而是把语义证明转化为更短的执行路径。

HHY v1.1.1 仍然直接执行 AST。这不是因为 Bytecode 不重要,而是因为当前更值得做的事情,是先让 AST Interpreter 少做重复工作,同时保持源码诊断、闭包、Stream 和资源边界完全可信。

参考

19 / 41

实战香港电影公司:用 HHY 做一次可复现的维基百科研究

用 MediaWiki API 搜索候选页面、并发抓取详情、做语义筛选,并把动态网络结果与确定性回归测试分开。
2026/08/27 · 7 分钟阅读

“抓取香港电影公司”听起来像一个很小的爬虫题目,但真正动手后,问题很快从 HTTP 变成了研究方法:搜索结果是不是公司?外部数据变化后测试怎么办?失败页面要不要拖垮整批任务?输出如何保留来源?

这个项目使用维基百科官方 MediaWiki API。先按“香港電影公司”搜索候选页面,再并发获取 page ID、正式 URL、更新时间和首段简介,筛选公司语义,最后原子写入 CSV 和 JSON。

香港电影公司项目的真实目录

搜索与详情是两个阶段

搜索接口适合发现候选,不适合直接当最终数据。程序先获取 query.search,按 pageid 去重,再用 parallel(parallelism) 请求详情。

return search_results
    |> stream
    |> group_by { result -> result.pageid }
    |> map { group -> group.values[0] }
    |> parallel(parallelism) { result ->
        let detail = attempt { /* MediaWiki detail request */ }
        // return success or structured failure
    }
    |> collect

每个请求有 10 秒 timeout、两次 retry 和 250 ms backoff。attempt 隔离单页失败,因此第七页超时不会抹掉前六页已经取得的数据。

详情请求把简介限制为 600 字符。这不是为了省几个字节,而是给 worker 返回值建立边界。并发任务如果可以无上限携带外部响应,吞吐很容易变成内存问题。

筛选承认它只是启发式

最终规则要求简介同时包含“香港”、“電影/电影”和“公司”,随后按标题排序:

pages
    |> stream
    |> where { page -> page.fetched }
    |> where { page ->
        contains(page.summary, "香港") and
        (contains(page.summary, "電影") or contains(page.summary, "电影")) and
        contains(page.summary, "公司")
    }
    |> sort_by { page -> page.title }
    |> collect

这个规则可解释、可测试,但不是公司注册数据库。2026-08-26 的真实运行从 10 个候选中保留 7 条,包括公司页面和“香港電影公司列表”。我选择在文章和数据里明确这个边界,而不是把搜索结果包装成权威名录。

HHY 真实联网抓取维基百科的运行结果

CSV 保留 wikipedia_url、page ID、更新时间与简介,读者可以回到来源核验。公开再发布简介时,也应遵循对应页面的许可和署名要求。

动态数据与回归测试必须分开

真实 Wikipedia 结果会变化,网络也会抖动。如果测试直接断言今天仍然是七家公司,它测到的更可能是互联网,而不是代码。

因此 self-test.sh 启动本地模拟 MediaWiki API:固定 5 个候选,经相同的去重、并发请求与语义筛选后必须得到 3 家公司。测试检查 CSV 字段、顺序、URL 和 JSON 统计。

sh practical-projects/hong-kong-film-companies/self-test.sh

真实运行负责回答“现在能查到什么”,fixture 负责回答“程序是否仍按约定工作”。两者都重要,但不能混成同一种证据。

一个兼容性细节

配置中的中文搜索词预先做了百分号编码,因为 HHY 1.1.1 对非 ASCII query Map 值还有编码限制;详情请求的 ASCII 参数仍由 query Map 构造。我更愿意把这个限制写进项目,而不是用一段看似聪明的隐式修复藏起来。

这也是实战项目的意义:它会迫使语言面对真实 API、真实字符和真实失败,最终让路线图不再只是功能清单。

参考

20 / 41

从 Flow 哲学到 C Runtime:我如何从零实现 HHY Language

复盘 HHY Language v1.0 的完整开发过程:为什么以数据流为核心,Lexer、Parser、AST、语义检查与 Runtime 如何协作,以及一门语言怎样通过资源边界、测试和规范真正成为可用的工程系统。
2026/08/25 · 18 分钟阅读

过去一段时间,我用 C 从零实现了一门系统脚本语言:HHY Language

它不是把几条 Shell 命令换一种写法,也不是给自然语言套一层执行器。HHY 有自己的 Token、Grammar、AST、作用域、语义检查、运行时值模型、惰性 Stream、结构化错误和资源限制。源码从进入 Lexer 开始,到最终打开文件、启动进程或发送 HTTP 请求,每一步都有确定行为。

HHY Language Logo

HHY 的定位很简单:

Pipe Everything. 让文件、进程、网络和结构化数据进入同一种 Flow。

path("./logs")
    |> files("**/*.log")
    |> flat_map { file -> read_lines(file.path) }
    |> where { line -> contains(line, "ERROR") }
    |> take(100)
    |> save_lines(path("errors.txt"))

这篇文章不只介绍语法。我更想复盘一门语言从想法走向 v1.0 时,哪些技术真正重要,以及我做过哪些有意识的取舍。

我为什么还要做一门语言

系统自动化并不缺工具。Shell 适合连接进程,Python 适合写完整程序,jqawkcurl 又各自解决一类问题。问题是,当任务同时涉及目录遍历、文本流、JSON、HTTP、并发和错误处理时,思维会在多套模型之间切换。

我想验证的是:能否把这些对象统一成数据源、变换和动作,让程序主要描述“数据如何流动”,而不是“每一步如何调度”。

source |> transform |> filter |> action

因此,|> 在 HHY 里不是为了好看。它是语言、标准库和 Runtime 共同遵守的组合边界:

x |> f           => f(x)
x |> f(a, b)     => f(x, a, b)
x |> obj.f(a)    => obj.f(x, a)

一旦这条规则稳定,文件、进程、HTTP 请求和普通集合就可以使用同一种表达方式。语言哲学只有进入可执行语义,才不只是品牌文案。

先冻结语义,再扩展功能

造语言最容易陷入的误区,是不断增加关键字和标准库函数。真正困难的是回答那些不显眼的问题:换行什么时候结束语句?/ 是除法还是正则?Map 和代码块都使用 {} 时如何消歧?管道是否自动展开 Stream?并发是否保序?错误发生后,上游资源由谁关闭?

我最终把 docs/HHY_V1.md 设为唯一规范来源。v1.0 先冻结一组基础决策:动态类型、变量默认不可变、显式闭包、普通调用统一使用括号、Stream 默认惰性且单次消费、普通错误 fail-fast、HTTP 构造请求后由 send 产生副作用、parallel 有界并发并默认保序。

这个顺序很重要:规范不是代码完成后的说明,而是代码修改的前置约束。 如果实验实现与规范冲突,先决定要不要改变语言,再修改规范和测试,最后改代码。

一段源码如何变成可执行行为

HHY 当前采用直接解释执行,但它仍然拥有一条完整的语言前端:

UTF-8 Source
  → Lexer / Token
  → Parser / AST
  → Checker / Scope & Contract
  → Runtime / Value & Environment
  → Stream / System Effect

每一层只解决自己的问题。Lexer 不判断变量是否存在;Parser 不打开文件;Checker 不执行 HTTP;Runtime 不重新猜运算符优先级。边界越清楚,错误越容易定位,语言也越容易演进。

Lexer:先把字符变成带位置的事实

Lexer 的工作是把 UTF-8 源码切分成 Token。HHY 的每个 Token 都保留类型、原始切片、行号和列号。这些位置信息不是调试附属品,而是后续 Parser、Checker 和 Runtime 能给出可用错误的基础。

词法层需要处理不少上下文。例如 /ERROR/itotal / count 都包含 /。HHY 根据当前位置是否允许结束一个表达式判断它是正则起点还是除法运算符。10mib500ms80% 也在 Lexer 中成为 Bytes、Duration 和 Percent,而不是先读成字符串再交给库函数猜测。

我还在 Lexer 入口验证 UTF-8,严格限制字符串转义,并让换行成为明确 Token。因为 HHY 允许跨行管道,换行是否结束语句不能靠简单地丢弃空白来决定。

最佳实践是:Token 必须保存足够多的源码事实,但不要提前承担语义。 如果 Lexer 开始理解作用域或函数签名,后面的层次就会失去清晰边界。

Parser:把优先级和上下文写进结构

Parser 使用递归下降解析表达式,并按照优先级逐层构造节点:后缀调用与成员访问、单目运算、乘除、加减、比较、逻辑、空值合并、管道与赋值。

递归下降的价值不是“实现简单”,而是每条语法规则都能对应一段可读代码。Map 与 Block 都使用 {},但它们出现的语法位置不同;闭包也由调用阶段的上下文识别。与其在 Lexer 中发明三种左花括号,不如让 Parser 在已经知道当前规则的地方做决定。

Parser 还必须面对错误恢复。遇到缺失表达式后如果立即退出,用户一次只能修一个错误;如果盲目继续,又会产生大量级联报错。HHY 在声明、控制流、换行和分号等安全边界进行同步,让一次 hhy check 能报告多个真实问题,同时避免把后续合法代码误解成当前表达式。

AST 为什么重要

AST(抽象语法树)是源码表面形式与执行语义之间最关键的中间表示。它去掉无关标点,却保留程序真正的结构。

例如:

processes
    |> where { process -> process.memory > 1gb }
    |> take(10)
    |> print

会形成近似这样的结构:

Pipe
├── Pipe
│   ├── Pipe
│   │   ├── Identifier "processes"
│   │   └── Call "where"
│   │       └── Closure
│   │           └── Binary ">"
│   └── Call "take"
│       └── Literal "10"
└── Identifier "print"

HHY 的 AST 节点包含 kind、来源 Token 和子节点。节点类型覆盖声明、控制流、调用、成员访问、闭包、Pipe、List、Map 和 Literal。来源 Token 会一直保留到 Runtime,因此运行时错误也能指回用户写下的具体位置。

AST 的价值至少有四个:

  1. Parser 只负责“这段代码是什么结构”;
  2. Checker 可以在不执行副作用的情况下遍历程序;
  3. Runtime 面向稳定节点执行,不必重复解析文本;
  4. hhy ast、Formatter、测试快照和未来的优化器可以共享同一表示。

好的 AST 不应该机械复制所有标点,也不应过早降低成只适合某一种 Runtime 的指令。它要足够抽象,同时保留诊断与工具链需要的源码关联。

Checker:动态语言也需要执行前的确定性

HHY 是动态类型语言,但“动态”不等于所有错误都等到执行时发生。Checker 在运行前处理可以静态确认的规则:未定义名称、同一作用域重复绑定、不可变变量赋值、函数参数数量、函数外 return、循环外 break、模块循环依赖和不存在的导出。

Checker 还承担并发边界。parallel 的闭包不能捕获可变绑定或单次消费 Stream,因为这些值不能安全地跨 Worker 共享。把这类问题放到执行前,比在线程已经启动后产生数据竞争更可靠。

标准库函数并不是只注册一个 C 函数指针。HHY 为每个 callable 保存 contract:参数数量、副作用类型、是否惰性、是否支持取消、值能否跨线程发送、输入输出约束和执行线程。这份 contract 同时服务 Checker、Runtime、--dry-run 执行计划和未来扩展协议。

这里的原则是:能在执行副作用之前证明的问题,就不要留给 Runtime。

Runtime:语言真正开始承担后果的地方

Runtime 负责值、环境、函数调用、错误传播和系统资源。HHY 的值不仅有 Null、Bool、Int、Float、String、List 和 Map,还包括 Regex、Bytes、Duration、Percent、Path、File、Process、HttpRequest、DateTime、Function 与 Stream。

Pipe 节点执行时,Runtime 先求左值,再把它注入右侧 callable。这个实现保持了语法规则与运行规则的一致,而不是为每个标准库算子写特殊语法。

系统脚本语言最重要的不是算出 1 + 1,而是如何处理后果:文件是否关闭、进程超时后是否回收、HTTP 是否验证 TLS、取消能否沿 Stream 传播、部分写入失败后会不会留下损坏文件。

HHY 的语言堆使用受限的保守追踪 GC,但文件、进程和网络句柄显式关闭。GC 解决“语言对象何时不可达”,不能替代“操作系统资源何时必须释放”。这两类生命周期如果混在一起,短脚本可能看不出问题,长 Flow 和失败路径一定会暴露。

Stream:惰性不是性能开关,而是执行协议

HHY 的 Stream 是拉取式、惰性、单次消费的。wheremaptake 不会立即把全部输入装进内存,而是等下游请求下一项时逐级拉取。

sink.next()
  → take.next()
  → where.next()
  → files.next()
  → one value returns downstream

这带来三个直接结果:大文件和目录不必一次加载;take(10) 可以让上游提前停止;取消和错误能够沿链路关闭资源。

但惰性也需要明确边界。sort_bygroup_by 和某些 reduce 必须形成屏障并缓存输入,因此 Runtime 会受到内存和记录数量限制。parallel 也不是无限创建线程:它有最大并发、有限缓冲、保序输出、fail-fast 和取消清理。

我越来越认同一个判断:并发 API 的关键不是如何开始,而是如何停止。 早停、错误、Ctrl-C 和超时路径如果没有统一 unwind,正常路径跑得再快也不算可靠。

显式副作用与安全默认值

HHY 把“描述动作”和“执行动作”尽量分开:http.get 构造 HttpRequest,send 才访问网络;run 接收参数数组且默认不经过 Shell,只有显式 shell 才启用 Shell 语义;文件保存优先使用原子写入;Runtime 对内存、打开文件数、进程数、并行度、HTTP Body、正则步骤、递归深度和总运行时间设置上限。

hhy run --dry-run 会输出脱敏执行计划而不执行外部副作用。它依赖的正是 AST 和 callable contract,而不是字符串搜索。只有语言从一开始就对副作用建模,这种能力才可能可信。

测试一门语言,不能只测正确输入

语言实现最危险的部分往往在失败路径。因此 HHY 的测试不只包含“能够运行”的示例,还包含:

  • Token 与 AST 的逐字快照;
  • Parser 多错误恢复和无效字符串转义;
  • Checker 的作用域、参数数量、模块与并发捕获错误;
  • Runtime 的整数溢出、资源回收、取消、超时和结构化错误;
  • 文件、进程、HTTP、JSON、CSV、Watch 与并发的验收脚本;
  • ASan、UBSan 与 coverage-guided fuzzing;
  • macOS arm64、Linux arm64 和 Linux x86_64 原生 CI;
  • README 与规范中 HHY 代码块的 Parser + Checker 验证;
  • 发行包内容、依赖声明和 SHA-256 校验。

“文档可执行”是我认为非常重要的一条实践。示例如果不进入 CI,随着语言演进,它迟早会变成看起来合理、实际上已经不能运行的旧语法。

我刻意没有做什么

v1.0 没有 JIT,没有静态类型系统,也没有开放 Native ABI。第三方扩展边界已经预留,但 Runtime 不在首个稳定版里加载未知扩展。

这些不是遗漏,而是范围控制。一门语言的可信度来自少量承诺被完整实现,而不是功能列表足够长。直接解释执行让我先把语义、错误、资源和跨平台行为做实;动态类型符合系统脚本的反馈速度;不冻结 Native ABI 则避免内部结构还在演进时背上长期兼容债务。

这次造语言带给我的判断

实现一门语言让我重新理解“抽象”的含义。抽象不是给代码换一个更漂亮的名字,而是建立一组跨层一致的约束。

|> 只有在 Parser 能正确结合、AST 能准确表达、Checker 能验证 callable、Runtime 能传播取消、标准库能遵守惰性协议时,才真正成为 Flow-first。否则它只是一枚运算符。

AST 很重要,但 AST 不是终点;Parser 很重要,但能解析不代表能可靠执行;Runtime 很重要,但没有规范和测试的 Runtime 只是当前实现的偶然行为。

我最终把一门可用语言理解为:

语言 = 语法 + 语义 + 执行模型 + 副作用边界 + 诊断 + 工具链 + 兼容承诺

HHY v1.0 还很年轻,但它已经能用同一种 Flow 思维处理文件、进程、网络与结构化数据,并且能够解释自己将做什么、在哪里失败、如何停止和怎样释放资源。这比“又发明了一种语法”更接近我真正想完成的事情。

项目

21 / 41

为什么我在大模型前加了一层 OCR:图片理解不是把文件直接丢给模型

基于 Shixiseng OCR Service 的真实实现,拆解图片与扫描 PDF 如何经过安全检查、栅格化、OCR、结构化与异步调度,再以更稳定、可追踪的文本上下文交给大模型。
2026/08/24 · 17 分钟阅读

我做 Shixiseng OCR Service,不是因为大模型“看不懂图片”,而是因为在真实业务里,能看懂一次能够稳定、低成本、可追踪地处理成千上万份文档,是两件完全不同的事。

招聘场景里经常出现简历截图、证书照片、聊天记录、扫描 PDF、倾斜拍摄的表格。最直接的方案,是把原图交给多模态大模型,然后让它提取姓名、学校、公司、时间和项目经历。Demo 往往很好看,但到了生产环境,问题会很快暴露:同一张图重复调用可能得到不同结构;页面方向、清晰度和文件大小影响结果;长 PDF 成本高、耗时长;识别错了以后,很难判断错在视觉读取、上下文组织,还是模型推理。

所以我的选择是在大模型前加一层独立 OCR。它不是为了替代大模型,而是把“看清楚字”和“理解这些字”拆开:OCR 负责稳定地产生文本、页码、坐标与置信度,大模型负责归一化、推理和业务判断。

OCR 位于原始文档与大模型之间的处理链路

先把感知和理解分开

如果把原图直接交给大模型,一个调用同时承担了图像解码、文字识别、版面理解、字段抽取和业务推理。任何一步出错,最终只会得到一个“看起来不太对”的 JSON。

拆开之后,链路变成:

图片 / 扫描 PDF
  → 文件真实性与资源上限检查
  → 页面栅格化与图像标准化
  → OCR 检测与识别
  → 文本、页码、坐标、置信度
  → 大模型抽取、归一化与推理
  → 业务规则校验与人工复核

这层中间结果很重要。比如模型把“2023.08”理解成“2028.03”,我可以回到对应页、对应文本框查看 OCR 原文和置信度;如果 OCR 本身正确,问题在提示词或字段规则;如果 OCR 已经错了,则应该调整图像处理、引擎或回退策略。系统终于可以回答“错在哪里”,而不是只能换一个更大的模型再试。

OCR 还能减少送入大模型的无效信息。空白页、装饰图、重复页和低价值区域可以提前过滤;正文可以按页、区块或字段相关性组织,而不是把几十张高清图片全部塞入上下文。对高频文档处理来说,这直接影响延迟、Token 成本和并发容量。

当前实现:先建立一条可靠的 OCR 基线

Shixiseng OCR Service 接受 JPG、PNG、WEBP、BMP、TIFF 和 PDF,提供同步与异步两套接口,但两者最终复用同一个识别用例。

同步接口适合单张图片和短文档:请求进入后完成校验、识别并直接返回。异步接口适合长 PDF 和批量任务:API 只保存任务元数据与临时文件,把工作交给 Celery Worker,调用方使用 job_id 查询状态。这里没有维护两套 OCR 逻辑,差别只在调度方式。

返回结果也不只有一段纯文本:

{
  "engine": "rapidocr-onnxruntime",
  "page_count": 2,
  "text": "完整文本……",
  "pages": [
    {
      "page_number": 1,
      "width": 1440,
      "height": 2036,
      "lines": [
        {
          "text": "2023.08 - 2025.06",
          "confidence": 0.986421,
          "box": [[112, 284], [486, 284], [486, 326], [112, 326]]
        }
      ]
    }
  ],
  "duration_ms": 1260
}

完整文本方便直接构造大模型上下文;逐页文本保留文档边界;坐标框支持回看原图、恢复阅读顺序和后续版面分析;置信度则可以触发复核或二次识别。结构化结果比“一大段 OCR 字符串”更有长期价值。

这套服务具体基于什么

这不是只写了一个 PaddleOCR 调用脚本。项目使用 Python 3.11 作为生产基线,把 Web 接口、文档处理、OCR 引擎与异步任务拆成独立层次。当前发布锁定的核心版本如下:

层次组件与锁定版本在系统里的职责
CPU OCRRapidOCR 3.4.2 + ONNX Runtime 1.22.1默认生产基线,负责文本检测、方向分类与文字识别
GPU OCRPaddleOCR 3.2.0 + 匹配 CUDA 的 PaddlePaddle GPU wheelGPU 节点的高吞吐识别引擎
PDF / 图片PyMuPDF 1.26.4文件解码、图片尺寸检查、PDF 分页与 RGB 栅格化
HTTP APIFastAPI 0.141.1 + Uvicorn 0.52.0上传、鉴权、Schema 校验、同步与任务查询接口
生产进程Gunicorn 23.0.0 + uvicorn-worker 0.4.0多 Worker、超时、优雅退出与请求回收
异步任务Celery 5.6.3 + Redis 6.4.0 客户端长文档排队、状态、重试、超时、幂等与限流
配置与日志Pydantic Settings 2.10.1 + Structlog 25.4.0强类型启动检查与 JSON 结构化日志

这里的“锁定版本”不是说它们永远最好,而是指这组版本已经作为一个整体进入依赖锁文件、自动化测试和发布流程。生产稳定性来自经过验证的组合,不是来自安装时临时获取各组件的最新版。升级 OCR 引擎时,必须连同模型权重、运行时、CPU 指令集或 CUDA 环境一起重新验收。

为什么 CPU 默认选 RapidOCR,而不是所有机器都装 PaddleOCR

RapidOCR 本身是面向多后端的 OCR 工具层;这个项目明确选择 ONNX Runtime 作为 CPU 推理后端。它的部署面相对小,不要求 CUDA,也不需要在普通 CPU 节点安装完整 PaddlePaddle 运行时,适合作为 Rocky Linux / AlmaLinux x86_64 服务器上的稳定基线。

CPU 引擎输出检测框、识别文字与置信度,服务再把不同版本 RapidOCR 的返回格式归一为自己的 PageResult。业务 API 因此不直接暴露第三方 SDK 对象。未来切换模型或引擎,调用方仍然使用同一套 JSON 契约。

PaddleOCR 放在哪里

PaddleOCR 是 GPU 可选实现,不是 CPU 基线的隐藏依赖。项目锁定 paddleocr==3.2.0,但没有在通用 runtime.lock 里硬锁一个 PaddlePaddle GPU wheel,因为 PaddlePaddle 必须根据目标机的 NVIDIA 驱动、CUDA 版本、操作系统和 Python ABI 选择匹配构建。正确做法是在 GPU 构建节点上先通过 nvidia-smi 确认环境,再安装官方兼容矩阵对应的 PaddlePaddle GPU 包,最后安装 PaddleOCR 并完成真实图片验收。

服务启动时会调用 paddle.is_compiled_with_cuda() 做能力探测。如果配置为严格 gpu,初始化失败就让 readiness 失败;如果配置为 auto 且允许降级,则记录明确告警后切到 RapidOCR CPU。这样不会出现“配置写着 GPU,实际上悄悄用 CPU 跑了几天却没人知道”的情况。

我怎样定义“稳定版”

我不直接把某个项目官网上的 latest 当作稳定版。对这套 OCR 服务,稳定至少满足五个条件:

  1. Python 版本、Linux 发行版、glibc、CPU 指令集或 CUDA 组合明确;
  2. Python 包使用精确版本和哈希锁定,构建过程可重复;
  3. 模型权重提前下载并记录版本,启动不访问公网;
  4. 在真实中文简历、截图、证书和扫描 PDF 上通过回归集;
  5. 同步、异步、超时、重试、进程重启与 CPU 降级都经过验收。

因此,PaddleOCR 3.2.0 只是版本号,“PaddleOCR 3.2.0 + 指定模型 + 匹配的 PaddlePaddle/CUDA + 目标机验收结果”才是一条可以发布的技术基线。

图片处理的第一原则:先判断输入是否值得识别

生产 OCR 的第一步不是调模型,而是控制输入。

服务不相信文件扩展名和客户端声明的 Content-Type,而是读取文件签名判断真实格式。上传还要经过文件大小、图片总像素、PDF 页数、单页渲染像素和文件可解码性检查;加密 PDF、损坏文件、超大图片会在进入 OCR 引擎前被拒绝。

这是准确率问题,也是稳定性和安全问题。一张尺寸异常的图片可能在解码时占用大量内存;一个页数失控的 PDF 会长时间占住 Worker;伪装扩展名的文件则不应该被底层解析器盲目处理。模型再准,也不能弥补输入边界失控。

PDF 会由 PyMuPDF 按页渲染为 RGB PNG,目前默认使用 180 DPI,并关闭没有必要的 alpha 通道。每一页识别完成后立即释放像素对象和临时图片,避免长文档把所有页面同时留在内存里。DPI 也不是越高越好:分辨率提高可能改善小字,但宽高同时放大意味着像素数和内存近似按平方增长。正确做法是用自己的文档集评估准确率与吞吐量,再选基线。

真正有效的预处理,应该按失败类型触发

“预处理”很容易变成一串固定滤镜:灰度化、二值化、锐化、放大,全部做一遍。但每次都处理不仅增加延迟,还可能抹掉浅色文字、印章或表格线。

我更认可按问题触发的处理策略:

观察到的问题处理方式需要防止的副作用
页面旋转 90°/180°文档方向分类后旋转不要只依赖 EXIF
手机拍摄透视变形四角检测与几何展开裁掉页边内容
光照不均、背景发灰局部对比度或自适应二值化浅色字和印章消失
小字号、低分辨率有上限地放大或提高 PDF DPI内存与耗时急剧增加
轻微倾斜估算文本基线并校正表格线干扰角度判断
噪点、压缩块轻量去噪笔画被当成噪声删除
超宽截图或多栏页面版面分区后分别识别阅读顺序被打乱

当前服务已经完成格式探测、资源上限、PDF 分页栅格化和统一 RGB 输入,但还没有把方向校正、去畸变与版面恢复做成独立流水线。我会把它们作为下一阶段的可插拔 DocumentPreprocessor,而不是悄悄写进某个 OCR 引擎适配器。这样才能单独测试“处理前后究竟提高了多少”,也能针对证书、简历、聊天截图使用不同策略。

CPU 是基线,GPU 是容量选择

当前 CPU 基线使用 RapidOCR + ONNX Runtime,优点是部署轻、跨机器兼容性好,适合大多数内部节点。GPU 模式使用 PaddleOCR,适合页面量大、时延要求高的场景。auto 模式优先初始化 GPU,失败时可以明确告警并降级到 CPU。

我没有把 GPU 视为“更准确”的同义词。硬件主要改变吞吐量和可承载模型规模,准确率仍取决于模型、语言、输入质量和领域数据。生产环境必须保留 CPU 基线:GPU 驱动、CUDA、PaddlePaddle wheel 和模型版本任何一处不匹配,都可能让服务在发布后无法启动。

模型在启动阶段预热,readiness 只有在 OCR 引擎、任务状态 Redis 和 Celery Broker 都可用时才通过。模型文件提前放入共享目录,生产启动不依赖公网下载。这样发布失败会表现为“不接流量”,而不是第一个真实用户替我们完成模型初始化测试。

同步与异步不是两个 API 名字,而是两种容量模型

小图片同步返回最简单,但长 PDF 不应该占住 Web Worker。服务给同步识别设置总超时,超过后明确提示改用异步接口;异步任务则有软、硬时间限制和有限重试,只对可重试错误进行指数退避。

异步提交支持 Idempotency-Key。调用方网络超时后再次提交同一份任务,不会无意创建多份重复识别。任务状态在 Redis 中进行原子转换,只允许 queued → processing → succeeded/failed 这类合法路径;任务结束后删除临时文件,结果按 TTL 自动过期。

这也是把 OCR 放到大模型前面的好处:OCR 结果可以按文件哈希、引擎版本和预处理版本缓存。后续调整提示词或更换大模型,不需要再次读取图片;只有 OCR 模型或预处理策略变化时,才重新生成感知层结果。

公网可访问,不等于可以裸奔

业务接口使用 Bearer Token,生产环境没有配置足够强度的 Token 会拒绝启动。当前 Token 与上一枚 Token 可以短期并存,便于不停机轮换;比较使用常量时间方式,Token 不进入查询参数和日志。

Nginx 负责 TLS、请求体上限、连接超时和入口限流,应用层再按调用方做滑动窗口限流。进程以不可登录的 ocr-service 用户运行,systemd 开启 NoNewPrivilegesProtectSystemProtectHome 和独立临时目录。日志只记录 request ID、调用方、文件类型、大小、页数、引擎和耗时,不记录 OCR 正文、Token 与完整文件路径。

文档里可能包含姓名、电话、邮箱、身份证和求职经历。对这样的服务,“日志更详细”不是默认正确答案。真正有用的是能够用 X-Request-ID 串起 Nginx、API、Worker 和任务结果,同时不复制用户隐私。

我采用的部署方式

这套服务的生产基线是 Rocky Linux 9 / AlmaLinux 9、Python 3.11、Redis 6+、Nginx、systemd 与 Jenkins。API 由 Gunicorn + Uvicorn Worker 运行,长任务由独立 Celery Worker 承担。CPU 与 GPU 依赖分开构建,不能把开发机上的虚拟环境直接复制到服务器。

发布使用不可变 release:

/opt/ocr-service/
├── releases/20260824-<git_sha>/
├── shared/.env
├── shared/models/
├── shared/tmp/
└── current -> releases/20260824-<git_sha>/

Jenkins 在与生产兼容的 Linux 节点上完成 Ruff、Mypy、pytest、覆盖率、依赖审计和 wheel 构建,生成带 SHA-256 校验的发布包。目标机为新 release 创建独立 venv、按哈希安装锁定依赖,再原子切换 current 软链接并重启 Worker 与 API。冒烟测试失败时,软链接切回上一版;环境文件、模型和业务临时目录不跟代码一起回滚。

部署之后至少检查四件事:进程是否存活、readiness 是否通过、同步图片能否得到结构化结果、异步任务能否从排队走到完成。只看到 systemd 的 active (running),并不能证明模型、Redis 和任务队列真的可用。

OCR 最佳实践不是某个模型排行榜

如果让我总结这次实现里最重要的原则,会是下面几条:

  1. 保留原始文件,也保留中间结果。 原图用于复核,OCR 结果带页码、坐标、置信度和版本信息,才能定位回归。
  2. 用真实业务样本建立评测集。 清晰扫描件上的平均准确率,不能代表倾斜手机照片、双栏简历和带表格证书。
  3. 按失败类型预处理。 方向、透视、光照、分辨率、版面顺序是不同问题,不要用一组固定滤镜处理所有文件。
  4. 低置信度要有去处。 可以局部放大后二次识别、切换引擎、让多模态模型查看原区域,或进入人工复核,不能假装所有字符同样可信。
  5. 文本层和视觉层互相补位。 OCR 提供可搜索、低成本、可追踪的文本;表格、印章、图表和复杂布局仍可能需要版面模型或多模态大模型。
  6. 准确率、延迟和成本一起评估。 更高 DPI、更重模型和更多预处理都有价格,最终要看字段级准确率与整条业务链路的 P95。
  7. 版本必须进入结果。 OCR 引擎、模型、预处理配置和文档哈希共同决定结果,否则升级后无法解释差异。

如果把这些原则落实成一套可执行流程,我会这样做:

1. 先建立评测集,再调参数

从真实流量按失败类型分层抽样,而不是只收集清晰样本:原生 PDF、扫描 PDF、手机拍照、倾斜、阴影、低分辨率、双栏简历、表格、印章、中英文混排都应保留。训练集、调参集与回归集分开,困难样本不能只增加、不分类。

通用字符错误率 CER 可以观察 OCR 本身,但业务最终更应该看字段级指标:姓名完全匹配率、手机号准确率、日期标准化准确率、教育与工作经历的召回率。对送入大模型的链路,还要分别记录:

OCR 字符错误率 / 字段召回率
预处理前后准确率差值
单页 P50 / P95 耗时
每页内存峰值
低置信度比例与人工复核率
大模型最终字段正确率与单文档成本

只有这样,才能判断一次优化究竟提高了 OCR,还是仅仅让某几张示例图看起来更清晰。

2. 原生 PDF 先抽文本,扫描页才做 OCR

这是当前服务下一步值得补的优化。PDF 如果已经包含可靠文字层,应优先用 PyMuPDF 直接提取,并保留字号、区块与坐标;只对没有文字层、文字层异常或以图片为主的页面执行 OCR。原生文本通常比重新栅格化识别更准确,也更快、更省内存。

但不能只用“能否抽出几个字符”判断。部分扫描 PDF 带有质量很差的隐藏 OCR 层,需要用文本长度、可打印字符比例、坐标有效性和抽样置信规则决定是复用、混合,还是整页重做 OCR。

3. 预处理必须可以开关、版本化和 A/B 对比

每个预处理步骤都应记录输入、输出尺寸、判断理由与配置版本。方向校正、去畸变、二值化和超分辨率不能永久修改唯一原图,也不能作为无法关闭的黑盒。一次模型升级如果准确率下降,应能够用同一批原图重放“旧预处理 + 旧模型”和“新预处理 + 新模型”。

PaddleOCR 3.x 已提供文档方向分类与文本图像去畸变能力,但是否启用仍要由自己的样本评测决定。手机拍照材料可能明显受益,干净扫描件则可能只增加时延。

4. 阅读顺序不能等于 OCR 返回数组顺序

单栏页面可以按文本框的纵坐标、横坐标排序,但双栏简历、表格和侧边栏需要先做版面分区。给大模型时,应显式保留页和区块,例如 <page 1><block type="experience">...</block></page>。否则每个字都识别正确,也可能因为顺序错误而把两段经历拼成一段。

5. 用置信度做路由,不把它当作绝对概率

不同 OCR 引擎、模型和字符类型的置信度不可直接横向比较。阈值需要在本领域样本上校准。更实用的路由是:高置信度直接进入大模型;中置信度对局部区域放大或切换引擎;关键字段低置信度时同时提供原图裁剪给多模态模型;仍然冲突则进入人工复核。

姓名、手机号、身份证号、日期等字段还可以做格式与业务规则校验,但校验只能发现异常,不能擅自“修正”为另一个看似合理的值。系统必须保留原始 OCR 证据。

6. 并发按内存测算,不按 CPU 核数拍脑袋

OCR 的峰值资源取决于页面像素、模型大小、推理线程和同时处理的页数。Web Worker 数、ONNX Runtime 线程、Celery concurrency 如果分别按 CPU 核数设置,叠加后很容易过度并发。当前 Worker 默认 concurrency=1 是保守起点,应该通过压力测试测出单任务峰值内存和 P95,再逐步提高。

GPU 同样不能简单开多个 Worker。多个进程各自加载模型会重复占用显存;更合理的方式通常是每张 GPU 固定少量 Worker、限制预取,并监控队列长度、单页耗时、显存和 CPU 降级次数。

7. 升级必须用同一批文档做差分验收

升级 RapidOCR、ONNX Runtime、PaddleOCR 或模型权重时,对固定回归集同时运行旧版与新版,比较文本差异、字段指标、耗时和资源。只有“平均值提高”还不够,还要查看哪些样本变差,特别是数字、日期、专有名词和中英文混排。

上线时先灰度少量流量,结果写入版本信息但不污染业务判断;确认指标后再扩大。保留旧 release、旧模型和切换开关,才能在驱动、运行时或模型出现回归时快速恢复。

交给大模型时,我会保留什么

大模型输入不应该只是 OCR 的 text 字段。我会保留页码与区块边界,按阅读顺序组织文本;对日期、公司、学校、联系方式等关键字段附带来源页与置信度;对低置信度片段提供原图裁剪或明确的“不确定”标记;对表格则优先转换为 Markdown 或结构化单元格,而不是压平成一段文字。

最终提示词可以要求模型输出字段、证据和不确定性:

{
  "field": "graduation_date",
  "value": "2025-06",
  "evidence": {
    "page": 2,
    "text": "2023.08 - 2025.06",
    "ocr_confidence": 0.986421
  },
  "needs_review": false
}

这不会让大模型永远不犯错,但会让错误可见、可回放、可度量。对招聘、合同、财税和档案类系统来说,这比一次回答“看起来很聪明”更重要。

最后的判断

我并不认为所有图片都必须先 OCR。对场景理解、图表问答、视觉关系和少量临时图片,直接使用多模态大模型往往更自然。但当任务以文字为核心,要求批量处理、稳定抽取、证据定位、隐私控制和成本可预测时,独立 OCR 仍然是一层很有价值的基础设施。

Shixiseng OCR Service 当前完成的是可靠基线:安全接收图片与 PDF,按页识别,返回结构化结果,支持 CPU/GPU、同步/异步、鉴权、限流、幂等、观测与可回滚部署。下一步不是盲目换更大的 OCR 模型,而是建立真实失败样本集,补齐按需预处理、版面恢复、置信度回退和字段级评测。

我的目标从来不是让 OCR 单独拿到一个漂亮分数,而是让图片进入大模型之前,先变成一份更干净、更可解释、也更值得信任的上下文。

延伸阅读

22 / 41

AI 产研组织的下一阶段:从职能分工走向项目小队

AI 不会消灭专业分工,但会削弱固定岗位边界。产研组织的基本交付单元,将从职能队列转向拥有完整验证能力、直接对市场结果负责的项目小队。
2026/08/20 · 15 分钟阅读

传统产研组织习惯按专业划分部门:产品负责需求,设计负责界面,前端负责页面,后端负责服务,测试负责验收,运维负责上线。每个角色都足够专业,流程也看起来足够完整。

但当市场变化越来越快、AI 大幅降低原型和工程实现成本时,问题开始从“专业能力是否充足”变成另一件事:一个真实的客户信号,需要经过多少次排队、解释、交接和重新确认,才能变成可以验证的产品?

如果答案仍然是一条漫长的职能流水线,那么 AI 只会让每个局部环节更快,却不会让组织更快得到结果。

我认为 AI 时代的产研组织正在发生一次更根本的变化:组织的基本交付单元不再是前端组、后端组或产品组,而是一个个直接面向市场结果的项目小队。例如,一名接近客户的销售或业务成员,加上两名具备产品与工程能力的产研成员,共同完成从发现问题、构建方案、交付产品到收集反馈的闭环。

产品反响好,就继续投入和迭代;反响不好,就修改假设、改变产品形态,必要时停止项目并切换方向。

AI 产研组织从职能队列走向三人项目小队,并围绕市场反馈持续迭代

真正需要消失的,不是专业能力

“不再区分前端和后端”很容易被误解为不再需要专业性,或者要求每个人掌握所有技能。这不是这场变化的重点。

真正需要消失的是以岗位边界为理由的等待:

  • “需求还没有正式流转到我这里”;
  • “这不是我的技术栈”;
  • “页面完成了,接口要等另一个排期”;
  • “功能已经开发完,市场结果与我无关”;
  • “客户反馈先汇总,下一个版本再讨论”。

专业能力仍然存在,而且在安全、数据、架构、性能与复杂交互上依然重要。变化在于:专业能力从固定的交接站,变成项目小队随时可以调用的能力。

一个成员可以在 AI 辅助下完成原型、页面、接口和基础测试,但高风险代码仍需要相应领域的专业审查;项目小队可以端到端交付,但公共基础设施和工程标准仍由平台能力守住。

因此,更准确的说法不是“没有角色”,而是:

岗位不再决定工作停在哪里,目标决定团队需要把工作推进到哪里。

换句话说:专业仍然存在,但专业不再以部门围墙的形式存在。

从职能队列转向项目小队

传统组织的资源分配逻辑通常是:需求进入产品队列,再进入设计、研发、测试和发布队列。每个环节追求自己的利用率,项目则在队列之间等待。

项目小队采用不同的逻辑。团队从一开始就围绕一个可验证的业务问题组建,而不是围绕一个预先确定的功能列表组建。

一个最小项目小队可以由三个人构成:

成员核心贡献不应被限制为
销售 / 业务成员客户信号、场景理解、验证入口、商业反馈只负责转交需求
产研成员 A产品假设、交互、前后端实现、数据观察只负责写 PRD 或页面
产研成员 B工程实现、集成、质量、交付与运行反馈只负责某一端代码

“一个销售加两个产研”只是便于理解的典型组合,不是所有项目的标准编制。体验型产品可能需要设计工程能力,数据型产品可能需要算法或数据工程能力,成熟产品也可能需要运营和客户成功加入。人数和岗位名称不是关键,小队是否拥有完成一次“发现—构建—交付—验证”闭环所需的最小能力与权限,才是关键。

它不能每前进一步都重新向职能部门申请资源,也不能把上线当成工作结束。

小队共同对一个结果负责,例如:客户是否愿意持续使用、某个问题是否被有效解决、一次试点是否能够形成复购或扩展。代码数量、功能数量和按时上线都只是过程指标。

项目小队的完整闭环

项目小队的节奏不应该从“写需求”开始,而应该从“识别信号”开始:

真实客户信号
      ↓
定义问题与最小假设
      ↓
选择最低成本的产品形态
      ↓
构建并交付可验证版本
      ↓
观察使用、价值与商业反馈
      ↓
继续迭代 / 修改假设 / 更换形态 / 停止

1. 从客户信号出发

销售或业务成员带回来的不应该只是“客户想要一个功能”,而是场景、当前做法、痛点强度、影响范围、替代方案与付费意愿。

销售带回来的不是需求清单,而是未经验证的问题信号。

小队需要把解决方案从需求中剥离出来。客户要求一个看板,真正的问题可能是无法及时发现异常;客户要求一个聊天机器人,真正的问题可能是信息分散、决策等待或服务成本过高。

2. 写最小假设,而不是完整愿望清单

小队需要明确:为谁解决什么问题,为什么相信这个问题值得解决,以及用什么信号判断方向是否成立。

最小假设不是缩短后的 PRD,而是一项可以被证伪的判断。例如:如果把某个高频判断自动化,目标用户会持续使用,并愿意把它带入真实工作流程。

3. 产品形态服从验证目标

第一版不必天然是一套完整系统。它可能是人工服务加一个内部工具、一个嵌入现有流程的插件、一张自动生成的报告、一个对话入口,或者一条由 Agent 执行但由人确认的工作流。

AI 带来的重要变化,是原型不再只能用来演示。一个小队可以在较短时间内构建包含界面、数据和部分自动化能力的可运行版本,让客户用真实任务验证,而不是只对设计稿表达意见。

4. 上线只是验证开始

项目小队必须直接看到产品被怎样使用:哪些步骤顺畅,哪里需要人工解释,用户是否主动回来,销售是否更容易推进,交付成本是否随着使用量线性增长。

如果研发只负责上线,反馈仍然由产品或业务层层转述,那么团队并没有形成闭环,只是把原来的流水线缩短了一点。

5. 明确继续、改变和停止

继续、转向和停止的条件不能等结果出现后再解释。项目启动时,小队就应约定验证周期、成本上限、核心证据和决策时间点;每轮迭代之后,再依据这些标准做出明确选择:

  • 继续迭代:问题真实,使用和价值信号正在增强;
  • 修改假设:问题存在,但用户、场景或价值判断不准确;
  • 更换产品形态:问题成立,但当前交付方式成本过高或使用阻力太大;
  • 停止项目:信号持续不足,不再用新增功能掩盖方向错误。

停止不是失败,而是把有限资源重新配置到更值得验证的方向。真正昂贵的是一个没有市场信号的项目,因为已经投入而持续投入。

项目小队不仅要有快速启动的权力,也要有及时停止的纪律。

AI 改变的是团队能力密度

项目小队能够成立,并不只是因为组织架构画得更扁平,而是因为 AI 正在提高每个人的能力覆盖范围。

产品判断可以更快形成交互原型;工程师可以跨越界面、服务和数据完成端到端实现;销售可以把访谈与反馈结构化;测试可以更早生成边界场景;团队可以让 Agent 执行资料整理、代码生成、数据分析和发布准备。

这并不意味着把所有任务都交给模型。更合理的分工是:

  • AI 负责扩展、生成、整理和执行;
  • 人负责目标、事实来源、风险边界和关键判断;
  • 自动化测试、代码审查、权限与发布机制负责守住质量;
  • 项目小队负责最终业务结果。

AI 的价值不是让原有十个岗位分别提效,而是让更小的团队拥有完成一次业务闭环的能力。

去掉职能墙,不能去掉质量底线

从职能组织走向项目小队,最大的误区是把“减少交接”理解成“取消约束”。速度不能建立在不可恢复的风险之上。

项目小队可以自主决定多数日常事项,但以下能力仍应由组织统一提供:

  • 身份、权限、数据访问与审计;
  • 代码仓库、持续集成、测试和发布基础设施;
  • 可观测性、告警、回滚和事故响应;
  • 公共组件、模型网关、知识与数据底座;
  • 安全、隐私、财务与合规边界;
  • 架构和专业能力的评审与支持机制。

这些能力不应重新变成审批队列,而应产品化为项目小队可以自助使用的内部平台。平台团队的目标不是接管项目,而是让每个小队安全地跑得更快。

前台用项目小队追求速度,后台用共享底座守住复用、质量与安全。

管理者的角色也必须改变

在职能组织中,管理者经常通过分配任务、追踪工时和协调资源发挥作用。项目小队需要另一种管理方式。

管理者要负责定义方向、约束和资源边界:哪些问题值得验证,小队拥有哪些决策权,预算和时间窗口是什么,什么情况下必须升级,以及如何处理多个项目之间的资源冲突。

同时,管理者要保护小队不被临时需求持续打断。任何新任务都必须说明它替代什么、推迟什么,以及为什么比当前验证更重要。没有取舍的“最高优先级”,最终只会让所有项目同时失速。

管理不是消失,而是从管理动作转向管理上下文:让一线团队拥有足够信息做判断,也让风险、成本与结果能够被组织看见。

考核机制也必须同步改变。如果组织仍然以完成多少需求、写了多少代码、是否按期上线评价团队,项目小队最终仍会退化为任务执行组。更值得关注的是:从信号到可验证版本用了多久,每轮验证获得了什么新认知,用户行为和价值是否改善,团队是否及时停止低价值方向,以及验证过程中是否沉淀了可复用能力。

如何判断一个项目值得继续

不同产品的指标不同,但判断框架可以保持一致。项目小队至少需要同时观察四类信号:

维度关键问题
问题强度用户是否真的频繁遇到,是否主动寻找解决办法?
使用行为用户是否完成核心动作,是否主动回来?
价值结果产品是否减少成本、提高收入、降低风险或改善关键体验?
商业证据客户是否愿意付费、续费、推荐或扩大使用?
交付经济性当前形态能否规模化,还是每增加一个客户都需要同等人工投入?
战略价值即使短期收入有限,是否沉淀了可复用能力或打开了重要入口?

单一正向信号可能具有欺骗性。用户愿意试用,不代表愿意持续使用;销售能够签下一单,不代表产品可以复制;使用频率高,也可能来自团队大量人工支持。

小队需要在开始前约定证据标准,在迭代中更新判断,而不是等结果不理想时重新定义成功。

不同产品的反馈周期也不同。一次点击、几句赞美或一次试用都可能只是短期噪声;企业采购、复杂工作流和基础设施产品往往需要更长的观察窗口。快速验证不等于草率下结论,而是用与产品周期匹配的最低成本获得可靠证据。

这种组织方式并不适合所有工作

项目小队最适合不确定性高、能够接触真实用户、需要快速验证产品形态的工作,例如新产品探索、AI 应用创新、新市场试点和持续变化的客户场景。

它不能被原样套用到所有系统。核心交易、基础设施、强监管业务以及高安全风险系统,仍然需要更严格的职责分离、专业评审和变更控制。即使采用项目小队,也必须提高自动化验证、审计和上线门槛。

判断是否适合项目小队,可以先问三个问题:问题是否仍有较高不确定性?小队能否直接获得真实反馈?失败是否可以在可控成本内恢复?如果三个答案大多是否定的,工作重点可能不是加快试错,而是提高稳定性、正确性和规模效率。

项目小队容易失败的几种方式

销售成为需求指挥者

销售最接近客户,但客户表达的解决方案不等于产品答案。销售负责提供信号和验证入口,小队共同定义问题与方案。

两名产研成员变成无限责任人

小团队不是用更少的人承担同样庞杂的项目。它要求更小的问题范围、更强的平台能力和明确的停止规则。否则所谓敏捷只是长期透支。

取消岗位,同时取消专业审查

跨栈交付不意味着任何代码都可以未经审查进入生产。越是小团队高频发布,越需要自动化门禁和按风险触发的专业评审。

每个小队重复建设基础设施

如果身份、数据、模型、监控和发布都由各项目从头实现,小队数量越多,组织技术债越大。公共能力必须沉淀为平台,而不是沉淀为另一个接单部门。

只奖励成功,不奖励及时停止

如果停止项目意味着失败,团队会不断增加功能来证明原方向正确。组织必须奖励高质量验证,包括用较低成本证明某条路线不成立。

从一个试点开始,而不是先重画组织架构

组织进化不应该从宣布“取消前端和后端岗位”开始。更稳妥的方法,是选择一个边界清晰、可以接触真实用户、风险可控的问题,组建一支最小项目小队。

给小队一个明确目标、一段验证窗口、必要的技术权限和可调用的平台能力。要求他们不仅交付功能,还要拿回使用证据、价值判断和下一步建议。

试点结束后,复盘的重点不是团队是否足够忙,而是:

  • 从客户信号到可验证产品用了多久;
  • 等待和交接减少了多少;
  • 哪些专业能力仍需要平台支持;
  • 团队能否独立解释继续、改变或停止的理由;
  • 这套方式能否在不牺牲质量的情况下复制。

只有闭环被验证之后,组织结构的变化才有依据。

组织的基本单元,应该是结果闭环

工业时代的组织通过专业分工提高效率,互联网时代通过跨职能团队缩短交付周期。AI 时代进一步降低了知识获取、原型构建和跨栈执行的成本,使更小的团队能够承担更完整的责任。

因此,未来产研中心的核心不再是拥有多少前端、后端、产品和测试,而是能够同时运行多少个高质量的市场验证闭环。

组织仍然需要专业能力、平台基础设施和风险治理,但这些能力应该围绕项目小队流动,而不是让项目在职能部门之间流动。

小团队不是为了更少的人做更多的功能,而是为了让最接近问题的人,用最低成本完成一次真实验证。

AI 时代的组织进化,不是让所有人变成没有专业方向的“全栈个人”,而是让少数能力互补的人组成拥有完整闭环的项目小队。专业能力继续存在,固定交接消失;平台底座继续存在,部门围墙变薄;管理者不再只分配任务,而是配置目标、权限、资源和停止条件。

当一个销售和两名产研成员能够共同发现问题、构建产品、接触用户、观察结果,并有权继续、改变或停止时,AI 才不只是个人效率工具,而开始成为组织结构变化的基础。

互联网与 AI 公司实践

这套组织思路不是凭空出现的新概念。AI 的新作用,是进一步降低跨专业执行成本,让小团队能够更完整地拥有从客户信号到产品结果的闭环。以下三项一手实践分别对应真实反馈、小批量迭代和端到端责任。

  • OpenAI:Building OpenAI with OpenAI:OpenAI 的 GTM、产品和工程团队共同研究真实工作流、定义成功标准,并在实际部署中测试产品,把交付周期从季度压缩到周。这与“业务成员和产研共同完成验证闭环”的组织方式直接对应。
  • Google DORA:Working in Small Batches:小批量工作能缩短反馈周期、快速检验和修正假设;DORA 还指出,这项能力有助于把 AI 带来的开发速度转化为产品和组织绩效,而不是增加组织摩擦。
  • Amazon AWS:Two-Pizza Teams 与端到端责任:小团队的重点不只是人数少,而是拥有完成开发、测试、迭代和规模化所需的资源、自治权与结果责任。

23 / 41

软件正在变成“日抛品”:AI 如何改写 SaaS 与企业内部系统

当软件的生成和重写成本持续下降,企业不必再为每个局部需求采购一套长期 SaaS。未来的软件会更贴近组织语境、按场景生成、持续重写;创业公司也必须更早依靠真实收入证明价值。
2026/08/20 · 14 分钟阅读

过去二十年,软件行业建立在一个稳定前提上:开发软件很贵,维护软件更贵,所以企业应该购买一套标准产品,让尽可能多的公司共享同一份研发成本。

这正是 SaaS 的经济基础。厂商开发一次,通过订阅反复销售;客户放弃一部分个性化,换取更低的采购成本、更快的上线速度和持续升级。

但 AI 正在改变这个前提。当自然语言可以生成界面、接口、数据处理和自动化流程,当一个熟悉业务的人可以与 AI 在几天甚至几小时内完成过去需要一个项目组才能完成的工具时,软件开始具有一种过去很少见的属性:它可以被快速生成,也可以被快速丢弃和重写。

我把这种软件称为“日抛软件”。

“日抛”并不意味着每天删除生产系统,也不意味着质量、安全和数据可以被忽略。它表达的是一种新的成本结构:对大量局部、低风险、变化快的需求来说,软件不再需要被当作一项必须使用五年、服务所有人的固定资产。它可以只服务一个团队、一个客户、一次活动,甚至一个阶段性的决策;需求变化后,与其维护越来越多的兼容逻辑,不如重新生成更合适的版本。

从标准化长期 SaaS 转向围绕企业语境按需生成、验证和重写的软件

SaaS 的真正对手,不是另一个 SaaS

传统 SaaS 习惯把竞争理解为功能竞争:谁的功能更多、界面更完整、集成数量更多、价格更低。

但 AI 之后,它真正的对手可能是客户自己的组织能力。

一家互联网公司过去需要采购工单、审批、数据看板、销售辅助、内容运营和知识管理系统。每套系统都要经历选型、合同、实施、培训、权限配置和数据迁移。即使成功上线,公司的实际流程也必须适应软件预设的数据结构和操作方式。

未来,企业可能保留少数稳定的记录系统,例如财务、人力、客户主数据和核心交易系统,同时在这些系统之上自行生成大量轻量应用:

  • 为一次销售战役生成客户跟进工作台;
  • 为一个新项目生成预算和资源审批流程;
  • 为运营团队生成只使用三个月的活动管理工具;
  • 为某类客户生成专属交付和数据分析界面;
  • 为管理层生成随着战略变化而重写的经营看板;
  • 为一条异常流程生成临时排查和修复工具。

这些工具不需要成为独立 SaaS,也不需要满足所有公司的共同需求。它们只需要理解当前组织的数据、权限、语言和工作方式,并在有限生命周期内可靠地完成任务。

于是,SaaS 的竞争对象不再只是同类厂商,而是“客户是否已经能够自己写出足够好用的软件”。

为什么通用 SaaS 越来越难

SaaS 不会消失,但薄弱的 SaaS 会越来越难。尤其是那些只把一个简单工作流包装成通用界面、主要依靠按席位收费、又不掌握关键数据和交易入口的产品。

功能越来越容易复制

过去,一个细分功能可能需要数月开发,足以形成产品窗口。现在,界面、CRUD、报表、通知、权限和基础 AI 能力都可以被快速组合。功能仍然有价值,但功能本身越来越难成为长期壁垒。

标准化开始产生额外成本

传统 SaaS 为了服务更多客户,需要不断增加配置项、角色、模板和兼容逻辑。客户最终买到的是一套能够适应很多公司的系统,却不一定是最符合自己工作方式的系统。

当定制软件足够便宜时,“标准化”不再天然代表低成本。为了迁就通用产品而改变流程、培训员工和维护大量配置,也是一种成本。

席位定价与 AI 工作方式冲突

软件过去按人头收费,因为每个人都需要登录并操作。Agent 开始承担执行后,一个流程可能由少数人监督、大量数字执行者完成。如果价值来自自动完成结果,按人类席位收费会越来越难解释。

客户会重新计算采购账

企业不只会比较两款 SaaS 的价格,还会比较:购买三年订阅、承担实施和迁移成本,与基于现有数据和模型能力自行构建之间,哪一种更经济、更贴合业务。

这并不意味着客户一定选择自建。它意味着 SaaS 厂商必须证明,自己提供的价值明显高于“企业内部借助 AI 完成”的替代方案。

我说的“融不到钱”,不是市场上一分钱都没有

我说 SaaS 公司已经越来越融不到钱,当然不是字面意义上资本市场从此不投软件了。钱还在,AI 公司也还在拿到很高的估值。只是对大多数普通 SaaS 创业者来说,融资已经不再是一条可以默认依赖的路。

以前大家习惯先做产品、讲增长、拿融资,再用下一轮的钱寻找真正的商业模式。现在这套路径越来越难走。真正变化的不是市场上有没有钱,而是资本为什么愿意把钱给你。

过去,只要市场足够大、增长故事足够好,一个通用 SaaS 可以先融资扩张,再慢慢寻找稳定的单位经济模型。今天,软件开发门槛下降、同类产品数量暴增、平台能力快速吞并应用功能,投资人会更早追问:

  • 客户为什么不能自己做?
  • 模型平台为什么不会顺手提供?
  • 产品掌握了什么独有数据、渠道或交易关系?
  • 收入增长是否依赖持续购买流量和堆叠销售人员?
  • 毛利中有多少会被模型推理、人工服务和定制交付吃掉?
  • 如果融资停止,公司能否依靠客户收入继续活下去?

所以我真正想表达的是:没有真实收入、没有差异化资产、只能依靠下一轮融资维持的通用 SaaS,以后会越来越难活。

融资可以加速一个已经成立的商业模型,但不应该继续被当成商业模型本身。

SaaS 创业要回到“自己养活自己”

AI 降低了产品开发成本,也降低了创业公司依赖资本的必要性。过去需要十几个人和数百万资金才能验证的产品,现在可能由三五个人完成。

这意味着创业公司的第一目标可以重新变成赚钱:找到一个足够具体、足够痛、客户愿意付费的问题,用收入支付团队和模型成本,再决定是否扩大。

自我造血并不等于拒绝融资。它意味着融资从生存必需品变成战略选择:

  • 不融资,也能继续服务客户;
  • 融资,是为了加快已经验证的增长;
  • 不用虚假的免费用户数量掩盖付费意愿;
  • 不用不断扩充功能证明产品仍然有价值;
  • 不被下一轮融资时间表迫使公司追求不适合自己的规模。

当软件开发变便宜,小而盈利不再是一种退而求其次的状态,而可能是更健康的企业形态。

企业内部软件会从“项目”变成“能力”

传统内部系统通常以项目方式建设:立项、写需求、排期、开发、验收、上线,然后进入漫长维护期。系统数量越来越多,组织却越来越不敢改变它们。

AI 原生的内部软件更像一种持续能力。业务人员描述问题,产研人员定义边界,Agent 读取允许访问的组织上下文,生成可运行的流程和界面;团队在真实使用中验证,再根据变化修改或重写。

未来企业的软件结构可能分成三层:

层级典型内容生命周期
稳定记录层身份、财务、客户、合同、交易和核心数据多年,严格治理
共享能力层权限、模型网关、数据接口、审计、发布和组件平台持续演进
场景应用层工作台、审批、分析、运营工具和客户专属流程数天到数月,可重写

真正“日抛”的主要是第三层,不是企业的账本、权限和核心数据。

稳定底座越强,场景应用越可以快速变化。企业需要建设的重点,也会从购买更多界面,转向治理好数据、权限、接口、模型和组织知识。

定制化不再等于外包式定制

过去提到定制软件,人们通常想到昂贵的外包项目:需求文档很厚、交付周期很长、源代码难以维护,每一次修改都要重新报价。

AI 带来的定制化不是这种模式。它更接近“组织内部持续书写软件”:

  • 使用企业自己的数据语义和权限体系;
  • 由真正使用工具的人持续参与定义;
  • 复用内部平台,而不是每次从零搭建;
  • 通过自动化测试、审计和发布机制控制风险;
  • 允许低价值工具自然退役,不追求永久维护。

这种模式下,软件的作者也发生变化。专业工程师仍然负责架构、平台、安全和高风险系统,但大量场景工具会由业务专家、产品工程师和 AI 共同完成。

代码不再是唯一稀缺资源。对业务的理解、可靠的数据、清晰的责任边界和判断什么值得做,变得更稀缺。

日抛软件不能变成一次性垃圾

生成成本下降,最容易出现的新问题是软件泛滥。每个人都能生成工具,并不意味着每个工具都应该连接生产数据或长期存在。

企业至少要守住几条边界:

  • 数据边界:应用只能访问完成任务所需的最小数据;
  • 身份边界:不能绕过统一登录、权限和离职回收机制;
  • 发布边界:进入生产前必须通过与风险等级匹配的检查;
  • 审计边界:重要动作需要记录谁发起、模型做了什么以及结果如何;
  • 所有权边界:每个工具都要有负责人、使用范围和退役条件;
  • 复用边界:重复出现的能力应沉淀到底座,而不是复制几十份实现。

“日抛”应该意味着低成本迭代和退出,而不是低质量、不可追踪和无人负责。

哪些 SaaS 仍然有长期价值

AI 不会让所有软件都回到企业内部。以下几类 SaaS 反而可能更重要:

系统记录与交易网络

承载财务、支付、合同、身份、供应链和行业交易的系统,不只是一个界面,还代表可信记录、规则执行与外部网络。

深度行业数据与决策能力

真正理解行业语义、持续积累高质量专有数据、能够影响关键决策的产品,不容易被一个临时生成的应用替代。

安全、合规和责任交付

当客户购买的是审计、合规、可靠性和责任承诺,而不仅是功能,专业厂商仍然具有规模优势。

成为企业生成软件的底座

未来最有价值的 SaaS 可能不再规定客户必须使用某套固定界面,而是提供 API、数据模型、权限体系、Agent 能力和可组合组件,让企业在其上生成自己的工作方式。

SaaS 不会消失,但会从“卖一套固定软件”转向“提供企业无法轻易自建的可信能力”。

对企业和创业者意味着什么

对于企业,不要把 AI 采购简单理解为再增加一个软件订阅。更重要的是建立内部软件生成能力:整理数据和接口,建设安全底座,让懂业务的人与懂工程的人共同解决问题,并允许低价值工具快速退出。

对于创业者,不要再假设写出一个功能就自然拥有一家公司。需要更早回答:为什么客户愿意持续付费,什么能力无法被模型平台或客户内部团队复制,以及在没有下一轮融资时能否健康经营。

对于产研人员,价值也会从“完成指定模块”转向“理解问题并交付结果”。当代码变得更便宜,问题定义、系统判断、数据治理和商业理解会变得更昂贵。

软件的价值,将从代码转向上下文

工业化软件追求一次开发、无限复制。日抛软件追求每一次生成都更贴近当下问题。

未来企业不会停止购买软件,但会更谨慎地购买那些只有界面和流程、没有数据与网络价值的标准产品。它们会保留稳定底座,同时在内部生成越来越多定制化、短生命周期的场景应用。

创业公司也不能再把融资视为默认燃料。最可靠的资本仍然是客户收入,最坚固的壁垒也不再是写出了多少代码,而是掌握了多少真实工作流、可信数据、分发关系和交付责任。

当软件可以随时重写,真正需要长期积累的就不再是每一行代码,而是企业的上下文、数据、信任与判断。

“日抛”不是软件价值的终结。恰恰相反,它让我们第一次有机会把大量软件从需要供养的资产,变成随业务变化而生、完成任务后可以从容退出的工具。

参考资料

24 / 41

一份内容,三个阅读终端:我如何把个人技术札记做成网站、小程序与 macOS 应用

从响应式个人网站到微信小程序,再到原生 macOS 双页阅读器:复盘我如何用统一内容源、独立只读 API 与终端化体验,构建自己的跨平台技术札记系统。
2026/08/20 · 10 分钟阅读

过去一段时间,我把自己的个人网站逐步扩展成了三个可以真实使用的阅读终端:面向公开访问与搜索的 PC / 移动网站、适合微信内快速浏览的 微信小程序,以及强调沉浸阅读、收藏与离线能力的 原生 macOS 桌面应用

它们不是三份各自维护的内容,也不是把网页简单套进不同尺寸的壳。文章只在网站项目中维护一次,再由不同客户端通过边界清晰的只读 API 获取适合自己的数据。共享的是内容事实,分开的是交互、信息密度、缓存方式与产品职责。

现在就使用
访问 houhuiyang.com · 下载“代码与产品札记”macOS 1.0.0(macOS 14+)
macOS 安装包 SHA-256:7a45940a1278f366f452467b766372e5a693f1d144b0be525c902461d38511e9

为什么要做三个版本

同一位读者在不同场景里的需求并不相同。

在电脑浏览器中,他可能从搜索引擎进入,希望看到完整文章、项目背景、个人经历和可分享链接;在微信里,他更需要几秒内打开、快速了解内容并继续转发;坐在 Mac 前准备认真阅读时,他可能希望搜索、收藏、记录进度,并在网络不稳定时继续打开最近读过的文章。

因此,这套产品没有追求“所有终端完全一样”,而是给三个终端分配不同职责:

终端首要任务内容形态关键体验
网站公开发布与长期沉淀完整中英文内容SEO、链接分享、响应式布局
微信小程序微信内快速发现中文摘要与精选段落快速打开、文章与项目导航、扫码进入
macOS桌面深度阅读完整 Markdown搜索、收藏、双页阅读、进度与离线缓存

网站:内容的唯一来源,也是公开入口

网站是整套系统的内容源。文章以 Markdown 保存在同一个仓库中,标题、摘要、日期、标签、封面与正文一起版本化;Next.js 在构建时生成中英文页面、元数据、站点地图和结构化的文章路由。

PC 版本承担完整的信息表达。首页同时展示“现在、方法与系统、我如何思考、走过的路、AI 实践与技术札记”,让一篇文章能够回到作者长期关注的问题,而不是成为孤立的信息碎片。

houhuiyang.com PC 版完整页面

PC 首页顶部预览,点击图片查看完整长图。

移动网站使用同一套内容,但不是机械缩小桌面布局。导航折叠为移动菜单,横向卡片重排为纵向信息流,标题、正文、按钮和时间线重新建立适合窄屏的阅读节奏。这样,从搜索、聊天或社交平台打开链接时,读者不需要安装任何客户端。

houhuiyang.com 移动版完整页面

移动网站顶部预览,点击图片查看完整长图。

网站保持最高的信息完整度,也承担公开 URL、canonical、Open Graph、sitemap 和搜索引擎收录。小程序与桌面端可以提升阅读体验,但不取代开放网页。

微信小程序:把发现路径放进微信

微信小程序面向的是另一种使用状态:用户往往不是准备长时间阅读,而是从聊天、二维码或个人主页快速进入。因此首页只保留身份简介、当前关注方向、精选项目以及文章入口,并使用底部导航把“首页、文章、项目”固定为三个主要目的地。

代码与产品札记微信小程序首页

小程序没有直接读取网站页面 HTML,而是调用独立的 /api/articles 接口。接口返回适合小程序展示的标题、摘要、标签、阅读时间和精选段落;客户端只负责渲染,不复制网站正文,也不拥有文章编辑能力。

这条边界有两个价值:一是网站改版不会让小程序解析失效;二是接口可以主动控制移动场景的信息量。公开网站负责完整表达,小程序负责低摩擦发现,两者不必被迫使用相同版式。

微信扫码打开小程序

微信扫码打开“代码与产品札记”小程序

macOS:把文章变成桌面上的一本书

macOS 版本不是 WebView 外壳,而是使用 Swift 6 与 SwiftUI 构建的原生阅读器。左侧是个人栏目导航,中间是可搜索的文章书架,右侧使用双页书本布局展示正文。窗口尺寸、侧栏、列表选择和阅读区都遵循桌面端的空间关系。

“代码与产品札记”macOS 阅读器的书架与双页阅读界面

桌面端通过 /api/reader 命名空间读取个人栏目、文章列表与完整 Markdown。它与小程序接口隔离,因为两个客户端对内容的要求本来就不同:小程序需要轻量摘要,macOS 阅读器需要完整正文、目录和图片清单。

当前版本支持:

  • 中英文文章与个人栏目;
  • 标题和标签搜索;
  • 收藏与本地阅读进度;
  • 最近内容缓存与离线回退;
  • Markdown、表格、引用、代码块和公开图片;
  • 接近纸书的双页阅读布局。

下载 macOS 版本

下载“代码与产品札记”1.0.0 DMG

系统要求为 macOS 14 Sonoma 或更高版本。当前安装包使用 ad-hoc 签名;首次打开如果被系统拦截,可在 Finder 中右键应用选择“打开”,或在“系统设置 → 隐私与安全性”中确认打开。

下载后可以校验文件:

shasum -a 256 houhuiyang-notes-macos-1.0.0.dmg

预期结果:

7a45940a1278f366f452467b766372e5a693f1d144b0be525c902461d38511e9

一份内容如何到达三个终端

这套系统的核心不是客户端数量,而是内容所有权足够清楚:

Markdown 文章与个人资料
          │
          ▼
   Next.js 内容与页面层
     │          │
     │          ├── 公开网站:完整页面、SEO、分享链接
     │          │
     ├── /api/articles:小程序摘要与精选段落
     │
     └── /api/reader:macOS 完整 Markdown、目录与资源

所有客户端接口都是只读的。新增、修改和删除文章仍然只发生在内容仓库;客户端不会把本地状态反写成网站内容。收藏、阅读进度和缓存属于终端自己的用户体验数据,不污染文章事实。

接口也使用版本和稳定标识来降低耦合。文章以 slug + locale + updated 组成缓存版本键;客户端忽略未来新增的未知字段,并在服务不可用时读取最近一次成功缓存。网站可以继续迭代视觉,小程序和 macOS 应用也可以按自己的节奏发布。

我从这次跨端实践中得到的结论

第一,多端不等于多份内容。只要源头唯一、接口职责清楚,新增一篇文章就能自然到达多个阅读终端。

第二,响应式网页与原生客户端解决的是不同问题。网页拥有最低访问门槛和最好的开放性;小程序缩短微信生态内的发现路径;原生 macOS 应用则利用更大的屏幕、本地存储和系统交互,提供更完整的阅读状态。

第三,API 不是为了“前后端分离”而存在,而是为了稳定产品边界。小程序不应依赖网页 DOM,桌面端也不应复制文章数据库。接口让终端共享事实,同时保留各自的产品判断。

我希望“代码与产品札记”最终不只是一个展示作品的个人主页,而是一套可以持续写作、发布、阅读和演进的小型内容系统。网站、小程序和 macOS 只是当前的三个入口;真正值得长期维护的,是它们背后那份统一、可迁移、不会被单一平台锁住的内容。

25 / 41

垂类大模型不是一个模型:我如何构建本地 AI 求职系统 Atlas

基于 Qwen3-0.6B、MLX LoRA、本地岗位索引、简历解析、规则引擎与意图路由,复盘实习僧 Atlas 从通用模型走向招聘垂类 AI 系统的工程实践。
2026/08/18 · 14 分钟阅读

市面上很多产品都被称为“法律大模型”“医疗大模型”或“招聘大模型”。这个名字很容易让人以为,团队从随机权重开始训练了一个全新的行业基础模型。

真实情况通常不是这样。

多数垂类 AI 产品的核心,是把通用基座模型放进一套完整的行业系统:垂直数据负责提供领域经验,RAG 和数据库负责提供事实,规则引擎负责确定性判断,工具负责执行动作,路由负责选择能力,权限与评测体系则决定模型可以看到什么、可以做什么,以及结果是否足够可靠。

我最近构建的实习僧 Atlas,就是这样一个本地 AI 求职模型系统。

Atlas 回答“你是谁”

它并不是从零训练的新基础模型。当前研发版本以 Qwen/Qwen3-0.6B-MLX-4bit 为基座,使用招聘相关性数据进行 MLX LoRA 微调,再结合本地岗位快照、简历解析、检索与排序、资格规则和任务工作流,形成面向校招与实习场景的完整产品。

这篇文章记录的重点,不是如何给通用聊天界面换一层招聘皮肤,而是:怎样让模型只负责它擅长的理解与解释,把事实、权限和执行交给更可靠的系统组件。

垂类大模型首先是系统,而不是权重文件

一个可用的垂类产品通常可以概括为:

通用基础模型
+ 行业 Prompt / LoRA 微调
+ 企业知识库与业务数据库
+ 检索和排序
+ 规则引擎
+ 工具调用与任务工作流
+ 意图路由
+ 权限与安全控制
+ 离线评测与发布门禁

模型权重只是其中一层。

如果让大模型同时承担岗位数量查询、学历条件判断、相关性排序、匹配解释和实际投递,它既容易编造事实,也很难审计。一个生成流畅的模型,并不天然具备事务一致性,更不能凭语言自信程度判断某次投递是否真的成功。

因此 Atlas 从设计之初就把能力拆开:

能力Atlas 中的责任组件
岗位数量与真实字段本地岗位数据库
岗位召回本地向量索引与关键词检索
城市、学历、实习时长等硬条件确定性资格规则
简历与岗位相关性排序逻辑与 Atlas 模型
匹配原因和求职建议本地大语言模型
简历读取范围上下文权限控制
一键投递用户确认后的确定性工作流
模型能否发布冻结评测集与质量门禁

这条边界非常重要:事实由数据源回答,规则由代码执行,语言模型负责理解、归纳和解释。

Atlas 当前的模型身份

Atlas 对自己的回答必须可追溯,而不能只说“我是一个 AI 助手”。当前版本的身份信息包括:

  • 模型族:shixiseng-atlas
  • 研发版本:0.1.0-dev
  • 基础模型:Qwen/Qwen3-0.6B-MLX-4bit
  • 适配器:mlx-qwen3-0.6b-relevance-balanced-v1
  • 训练方式:MLX LoRA,当前适配器训练 192 次迭代;
  • 推理方式:Apple Silicon 上的本地 MLX / Metal 推理;
  • 数据范围:本机岗位快照、简历和会话数据;
  • 当前质量状态:experimental-gate-failed

最后一项尤其不能隐藏。适配器已经完成训练并跑通加载与推理链路,不代表它已经达到生产质量。当前数据规模、结构化输出稳定性和独立评测结果仍不足以通过发布门禁,因此产品界面明确标记为实验版。

“训练成功”与“可以上线”是两件不同的事。

三种真实应用场景

目前 Atlas 已经跑通三条面向求职用户的本地工作流。下面的画面均来自当前实验版本的真实问答,不是设计稿或静态演示数据。

1. 根据简历寻找单个城市的工作机会

用户选择一份本机简历后,可以直接询问“帮我寻找深圳的工作机会”。Atlas 从本地岗位库检索并排序,返回相关机会数量、高度匹配数量、推荐岗位和可核查的匹配原因。

Atlas 根据本机简历检索深圳工作机会并解释岗位匹配原因

2. 对比两个城市的机会数量

面对“深圳和杭州哪个城市的机会更多”这类问题,数量来自本地岗位索引的确定性统计,而不是让语言模型猜测。回答同时说明统计口径,避免把简历关键词初筛数量误解为城市全部岗位数。

Atlas 对比深圳与杭州的简历相关岗位数量

3. 跨城市比较并执行模拟投递

Atlas 可以检索两个城市的匹配岗位、生成对比表、把每个城市的首选岗位加入当前会话的投递计划,并执行本机模拟投递。当前实验版不会向任何企业发送真实申请;这条链路用于验证用户确认、任务状态和结果反馈。

Atlas 比较深圳与杭州岗位并完成本机模拟投递流程

四类意图,而不是一个万能聊天入口

用户在求职产品里发出的消息差异很大:

帮我找北京的产品实习
分析一下我的简历
产品经理面试应该怎么准备
唐朝有哪些著名诗人

如果所有消息都进入同一个 Prompt,并自动携带简历与岗位上下文,不仅会浪费推理资源,还可能造成隐私越界和任务污染。

Atlas 目前先把请求路由为四类:

Atlas 整体路由架构:从用户输入到事实校验与输出

路由典型任务是否读取简历岗位策略
job_search搜索、推荐、比较岗位重新检索本地岗位
resume_analysis分析和优化简历不自动推荐岗位
career_chat面试准备、求职建议、岗位追问按需沿用已有结果
general_chat非招聘通用问题不读取岗位

下面这张简化图更直接地展示了四种业务模式与安全兜底如何汇入统一回答层:

Atlas 四模式简化路由架构

路由之后,系统再决定使用哪套系统提示词、是否注入候选人画像、是否访问本地岗位索引,以及回答是来自确定性逻辑还是模型生成。

例如,“北京有多少个适合我的岗位”不应由模型根据语感猜一个数字。系统先查询与当前简历相关的本地索引,再把确定结果交给回答层。模型可以解释这些岗位为什么值得关注,但不能改写岗位数量。

同一个模型可以有两种上下文,但仍有局限

当前 Atlas MVP 使用同一个 Qwen3 0.6B 基座和同一个 Atlas LoRA,通过两套系统提示词与上下文隔离支持通用模式和求职模式:

用户消息
→ 意图分类
→ 选择 general 或 career 系统提示词
→ 按路由决定是否读取简历与岗位
→ 本地模型生成或确定性旁路回答

这套设计开发快、运行简单,适合验证本地产品闭环。它已经解决了一个关键问题:通用问题不会收到简历、岗位列表或岗位数量等招聘上下文。

但它仍有明显限制:通用模式虽然换了 Prompt,却仍然加载招聘 LoRA。 微调形成的招聘倾向可能残留在通用回答里。Prompt 可以约束当前任务,却不能完全抹掉适配器对模型行为的影响。

因此更成熟的下一步不是继续堆 Prompt,而是按任务切换适配器:

general_chat
→ 通用 Instruct 基座
→ 不加载招聘 LoRA
→ 不读取简历和岗位

resume_analysis / career_chat
→ 相同基础模型
→ 按需加载 Atlas 招聘 LoRA
→ 只读取已授权上下文

job_search
→ 本地岗位索引与确定性规则
→ 模型只负责解释

投递任务
→ 用户确认
→ 确定性业务接口执行
→ 返回真实操作状态

这样既能共享 tokenizer、基础权重和推理设施,又能避免招聘微调持续影响通用能力。

本地运行不是一句隐私口号

Atlas 的简历、岗位索引、会话数据库和模型推理都保留在本机。macOS 桌面端使用原生 AppKit 与 WebKit,只作为本地服务的轻量外壳;模型通过 MLX 在 Apple Silicon 上加载和推理。

但“本地”本身并不自动等于“安全”。系统仍需要明确:

  • 通用模式不能读取简历和岗位;
  • 未经选择的简历不能进入模型上下文;
  • 外部链接不能继承本地数据;
  • 投递前必须由用户确认;
  • 模型生成不能伪装成业务接口执行结果;
  • 训练、评测与发布产物必须保留版本和摘要。

真正的隐私来自可验证的数据流,而不只是界面上的“本地 AI”标签。

为什么小模型仍值得做

Qwen3-0.6B 是一个实验级小模型。它的知识广度、复杂推理和指令稳定性都不能与更大的生产模型相比。

但小模型对这一阶段仍然有价值:

  • 可以在普通 Apple Silicon 设备上本地运行;
  • 加载和迭代成本低,适合快速验证 LoRA、路由和评测链路;
  • 隐私边界清晰,不需要把简历发送给外部推理服务;
  • 能逼迫系统把事实查询和确定性逻辑从模型中拆出来;
  • 未来替换更强基座时,路由、权限、检索和工作流接口可以继续复用。

如果一个产品只有在模型“无所不能”时才成立,它通常还没有形成可靠架构。相反,当 0.6B 模型只承担受控的语言任务,系统仍能提供真实岗位、可解释匹配和安全执行,这套产品骨架才有长期价值。

当前实验版本与线上模型规划

需要特别说明的是,本文展示的 Qwen3-0.6B-MLX-4bit + LoRA 只是当前本地实验版本。现阶段的目标不是证明 0.6B 小模型已经具备生产级招聘能力,而是先用较低成本跑通数据处理、LoRA 训练、模型加载、意图路由、上下文隔离、本地检索、规则判断和质量评测这一整条链路。

线上版本规划采用更强的 Qwen/Qwen3.5-27B + QLoRA。届时仍会保留现在已经验证过的系统边界:岗位事实来自数据库,硬性条件由规则判断,模型主要负责语义理解、相关性分析和解释生成,高风险动作则必须经过用户确认和确定性工作流。

因此,当前 0.6B 版本更像是一套可运行的工程验证环境,而不是最终模型结论。它帮助我尽早暴露数据、训练、路由、隐私和评测问题;等整条链路稳定后,再把更大的训练与推理成本投入线上模型,避免一开始就用昂贵模型掩盖系统设计上的缺陷。

我从 Atlas 得到的结论

所谓“垂类大模型”,更准确地说是一个以行业模型为核心、但不把所有责任推给模型的产品系统。

它的竞争力不只来自一次 LoRA 训练,而来自一整套持续积累:

  • 是否拥有合法、干净、可评测的垂直数据;
  • 是否能把真实业务对象接入检索与工具;
  • 是否知道哪些判断必须由规则完成;
  • 是否能隔离上下文与最小化权限;
  • 是否有冻结评测集和明确的发布门槛;
  • 是否能让失败被看见,而不是用营销名称掩盖。

因此,我会把 Atlas 描述为:

基于 Qwen3-0.6B-MLX-4bit,通过 Atlas 招聘数据进行 LoRA 微调,并结合本地岗位检索、简历解析、资格规则、意图路由和任务工作流构建的招聘垂类模型系统。

它不是从零训练的全新基础模型,也还不是生产级产品。但它已经验证了一条更务实的路线:用通用模型获得语言能力,用垂直数据获得领域偏好,用数据库和规则守住事实,再用权限、评测与工作流把模型变成真正可用的产品。

26 / 41

CoreX 开发实录:用 Swift 构建一款原生 macOS 实时系统监控工具

从 Mach、IOKit、Metal 到 SwiftUI 与 MenuBarExtra:CoreX 如何在本机采集 CPU、GPU、内存、磁盘、网络和热状态,并完成设置系统、菜单栏体验与 macOS 应用打包。
2026/08/17 · 14 分钟阅读

我开发 CoreX,不是为了再做一张“看起来很专业”的仪表盘,而是想回答一个更实际的问题:一台 Mac 此刻为什么变慢、风扇为什么开始工作、内存压力是否已经影响任务,以及这些信息能否在不上传数据的前提下被快速理解。

CoreX 是一款完全在本机运行的原生 macOS 系统监控工具。它使用 Swift 6、SwiftUI 和 AppKit 构建界面,通过 Mach、IOKit、Metal、Foundation 与 Darwin 读取系统状态,覆盖 CPU、单核负载、GPU、内存、磁盘、网络、运行时间和系统热压力。主窗口负责分析,菜单栏负责扫一眼,设置系统负责决定它应该怎样融入日常工作。

下载 CoreX 1.0(macOS 14+,Apple Silicon)
下载 CoreX-1.0-macOS-arm64.zip · 约 2 MB
SHA-256:ae116fe638e81e3b2acfa34dd531ebbe4251bfa2b3cae7074a223136a7ea321a

CoreX 系统总览

产品边界:不是“数据越多越好”

系统监控工具很容易陷入两个极端:要么只展示几个百分比,无法解释问题;要么把所有底层指标堆在一起,让用户自己寻找异常。CoreX 采用三层信息架构:

  1. 概览层:CPU、GPU、内存、磁盘、网络和热状态,几秒内判断机器是否健康。
  2. 诊断层:每核心负载、P-core/E-core 分组、实时曲线和设备信息,定位瓶颈来自哪里。
  3. 常驻层:菜单栏只保留最重要的数据,不打开主窗口也能观察变化。

采样和展示也被刻意分开。SystemMonitor 负责产生统一快照,SwiftUI 只消费状态;历史序列保留固定长度,避免曲线无限增长。暂停监控时停止刷新,而不是仅仅停止动画。这个边界让 UI、采集和偏好设置可以独立演进。

Mach / IOKit / Metal / Darwin / Foundation
                    │
                    ▼
           SystemMonitor 采样器
          计算差值、归一化、限幅
                    │
          ┌─────────┴─────────┐
          ▼                   ▼
   当前 Snapshot          固定长度历史序列
          │                   │
          └─────────┬─────────┘
                    ▼
       SwiftUI Dashboard + MenuBarExtra
                    │
                    ▼
       AppStorage / 通知 / 登录启动策略

Swift 如何读取 macOS 的真实状态

CPU:比例必须来自两个时刻的差值

CPU 时间是累积计数器,不能把某次读取的值直接当成瞬时利用率。CoreX 通过 Mach 的 host_statisticshost_processor_info 读取 user、system、nice、idle ticks,保存上一次快照,再用本次与上次的差值计算:

usage = Δ(user + system + nice) / Δ(user + system + nice + idle)

总 CPU 与逐核 CPU 使用同一计算原则。Apple Silicon 上再结合核心数量,把性能核与能效核分组展示。工程上必须处理首次采样、计数器异常、数组释放和结果限幅,否则启动瞬间或长时间运行后容易出现跳变。

内存:展示压力,而不只展示“已用”

CoreX 通过 host_statistics64 获取 active、inactive、wired、compressed 和 free pages。macOS 会主动利用空闲内存进行缓存,因此“内存占用高”并不必然意味着系统有问题。界面同时提供用量与趋势,把数值放回时间上下文,而不是用一个红色百分比制造焦虑。

GPU:Metal 识别设备,IOKit 尝试读取负载

MTLCopyAllDevices() 用于获取 GPU 名称与设备信息;实时利用率则从 IOKit 的 IOAccelerator 性能统计中读取。需要说明的是,GPU 利用率不是跨所有 macOS 与硬件组合都稳定公开的标准接口:如果驱动没有暴露对应字段,CoreX 会显示不可用,而不是伪造一个零值。

磁盘、网络与热状态

  • 磁盘容量使用 URLResourceValues.volumeTotalCapacityvolumeAvailableCapacityForImportantUsage,反映系统认为真正可用于重要任务的空间。
  • 网络通过 getifaddrs 聚合活动接口字节数,再以采样间隔计算上传、下载速率;需要排除 loopback,并处理接口切换造成的计数重置。
  • 热状态使用 ProcessInfo.thermalState。这是 macOS 提供的系统级热压力信号,并非某个传感器的摄氏温度。CoreX 因此使用“正常、较高、严重、危急”表达,不把估算值伪装成精确温度。

所有数据均在本机读取和渲染,CoreX 不需要账户,也不会把监控数据上传到服务器。

为什么选择 SwiftUI,同时保留 AppKit

SwiftUI 非常适合仪表卡片、状态驱动视图、主题和设置表单;但一个成熟的 macOS 工具还需要窗口激活、Dock 策略、应用重开和 About 面板等生命周期控制。因此 CoreX 不是纯 SwiftUI 项目,而是组合使用:

  • WindowGroup 管理主窗口,设置最小尺寸和默认尺寸;
  • MenuBarExtra(.window) 提供可交互状态卡;
  • NSApplicationDelegateAdaptor 处理关闭最后窗口后是否退出、点击 Dock 图标后恢复窗口;
  • NSApplication.setActivationPolicy 在普通应用和仅菜单栏模式间切换;
  • SMAppService 管理登录时启动。

这种方式比强行只用一种 UI 框架更符合 macOS 工具的真实需求:SwiftUI 负责声明式界面,AppKit 补齐系统行为。

设置不是装饰,而是产品行为的一部分

CoreX 设置面板

CoreX 的设置分为外观、通用、监控、通知、快捷键和关于。重要的不是选项数量,而是每一个选项都真正连接到运行行为:

  • 跟随系统、浅色或深色主题,强调色、界面密度、圆角、玻璃材质与动画;
  • 登录启动、启动后显示主窗口或仅驻留菜单栏、关闭窗口后是否继续运行;
  • 1/2/5 秒刷新间隔、启用的指标、60 秒/5 分钟/15 分钟历史长度;
  • 菜单栏显示图标、CPU 或 CPU + GPU;
  • CPU、内存、磁盘和热压力阈值通知;
  • 打开总览与暂停监控的快捷键。

偏好通过 @AppStorage 持久化,但“保存了值”并不等于“实现了功能”。例如显示 Dock 图标的开关必须调用 activation policy,刷新间隔必须重建采样节奏,关闭窗口后的策略必须进入 App Delegate。开发中我把每个设置都当作一条从 UI 到系统行为的链路来验证。

菜单栏是高频入口

CoreX 菜单栏实时状态

菜单栏状态卡只显示 CPU、GPU、内存和当前运行状态,并提供设置、更新检查和退出。它适合在编译、运行本地模型、视频处理或多任务切换时快速观察资源变化。主界面负责解释,菜单栏负责低打扰感知,两者不应该复制同一套信息密度。

开发与打包环境

项目使用 Swift Package Manager,最低部署目标为 macOS 14,链接 IOKitMetal。开发机应安装版本匹配的 Xcode 或 Command Line Tools:Swift 编译器与 macOS SDK 若来自不同版本,可能出现“SDK 由另一版本 Swift 编译”的错误。可靠的发布流程应固定 Xcode 版本,并在干净环境中构建。

cd MacPulse
./scripts/build-app.sh
open dist/CoreX.app

构建脚本执行 release 编译、组装 .app 目录、生成图标并进行签名。当前下载包为 arm64,使用 ad-hoc 签名,适合直接试用和内部发布;正式面向大量用户时,应改用 Developer ID Application 证书,提交 Apple notarization,并通过 stapler 附加公证票据。

适合哪些 Mac

项目当前下载包
操作系统macOS 14 Sonoma 或更高版本
处理器Apple Silicon:M1、M2、M3、M4、M5 系列
Intel Mac当前 arm64 包不支持;源码架构可扩展通用包
网络运行不需要联网;检查更新除外
数据所有监控数据只在本机处理
GPU 数据取决于系统驱动是否暴露 IOKit 性能字段

它尤其适合开发者、本地大模型用户、设计与视频工作者,以及希望长期观察 Mac 资源状态的人。它不适合作为数据中心监控、远程告警或硬件维修诊断工具,也不应替代 Apple Diagnostics。

下载、安装与安全说明

  1. 下载 CoreX 1.0 并解压。
  2. CoreX.app 拖入“应用程序”目录。
  3. 首次启动建议右键应用并选择“打开”。如果 Gatekeeper 阻止启动,可前往“系统设置 → 隐私与安全性”确认“仍要打开”。
  4. 可用下面的命令核对安装包:
shasum -a 256 CoreX-1.0-macOS-arm64.zip
# ae116fe638e81e3b2acfa34dd531ebbe4251bfa2b3cae7074a223136a7ea321a

当前版本没有 Apple 公证,这是公开测试包最需要补齐的发布环节。这个限制必须被明确说明,而不是把 Gatekeeper 提示留给用户猜测。

这次开发留下的几条原则

第一,系统监控的难点不是绘图,而是指标语义。累积值要转换成差值,缺失值要如实表达,热压力不能冒充温度。

第二,原生体验来自行为闭环。窗口、Dock、菜单栏、登录启动和偏好设置只有真正接入生命周期,才算功能完成。

第三,发布链路属于产品。固定工具链、架构标识、签名、公证、哈希校验和下载说明,都应该和代码一起设计。

CoreX 的下一步会聚焦在更可靠的 GPU 兼容性、可诊断的内存压力、进程级资源归因、通用架构包,以及完整的 Developer ID 签名与公证。对一款本机系统工具而言,“可信、准确、低打扰”比不断增加图表更重要。

27 / 41

FaceFizz:把趣味相机装进浏览器,源码公开后的产品与工程复盘

从摄像头权限、Canvas 实时特效到 MediaPipe 本地人像分割,复盘 FaceFizz 如何在浏览器中完成一个隐私优先、打开即玩的趣味相机。
2026/08/11 · 10 分钟阅读

我把 FaceFizz.fun 的源码公开到了 GitHub。它是一款运行在浏览器里的趣味相机:用户不需要下载 App,也不需要注册账号,允许摄像头后就能实时体验鬼脸变形、镜像分身、贴纸、相框、艺术滤镜、节日装扮和背景场景,最后把照片保存到本机。

这个项目看起来不大,却把产品体验、浏览器媒体能力、实时图像处理、端侧 AI、隐私边界、多语言和响应式设计放进了同一条链路。本文不是功能清单,而是一次从产品目标到工程实现的完整复盘。

最先确定的不是技术,而是体验边界

趣味相机的价值不在于滤镜数量,而在于用户第一次打开页面后,能否快速看到一个有趣结果。为此,FaceFizz 给自己设定了几条边界:

  1. 打开网页即可使用,不把注册放在相机之前;
  2. 权限申请前说明用途,关闭拍照窗口时立即停止摄像头;
  3. 实时画面和生成照片默认不上传服务器;
  4. 首屏只展示八个精选效果,不用数量制造复杂感;
  5. 桌面端负责完整探索,移动端保证单手完成授权、选效果、拍照和保存。

这些约束决定了技术方案:FaceFizz 不是“上传照片—服务端处理—等待返回”,而是一条浏览器本地实时渲染链路。

页面效果

桌面端采用编辑式首页,把效果分类、预览拼贴、隐私说明和主操作放在一个页面内。用户可以先浏览,再打开相机。

FaceFizz 桌面端首页

移动端重新组织了信息密度,而不是简单缩小桌面布局。标题、效果卡片、相机入口和隐私提示依旧保留明确层级。

FaceFizz 移动端首页

浏览器中的完整处理链路

FaceFizz 的核心数据流可以概括为:

用户授权摄像头
  → getUserMedia 获取 MediaStream
  → video 提供实时帧
  → 镜像与 cover 裁剪
  → Canvas 2D 效果管线
      ├─ 变形 / 镜像 / 拼贴
      ├─ 色彩 / 像素 / 艺术滤镜
      ├─ 贴纸 / 相框 / 节日元素
      └─ MediaPipe 人像分割 → 背景合成
  → requestAnimationFrame 实时预览
  → 三秒倒计时
  → Canvas 导出 JPEG
  → 用户本地下载

浏览器通过 navigator.mediaDevices.getUserMedia 获取前置摄像头,理想分辨率设置为 1280×1280;真正的效果输出统一绘制到 720×720 Canvas。统一内部画布尺寸可以降低每种设备、每种视频比例直接参与效果计算带来的复杂度,也让预览和拍照结果共用同一条渲染管线。

渲染循环使用 requestAnimationFrame 驱动。视频帧先按 cover 规则裁剪,再根据镜像状态写入中间 Canvas,最后由当前效果完成变形、合成或颜色处理。拍照时不重新实现一套滤镜,而是直接从当前输出 Canvas 以 image/jpeg、质量 0.92 导出,避免“预览看到的效果”和“保存下来的照片”不一致。

为什么用 Canvas 2D,而不是先上 WebGL

FaceFizz 的第一阶段目标是验证完整产品链路,而不是打造专业图像引擎。Canvas 2D 已经可以覆盖:

  • 区域拉伸与切片偏移;
  • 镜像、四格和三联画;
  • 像素化、反色和色调处理;
  • 图片贴纸、相框和节日素材;
  • 多层画布与遮罩合成。

它的优势是 API 简单、调试直接、与 DOM 图片素材配合自然,并且能快速覆盖桌面和移动浏览器。代价也很明确:复杂网格形变、大量像素级处理和高分辨率多层合成会逐渐挤占主线程。

因此当前选择是正确的 MVP 取舍,但不是终局。未来如果效果复杂度继续增长,应把高成本滤镜迁移到 WebGL2 / Shader,把可并行计算移入 Worker,并根据设备能力建立效果降级档位。

MediaPipe 只在需要时进入链路

背景替换需要知道哪些像素属于人像。FaceFizz 在浏览器中加载 MediaPipe ImageSegmenter 和本地 Selfie Segmenter 模型,不把摄像头帧发送给远程推理服务。

初始化时优先使用 GPU delegate;如果失败,再自动回退到 CPU。这比只写一条“使用 GPU”的理想路径更符合真实浏览器环境,因为不同设备、驱动和浏览器对 WebAssembly、SIMD 与 GPU 后端的支持并不一致。

人像分割也没有跟随每一次画面刷新运行。实时画面可以接近显示器刷新频率,但分割计算大约按 80ms 的间隔执行,最近一次遮罩会被复用于中间帧。这样把“画面渲染频率”和“AI 推理频率”分开,能够显著减少端侧模型对主线程和设备温度的压力。

视频帧 ───────────────→ 实时 Canvas 渲染
   └─ 每约 80ms → ImageSegmenter → 人像 Mask
                                  ↓
背景图片 + 原始画面 + Mask → 合成结果

这个方案仍有优化空间:遮罩边缘平滑、头发细节、低端设备推理延迟,以及自定义背景大图的内存占用,都需要通过真实设备数据继续调整。

隐私不是一句文案,而是资源生命周期

“本地处理”只有落实到代码边界才有意义。FaceFizz 当前的隐私策略包括:

  • 不要求账号,不建立云端作品库;
  • 摄像头帧、分割遮罩和拍照结果默认只存在于浏览器;
  • 用户按下快门后才生成 JPEG;
  • 只有用户主动点击保存,图片才进入本地文件;
  • 关闭相机时遍历 MediaStreamTrack 并调用 stop()
  • 同时取消动画帧并关闭 MediaPipe 实例,避免摄像头指示灯或推理任务继续运行。

这套边界也降低了后端复杂度:MVP 不需要存储人脸图片、不需要处理删除请求,也不需要为用户作品设计访问控制。隐私设计在这里不是合规完成后的附加项,而是直接减少了系统成本。

效果系统:类型安全先于插件化

当前代码为分类和效果建立了明确的联合类型,例如 CategoryIdEffectIdEffect,效果选择、名称、颜色、分类与多语言映射都能在 TypeScript 中检查。精选效果负责首屏体验,更完整的效果分类则进入选择器。

不过,当前实现仍集中在一个较大的客户端页面组件中,效果渲染也主要通过条件分支组织。它适合快速验证,但当模板、素材和多人玩法继续增长时,会出现三个问题:

  1. 新增效果需要修改核心页面;
  2. 素材、元数据和渲染算法耦合;
  3. 无法独立测试、按需加载和远程发布模板。

下一步更合理的演进是声明式效果协议:

type EffectTemplate = {
  id: string;
  version: number;
  category: "warp" | "sticker" | "frame" | "filter" | "background";
  preview: string;
  assets: string[];
  renderer: "canvas2d" | "webgl" | "segmentation";
  capture: { aspectRatio: "1:1" | "3:4" | "9:16" };
  capability: { webgl2?: boolean; segmentation?: boolean };
};

页面只负责状态和交互,渲染器负责执行效果,模板通过配置注册。这样才能把“开发一个效果”逐步变成“制作并发布一个模板”。

七种语言不是简单复制字符串

FaceFizz 支持简体中文、繁体中文、英语、日语、韩语、泰语和马来语。多语言不仅影响按钮文字,还会影响标题长度、卡片高度、移动端换行、字体回退和 SEO 元数据。

当前项目用类型化字典保存分类、效果名称和界面文案,并把语言选择保存在 localStorage。这种做法对一个单页产品足够轻,但继续增长时应拆分语言包、按语言懒加载,并增加缺失 key 检查和截图回归测试。

项目还提供结构化数据、Sitemap、robots.txtllms.txtllms-full.txt。它们不会替代产品质量,却让搜索引擎和 AI 检索系统更容易理解页面是什么、能做什么。

工程验证与当前不足

项目采用 React 19、TypeScript、Vinext、Vite、Tailwind CSS 4 和 MediaPipe Tasks Vision,通过 ESLint、构建检查以及渲染 HTML 测试保证基础质量。

但源码公开不等于工程已经完成。接下来最值得投入的是:

  • 把大型页面拆成相机控制、效果注册、渲染器和多语言模块;
  • 建立 Chrome、Safari 和移动设备的摄像头测试矩阵;
  • 记录相机启动成功率、首帧耗时、平均 FPS 和拍照成功率,但不采集原始画面;
  • 增加页面进入后台后的暂停与恢复策略;
  • 为低端设备提供关闭分割、降低画布尺寸等能力降级;
  • 增加键盘操作、焦点管理和屏幕阅读器验证。

我从这个项目得到的判断

第一,端侧 AI 的价值不只是在“节省 API 费用”。它还能缩短反馈链路、减少网络依赖,并建立更容易解释的隐私边界。

第二,实时产品不能只看功能是否可用。摄像头启动、首帧时间、渲染帧率、推理频率、设备温度和资源释放共同决定体验。

第三,MVP 不需要一开始拥有最先进的架构。Canvas 2D、单页状态和本地模型足以验证核心体验;但必须诚实记录规模增长后要拆分的边界。

第四,真正的北极星指标不是访问量,而是用户是否成功生成、保存或愿意分享一张照片。技术最终服务的,仍然是那个让人笑出来的瞬间。

在线体验与源码

许可证说明:截至 2026 年 8 月 11 日,仓库公开了源码,但 README 仍标注 “All rights reserved”,且没有独立的开源许可证。从严格定义看,它目前属于“公开源码”,还不是允许他人复制、修改和分发的正式开源项目。如果希望社区参与,需要补充 MIT、Apache-2.0 等明确许可证。

28 / 41

我在 Homebrew Redis 8.10.0 中发现了一个打包问题

一次 Redis 本地启动失败的排查记录:默认配置启用了四个模块,但 Homebrew bottle 中没有对应动态库。
2026/08/11 · 4 分钟阅读

最近我通过 Homebrew 安装 Redis 8.10.0,用于本地开发:

brew install redis
brew services start redis

安装过程没有报错,Homebrew 也提示服务已经启动,但 brew services list 中 Redis 的实际状态却是:

redis  error  1

这不是 Redis 本身无法运行,而是 bottle 中的默认配置和实际文件不一致。我已经将问题提交到 Homebrew: Homebrew/homebrew-core#296698。截至 2026 年 8 月 11 日,Issue 仍处于 Open 状态。

问题在哪里

bottle 提供的 redis.conf 默认启用了四个模块:

loadmodule ./modules/redisbloom/redisbloom.so
loadmodule ./modules/redisearch/redisearch.so
loadmodule ./modules/redisjson/rejson.so
loadmodule ./modules/redistimeseries/redistimeseries.so

但检查安装目录后,没有找到任何对应的 .so.dylib 文件。Redis 启动时读取这些指令,无法加载不存在的模块,于是直接退出。

这类故障容易产生误导:包管理器显示“Successfully started”,只代表服务管理命令已经提交,不代表 Redis 进程最终健康运行。

如何确认

我分别检查了配置和安装产物:

grep -n "loadmodule.*modules" \
  /opt/homebrew/Cellar/redis/8.10.0/.bottle/etc/redis.conf

find /opt/homebrew/Cellar/redis/8.10.0 \
  -type f \( -name "*.so" -o -name "*.dylib" \)

第一条命令能够看到四条已启用的 loadmodule,第二条命令却找不到模块动态库。配置声明与实际产物不一致,这就是问题的直接证据。

临时处理

如果本地开发并不依赖这些模块,可以暂时注释对应配置,再重启 Redis:

sed -i '' \
  -e 's|^loadmodule ./modules/|#loadmodule ./modules/|' \
  /opt/homebrew/etc/redis.conf

brew services restart redis
redis-cli ping

恢复后,redis-cli ping 返回:

PONG

这只是临时绕过,不是上游正式修复。如果业务依赖 RedisBloom、RediSearch、RedisJSON 或 RedisTimeSeries,就不能简单禁用它们,而应等待 Homebrew 修正 bottle,或采用明确包含所需模块的安装方案。

这次排查带来的提醒

遇到服务启动失败时,不要只重复执行安装和重启命令。更有效的排查顺序是:

  1. 检查服务的真实状态和退出码;
  2. 以前台方式启动,读取直接错误;
  3. 对照配置声明与安装产物;
  4. 做最小修改验证因果关系;
  5. 整理可复现步骤并反馈给上游。

开源贡献不一定从提交代码开始。一份边界清楚、证据完整、能够稳定复现的 Bug 报告,同样可以帮助维护者更快定位问题。

参考

29 / 41

从 0 到 1 构建招聘领域大模型:以 BOSS 直聘类场景为例

招聘大模型不是给聊天机器人接一个 API。本文从业务目标、招聘数据治理、领域继续预训练、SFT 与 DPO、RAG、人才匹配、评测、安全合规到 12 周落地计划,给出一套可复现的开源工程方案。
2026/08/10 · 27 分钟阅读

如果让我从零开始,为一家类似 BOSS 直聘的招聘平台建设大模型,我不会先买 GPU,也不会先讨论做 7B、32B 还是 100B。

我会先问三个问题:

  1. 模型要改善哪一个业务结果?
  2. 我们拥有什么合法、独有、可以验证的数据?
  3. 哪些问题应该交给大模型,哪些仍然应该由搜索、推荐和规则系统完成?

招聘业务最容易犯的错误,是把“建设行业大模型”理解成训练一个会聊天的模型。真正可用的系统,不是一颗模型,而是一套由数据、检索、匹配、生成、风控、评测和人工决策共同组成的系统。

先说明边界:公开备案信息显示,BOSS 直聘运营主体的“南北阁”于 2024 年完成生成式人工智能服务备案,备案号为 Beijing-NanBeiGe-20240102。但它的完整数据配方、训练流程与内部架构并未公开。国家互联网信息办公室备案公告

因此,本文不是对 BOSS 直聘内部系统的还原,而是以“BOSS 直聘类平台”为业务案例,给出一套基于开源技术、可以真正落地的参考架构。

先纠正“从 0 训练”的理解

从随机参数开始预训练一个通用基础模型,需要数万亿 Token、长期集群调度、分布式训练能力和极高算力投入。对于绝大多数招聘平台,这不是合理的第一步。

更务实的“从 0 到 1”是:

开源基础模型
    ↓
招聘领域继续预训练(可选)
    ↓
招聘任务 SFT
    ↓
偏好优化与安全对齐
    ↓
RAG、工具调用和匹配系统
    ↓
离线评测、灰度发布和反馈闭环

这里的“自研”不一定意味着从随机权重开始。企业真正应该拥有的是领域数据、训练配方、评测集、服务架构和反馈闭环。

只有当企业同时具备海量合法语料、稳定算力、成熟训练团队,并且开源模型在 Tokenizer、语言覆盖或核心能力上存在无法修补的缺陷时,才值得讨论从头预训练。

第一步:把业务目标写成可以评测的任务

招聘平台同时服务求职者和招聘者,两边目标并不相同。

求职者关心:

  • 哪些职位真正适合我;
  • JD 中哪些要求是硬条件;
  • 简历哪里表达不清楚;
  • 如何与招聘者进行有效沟通;
  • 岗位、公司与薪资信息是否可信。

招聘者关心:

  • 如何把模糊需求写成清晰 JD;
  • 如何快速发现合适候选人;
  • 候选人的技能是否与岗位匹配;
  • 如何减少无效沟通;
  • 如何识别虚假简历、虚假岗位和异常账号。

第一版不要同时解决全部问题。我会选择三个可衡量场景:

场景模型输出首要指标
JD 结构化与改写标准职位、技能、经验、学历、地点、薪资与规范化 JD字段 F1、事实保真率、发布采纳率
简历—岗位匹配解释匹配点、缺口、证据和不确定性Recall@K、NDCG、解释证据准确率
招聘对话助手基于岗位与履历生成问题、回复和下一步建议回复率、人工采纳率、安全违规率

不要一开始就把“招聘成功率”作为单一指标。录用结果延迟长,还受薪资、地点、公司品牌、招聘者行为和宏观环境影响。第一阶段需要同时观察模型质量指标、过程指标和最终业务指标。

第二步:把系统拆开,不让 LLM 包办一切

招聘平台的核心不是一个万能聊天框,而是分层系统:

                         ┌──────────────────────────┐
求职者 / 招聘者 ───────→ │ 对话、搜索、推荐、内容生成 │
                         └────────────┬─────────────┘
                                      ↓
                         ┌──────────────────────────┐
                         │ 任务路由与安全策略层       │
                         │ 意图 / 权限 / 风险 / 成本  │
                         └──────┬─────────┬─────────┘
                                │         │
                 ┌──────────────┘         └──────────────┐
                 ↓                                         ↓
      ┌──────────────────────┐                  ┌──────────────────────┐
      │ 招聘领域 LLM          │                  │ 匹配与排序系统         │
      │ 抽取 / 生成 / 解释    │                  │ 双塔召回 / 精排 / 重排 │
      └──────────┬───────────┘                  └──────────┬───────────┘
                 ↓                                         ↓
      ┌──────────────────────┐                  ┌──────────────────────┐
      │ RAG 与业务工具        │                  │ 特征与向量平台         │
      │ 职位库 / 公司库 / API │                  │ 用户 / 岗位 / 行为     │
      └──────────┬───────────┘                  └──────────┬───────────┘
                 └──────────────────┬──────────────────────┘
                                    ↓
                         ┌──────────────────────────┐
                         │ 数据治理、评测、审计与反馈 │
                         └──────────────────────────┘

LLM 适合做语义理解、信息抽取、内容生成、复杂解释与工具编排;它不适合独自承担亿级候选集的低延迟召回,也不应该直接做不可解释的自动淘汰。

一个成熟方案通常是:

  • 搜索和双塔模型负责从海量岗位或人才中召回;
  • 精排模型融合语义、行为、时效性和业务约束;
  • LLM 负责理解自然语言条件、补全结构化特征、解释结果与完成对话;
  • 规则与安全模型负责硬约束、权限、反欺诈和合规;
  • 人最终决定是否投递、沟通、面试或录用。

一套最小可用的开源技术栈

不要为了“全开源”堆十几个框架。第一版每层保留一个主要实现和一个可替换接口:

第一版选择关键输出
数据处理Python/SQL + DataTrove 或 Spark版本化 Parquet、数据卡、血缘
训练PyTorch + LLaMA-Factory/TRL,规模扩大后接 FSDP 或 DeepSpeedAdapter/Checkpoint、训练指标
向量与关键词检索OpenSearch,或 PostgreSQL + pgvector 起步可过滤的候选集与证据
Embedding/Reranker开放权重的中英双语 Embedding + Cross-Encoder向量、相关性分数
推理vLLM 或 SGLangOpenAI-compatible API
实验与评测MLflow + 自建黄金集与回归脚本数据、模型、Prompt、指标版本

组件名称不是重点,接口才是。训练样本、Embedding、检索结果、模型输出和评测结果都要带 dataset_versionmodel_versionprompt_versiontrace_id,否则线上错误无法回溯。

第三步:先建立招聘领域本体

没有统一语义,训练数据越多,冲突越多。

例如“Java 高级开发”“后端研发工程师”“服务端工程师”和“高级 Java 工程师”可能指向同一职业族;“熟悉大模型”可能意味着会调用 API,也可能要求训练、评测或推理优化。

我会先建立一套版本化的招聘本体:

职业族 → 标准职位 → 专业方向 → 技能 → 熟练度
                                   ├─ 必须 / 加分
                                   ├─ 使用年限
                                   └─ 最近使用时间

岗位 → 行业 → 公司阶段 → 地点 → 工作方式 → 薪资区间

候选人 → 经历 → 项目 → 责任 → 行为 → 结果 → 证据

本体不是让所有公司使用同一种职位名称,而是为搜索、训练和评测建立共同坐标系。每个映射都要保留原文、标准值、置信度和版本,避免模型把不确定推断写成事实。

一个 JD 结构化样本至少应该包含:

{
  "source_text": "招聘高级后端,5年以上,熟悉Java和微服务,有大模型经验优先",
  "job_family": "软件研发",
  "normalized_title": "高级后端开发工程师",
  "required_skills": ["Java", "微服务"],
  "preferred_skills": ["大语言模型"],
  "experience_min_years": 5,
  "evidence": {
    "experience_min_years": "5年以上",
    "required_skills": ["熟悉Java和微服务"]
  },
  "confidence": 0.96,
  "ontology_version": "job-ontology-2026-08"
}

关键不是 JSON,而是 evidence。招聘领域的模型输出必须能回到原始证据。

第四步:建立合法、可追溯的数据资产

招聘数据比普通网页数据敏感得多。简历可能包含姓名、联系方式、教育经历、工作经历、地理位置和期望薪资;聊天记录还可能包含家庭情况、健康信息和其他私密内容。

我会把数据分为四层:

数据层典型内容主要用途
公共知识职业分类、公开技能文档、劳动法规、公开公司信息领域知识与 RAG
平台业务数据获得授权的 JD、脱敏简历、搜索与交互继续预训练与匹配
专家标注数据职位标准化、技能证据、匹配判断、优劣回答SFT、偏好优化、评测
在线反馈数据采纳、修改、回复、投递、面试及投诉迭代与效果验证

每条数据必须带上:

  • 来源与授权依据;
  • 采集和处理时间;
  • 数据负责人;
  • 敏感等级;
  • 可用任务范围;
  • 清洗和脱敏版本;
  • 保留期限与删除状态。

不能因为数据在平台数据库里,就默认可以用于训练。产品使用、推荐、风控和模型训练是不同处理目的,需要分别审查授权基础和最小必要范围。

招聘数据清洗流水线

数据源登记与权限审查
        ↓
解析 JD、简历、聊天与行为日志
        ↓
删除模板噪声、广告、联系方式诱导和异常字符
        ↓
语言、职位、行业与内容类型识别
        ↓
PII 检测、字段化、令牌化替换与隔离映射
        ↓
精确去重、简历版本去重、JD 模板近似去重
        ↓
虚假、低质、歧视性和冲突内容检测
        ↓
质量评分与证据完整性检查
        ↓
按时间、用户和公司隔离训练 / 验证 / 测试集
        ↓
数据卡、版本号与审计记录

脱敏不能只用正则。邮箱和手机号适合规则,姓名、学校、公司项目、地址和自由文本中的身份线索还需要 NER、词典、模型检测和抽样复核。

训练集切分也不能随机按行切。一个人的多份简历、一个公司的模板 JD 或同一次对话如果跨越训练集和测试集,评测结果会虚高。应按用户、企业和时间进行分组隔离,并建立公开基准污染检查。

第五步:选择开源基础模型,而不是只看榜单

中文招聘场景可以从 Qwen、GLM、Llama 等开放权重模型中选择候选。Qwen 官方生态支持 Transformers、vLLM、SGLang 等推理方式,也可配合 LLaMA-Factory、TRL、Axolotl 等进行 SFT 和偏好优化。Qwen 官方仓库

选择时我会关注:

  1. 许可证:是否允许目标商业用途和模型衍生;
  2. 中文与中英混合能力:职位名、技术栈和公司描述经常混合语言;
  3. 结构化输出:JSON Schema 遵循和字段稳定性;
  4. 长上下文:能否处理完整简历、JD 与对话,但不要只看标称长度;
  5. 工具调用:参数正确率、失败恢复和权限边界;
  6. 部署成本:目标并发下的 TTFT、TPOT、吞吐与显存;
  7. 领域基线:在自建招聘评测集上的真实表现。

第一版通常从 7B~14B 级别的模型开始更合理。先证明数据和任务有效,再决定是否升级更大模型。模型越大,不代表每一个抽取和分类任务都更好;许多稳定任务可以蒸馏给小模型。

Tokenizer 也需要评估。统计真实中文 JD、简历和技术词汇的平均字符/Token、截断率和特殊术语切分。如果效率可以接受,不要轻易修改词表;增加 Token 会改变 Embedding 与训练兼容性,收益必须通过实验验证。

第六步:分阶段训练,而不是一次把所有数据倒进去

阶段 A:领域继续预训练(CPT,可选)

CPT 用大量未标注招聘文本,让基础模型熟悉职位表达、技能关系、职业路径和招聘语言。

适合的数据包括:

  • 获得授权且去重后的高质量 JD;
  • 脱敏职业介绍与技能文档;
  • 公开劳动法规和招聘规范;
  • 高质量行业资料;
  • 严格授权、脱敏并过滤后的业务文本。

不要直接把所有聊天和简历投入 CPT。先做 PII、安全、质量、重复和配比治理。训练时混入一定比例的通用数据,降低领域灾难性遗忘,并通过小规模消融决定是否值得做 CPT。

如果基础模型已经很好、领域语料规模有限,直接做 SFT + RAG 往往性价比更高。

CPT 的目标仍是下一个 Token 的交叉熵:

L_CPT = -Σ log Pθ(x_t | x_<t)

工程上需要控制四件事:

  • 数据混合:先用多个候选比例做小实验,例如领域数据与通用数据从 3:7、5:5、7:3 扫描,而不是把某个比例当定律;
  • 文档边界:Sequence Packing 可以提高 GPU 利用率,但 Attention 不能跨文档泄漏;
  • Token 预算:用“有效 Token 数 × 每 Token 训练成本”估算,而不是只看文件大小;
  • 停止条件:同时观察领域验证集 Loss、通用能力回归和目标任务指标,不能只等训练 Loss 下降。

每个 Checkpoint 都记录数据 Manifest、代码提交、随机种子、优化器状态和样本混合比例。领域 Loss 下降但通用评测明显退化,说明模型正在遗忘,不是训练成功。

阶段 B:监督微调(SFT)

SFT 用来教模型完成明确任务和遵守输出契约。数据应该覆盖:

  • JD 与简历结构化;
  • 技能和经历证据抽取;
  • 搜索条件解析;
  • 匹配解释与缺口分析;
  • JD 改写与简历表达建议;
  • 招聘对话与工具调用;
  • 信息不足时澄清和拒答;
  • 安全、隐私与公平场景。

一条高质量 SFT 样本不是只有问题和答案,还应包含任务类型、输入来源、证据、允许工具、标准答案、风险标签和数据版本。

{
  "messages": [
    {"role": "system", "content": "你是招聘助手。只能根据给定简历和岗位回答,不得推断年龄、婚育或健康情况。"},
    {"role": "user", "content": "请分析候选人与岗位的匹配点和缺口。\n[岗位]...\n[简历]..."},
    {"role": "assistant", "content": "{\"matched\":[...],\"gaps\":[...],\"unknown\":[...],\"evidence\":[...]}"}
  ],
  "task": "job_candidate_explanation",
  "risk_tags": ["employment", "personal_information"],
  "dataset_version": "recruit-sft-2026-08"
}

使用 LoRA 或 QLoRA 可以快速验证方向,LLaMA-Factory 已支持继续预训练、SFT、DPO 等流程。LLaMA-Factory

model_name_or_path: Qwen/Qwen3-8B
stage: sft
do_train: true
finetuning_type: lora
lora_target: all
dataset: recruitment_sft
template: qwen3
cutoff_len: 4096
learning_rate: 1.0e-4
num_train_epochs: 2.0
bf16: true
val_size: 0.05
llamafactory-cli train recruitment_sft.yaml

这只是起点,不是可直接复制的最优参数。学习率、轮数、序列长度、LoRA Rank 和数据配比,都要通过验证集与消融实验决定。

SFT 还有几个经常被忽略的细节:

  • Loss 通常只计算 Assistant 输出 Token,避免让模型学习复述 System 与 User;
  • 长短样本分桶并做 Packing,减少 Padding,但必须保留会话边界;
  • 结构化任务同时评估 Token Loss 和 JSON/Schema 正确率,两者不一定同步;
  • LoRA 可以先从 Rank 16 或 32、Attention 与 MLP 线性层起步,再通过消融扩大;
  • 保存一个完全未参与 Prompt 调试的盲测集,防止团队把评测集“调熟”。

全量微调是否优于 LoRA,取决于数据规模、任务跨度和算力。第一版先用 LoRA 证明数据有效;当 Adapter 容量成为明确瓶颈,再对相同数据做全参对照,而不是凭感觉升级。

阶段 C:偏好优化

当模型已经会完成任务,但回答风格、证据忠实度或拒答边界不稳定时,再构建偏好数据。

同一个输入准备 chosenrejected

  • 有证据的匹配解释优于无依据判断;
  • 明确“不知道”优于编造候选人经历;
  • 中性、能力相关的表达优于包含年龄、性别或婚育暗示的表达;
  • 简洁可执行的建议优于空洞长文;
  • 正确工具调用优于直接生成实时岗位信息。

DPO 比传统 RLHF 更容易作为第一版工程方案;TRL 已提供 SFT、DPO、奖励建模和其他后训练工具。Hugging Face TRL

不要因为 GRPO 流行就使用它。只有当任务有可靠、可计算的奖励,例如 JSON Schema、SQL 执行、代码测试或规则验证时,强化学习才更容易获得稳定收益。主观招聘判断不能只交给一个奖励模型。

DPO 直接拉大同一输入下优选回答与拒绝回答的相对概率:

L_DPO = -log σ(β[(log πθ(y+|x)-log πref(y+|x))
                 -(log πθ(y-|x)-log πref(y-|x))])

这里 β 控制偏离参考模型的强度。实际训练要按任务、长度和风险分桶,检查“偏好提升”是否只是让答案变长。招聘专家之间意见不一致的样本,不应强行制造唯一标签,应保留多标注者分布或进入人工复核。

第七步:实时事实用 RAG,业务动作走工具

岗位状态、薪资、公司信息和招聘进度会不断变化,不能期待模型参数保存实时事实。

RAG 的知识源可以包括:

  • 当前有效岗位与版本记录;
  • 公司认证信息和公开介绍;
  • 职业与技能知识库;
  • 平台规则、隐私说明和劳动法规;
  • 用户有权访问的简历与沟通记录。
用户问题
   ↓
意图识别与权限检查
   ↓
结构化过滤(地点、薪资、经验、状态)
   ↓
混合检索(关键词 + 向量)
   ↓
Reranker 精排
   ↓
证据压缩与来源标记
   ↓
LLM 生成或调用业务工具
   ↓
事实、权限与安全校验

招聘检索不能只有向量相似度。地点、薪资、经验、学历要求、岗位状态和权限是硬过滤条件;语义检索负责理解“AI 平台研发”和“LLM Infra”等表达差异;Reranker 再对少量候选进行精排。

不要直接相加 BM25 与向量分数,它们通常不在同一尺度。第一版可以用 Reciprocal Rank Fusion:

RRF(d) = Σ 1 / (k + rank_i(d))

先分别取得关键词与向量 Top-K,再按名次融合,最后把前 50~200 条交给 Cross-Encoder。索引按 tenant_id、岗位状态、地点、薪资和更新时间做服务端过滤;权限过滤必须发生在上下文进入 LLM 之前,而不是生成后再遮盖。

投递简历、发送消息、修改 JD 等写操作必须通过工具完成,并具备:

  • 明确参数 Schema;
  • 服务端重新鉴权;
  • 幂等键;
  • 预览与用户确认;
  • 超时、重试和失败补偿;
  • 完整审计日志。

模型可以建议动作,但不能绕过业务权限直接操作。

第八步:匹配系统要单独训练

招聘平台的海量岗位匹配,本质上仍是推荐与搜索问题。

第一阶段使用双塔模型:候选人塔编码简历与行为,岗位塔编码 JD 与企业特征,向量索引用于快速召回。随后使用 Cross-Encoder 或学习排序模型做精排,最后结合多样性、时效性、已读去重和业务约束进行重排。

候选人画像 ─→ Candidate Tower ─┐
                                ├─ 向量相似度 → ANN Top-K 召回
岗位画像   ─→ Job Tower ───────┘
                                      ↓
                         Cross-Encoder / Learning-to-Rank
                                      ↓
                      规则、时效、多样性与公平约束重排
                                      ↓
                              LLM 生成匹配解释

LLM 可以生成训练弱标签、补充语义特征和解释结果,但不要让它逐个遍历几百万岗位。

训练标签也不能简单定义成“点击就是正样本”。职位曝光受旧模型控制,点击受标题和薪资吸引,沟通受招聘者活跃度影响。可以构建分层标签:曝光、点击、收藏、投递、回复、约面、面试和录用,并考虑位置偏差、负采样和延迟反馈。

双塔可以用对比学习训练。对一个候选人向量 u、正岗位 v+ 和批内岗位集合,常见目标是:

L_retrieval = -log exp(sim(u,v+)/τ) / Σ_j exp(sim(u,v_j)/τ)

随机负样本太简单,模型学不到岗位之间的细微差别;应加入同职位不同级别、同技能不同地点等难负样本。但曝光过且未点击不一定代表不合适,可能只是位置太低;从线上日志挖负样本时要记录曝光位置,并过滤潜在假负例。

精排输入可以组合语义交叉特征、结构化匹配、时效性和行为统计。LLM 生成的匹配解释只能读取最终排序所使用的事实特征与原文证据,避免“排序依据是一套,解释又编一套”。

第九步:评测集应该先于大规模训练

没有自建评测集,就无法知道领域训练是否真的有效。

生成与理解评测

能力指标
字段抽取Precision、Recall、F1、Schema Valid Rate
JD 改写事实保真、完整性、违规率、人工采纳率
匹配解释证据准确率、遗漏率、无依据断言率
RAG 问答Recall@K、引用正确率、Groundedness、拒答准确率
工具调用参数正确率、执行成功率、越权率、重复执行率
安全合规PII 泄露率、歧视表达率、Prompt Injection 成功率

匹配与排序评测

  • Recall@K:合适岗位是否进入召回集合;
  • MRR / NDCG@K:合适结果是否排在前面;
  • 覆盖率:长尾岗位和新人是否获得机会;
  • 校准度:匹配分数是否与真实成功概率一致;
  • 分群差异:不同地区、职业、经验段的效果是否异常;
  • 在线指标:有效沟通率、回复率、投递率、面试率与投诉率。

测试集必须按时间冻结,训练数据不得包含未来反馈。公开榜单只能衡量通用能力,不能替代招聘领域评测。

上线采用影子流量和小比例灰度,先让模型生成但不影响用户,再与现网结果对比。只有安全门禁、质量指标和延迟成本同时达标,才逐步扩大流量。

第十步:部署不是启动一个 vLLM 就结束

vLLM、SGLang 等开源推理引擎可以提供高吞吐服务,但生产架构还需要模型网关、队列、缓存、降级与观测。vLLM 官方项目

API Gateway
   ↓
身份、配额、内容长度与风险检查
   ↓
任务路由
   ├─ 小模型:分类、抽取、改写
   ├─ 大模型:复杂分析与对话
   ├─ Embedding / Reranker:检索匹配
   └─ 规则服务:硬约束与安全
   ↓
批处理、KV Cache、超时与熔断
   ↓
结构校验、引用校验与内容安全
   ↓
日志、Trace、成本与质量采样

需要持续观测:

  • 首 Token 延迟、每 Token 延迟与总延迟;
  • 输入输出 Token、GPU 利用率与单次任务成本;
  • 排队时间、超时、取消、重试和降级率;
  • JSON 解析失败、工具失败和无依据回答;
  • 按模型、任务、语言和版本拆分的质量指标。

模型升级不是替换一个文件。Prompt、Tokenizer、RAG、工具 Schema、量化方式和推理参数都可能改变结果,必须一起版本化。

容量规划可以先用一个简单近似:

所需副本数 ≈ 峰值 QPS × P95 服务时间
             ÷ 单副本安全并发 × 余量系数

然后用真实输入长度和输出长度压测修正。至少分别压测短抽取、长简历分析和多轮对话;平均 Token 长度会掩盖长尾 OOM。部署前比较 BF16、FP8/INT8 和低比特量化在招聘黄金集上的回归,不能只比较吞吐。

招聘场景最重要的安全线

招聘不是普通内容生成。一个错误推荐可能浪费时间,一个不透明的淘汰决策可能影响人的职业机会。

《个人信息保护法》第二十四条要求,利用个人信息进行自动化决策时,应保证决策透明度和结果公平、公正。《中华人民共和国个人信息保护法》

工程上至少要做到:

  1. 不把性别、年龄、民族、婚育、健康等信息作为未经合法论证的匹配特征;
  2. 检查学校、地址、职业中断等代理变量造成的间接偏差;
  3. 不让 LLM 单独作出录用或淘汰决定;
  4. 为重要推荐提供基于岗位和履历证据的解释;
  5. 提供人工复核、纠错、退出个性化推荐和申诉通道;
  6. 将简历访问权限落实到检索、Prompt、日志和缓存每一层;
  7. 对训练数据、模型版本、Prompt 和工具调用保留审计链;
  8. 面向公众提供生成式服务前,完成适用的安全评估、算法备案或大模型登记评估。

“模型没有使用姓名”并不等于公平。学校、邮编、工作年份和表达风格都可能成为身份代理。公平评测必须按合法且必要的分群做差异分析,并由法务、伦理、招聘专家与算法团队共同审查。

一套可以执行的 12 周路线

周期目标可交付结果
第 1~2 周定义任务与基线三个场景、黄金评测集、现网基线、合规清单
第 3~4 周数据与本体招聘本体 v1、数据血缘、脱敏流水线、训练集 v1
第 5~6 周开源模型 PoC3 个基础模型横评、LoRA SFT、错误分类报告
第 7~8 周RAG 与匹配混合检索、Reranker、双塔召回基线、证据引用
第 9~10 周偏好与安全DPO 数据、安全集、红队测试、权限与审计
第 11 周影子与灰度线上影子流量、延迟成本报告、1%~5% 灰度
第 12 周复盘与决策业务增益、质量回归、是否扩大训练和模型规模

第一个版本的通过条件应该提前写清楚,例如:

  • 结构化抽取 F1 达到既定门槛;
  • JSON 有效率超过内部要求;
  • 匹配解释的无依据断言率低于红线;
  • PII 与越权测试零严重事故;
  • P95 延迟和单次成本满足预算;
  • 线上采纳或有效沟通指标相对基线有统计显著提升。

具体阈值必须根据业务基线确定,不应该从别人的文章里复制。

最容易失败的七种方式

  1. 先训练,后找场景:最后只有一个演示聊天框,没有业务指标。
  2. 把数据库当训练授权:忽略简历、对话和行为数据的处理目的与权限。
  3. 随机切分数据:同一用户或模板泄漏到测试集,制造虚假高分。
  4. 只做 LLM,不做召回排序:成本高、延迟大,也无法处理海量候选集。
  5. 只看通用榜单:模型会做数学题,却无法稳定抽取薪资和技能证据。
  6. 用线上点击直接当真相:把旧推荐系统的位置偏差继续训练进新系统。
  7. 让模型自动淘汰候选人:缺少证据、解释、人工复核与公平性控制。

最后的判断

招聘领域大模型真正的壁垒,不是把一个开源模型换成自己的名字,也不是训练参数越多越好。

它的壁垒来自:

  • 能否建立一致、持续演进的职位与技能本体;
  • 能否在合法授权下治理高质量招聘数据;
  • 能否把搜索、推荐、LLM、RAG 和规则放在正确位置;
  • 能否用真实业务结果和安全指标共同评测;
  • 能否把失败案例、人工修改和最终结果重新变成数据。

如果这五件事没有做好,自研模型只是昂贵的聊天机器人。

如果这五件事形成闭环,即使第一版只使用一个 7B~14B 的开源模型,也可能创造真实价值。

从 0 到 1 构建招聘大模型,不是从 0 写出 Transformer,而是从 0 建立一套能够把招聘知识、业务数据、模型能力和真实结果连接起来的系统。

参考资料

30 / 41

大模型的护城河,不只是代码,而是数据

当 Transformer、训练框架与开源权重逐渐普及,真正稀缺的是什么?从 Llama 3、Phi-1、LIMA 到生产级数据流水线,重新理解数据质量、配比、合成数据与评测闭环。
2026/08/10 · 16 分钟阅读

现在再去看大模型的代码,会发现它已经没有几年前那么神秘。

Transformer 是公开的,Attention 是公开的,预训练、SFT、偏好优化、量化和推理服务都有成熟的开源实现。PyTorch、Hugging Face、DeepSpeed、Megatron-LM、TRL 和 vLLM,已经把许多过去只有大厂才能完成的工作变成了可以复用的工程组件。

今天,一个有经验的团队搭出一个“能够训练、能够微调、能够推理”的模型,门槛确实降低了。

但能把模型跑起来,不等于能训练出一个真正有用的模型。

我越来越明确的一个判断是:

当模型结构逐渐趋同、训练代码逐渐开源以后,大模型真正的竞争,正在从“会不会写模型”转向“有没有数据、数据质量如何,以及能不能建立持续改进数据的闭环”。

这不是说算法、算力和工程不重要。恰恰相反,前沿模型仍然需要复杂的分布式训练、稳定性治理、优化策略、评测体系和大量算力。只是基础代码已经越来越容易获得,而高价值数据及其生产系统,依然很难复制。

参数决定容量,数据决定学到什么

机器学习里有一句最朴素的话:

Garbage in, garbage out。垃圾进,垃圾出。

大模型不会像人一样,先判断一段文字是否真实,再决定要不要学习。预训练的核心任务仍然是根据上下文预测后续 Token。只要一种模式在数据中反复出现,模型就可能把它写进参数。

如果训练集中充满 SEO 拼接文章,模型就会学会流畅但空洞的表达;如果代码集中有大量重复仓库、过时依赖和错误实现,模型就可能更加自信地生成不安全代码;如果医疗、法律或金融材料本身有误,扩大参数量也不会自动把错误变成事实。

但“数据决定模型上限”还可以说得更准确:

参数规模决定模型能够容纳多少模式,数据决定它主要接触什么模式,算法与优化决定它能否有效吸收这些模式,评测则决定团队是否真的知道模型学会了什么。

模型能力不是单一变量的结果。架构、算力、Tokenizer、训练目标、数据、后训练和推理策略共同作用。数据的重要性在于,它规定了模型可以学习的经验边界。

数据质量,不只是把脏数据删掉

很多人把数据质量理解成删除乱码、广告、色情内容和重复文本。这只是最基础的一层。

对大模型而言,质量至少包括五个维度:

维度需要回答的问题
正确性事实是否可靠,代码是否能够编译和通过测试?
多样性是否覆盖不同语言、领域、任务、观点和表达方式?
代表性数据分布是否接近模型未来面对的真实场景?
安全与合规是否包含隐私、密钥、有害内容或许可证风险?
可学习性内容是否完整、清晰、有结构,并具有足够的信息密度?

一份没有脏话、格式整齐的数据,不一定是高质量数据。如果所有样本都在重复同一种观点,它仍然会训练出一个能力狭窄、偏差明显的模型。

因此,质量与数量不是简单对立。通用模型仍然需要规模来获得覆盖面,而高质量决定这些 Token 是否值得消耗训练算力。

不要给未公开的数据配比编数字

训练数据的具体组成,通常是模型团队最重要的秘密之一。

以 Llama 3 为例,Meta 公开确认的是:预训练数据超过 15T Token,全部来自公开来源;训练集规模约为 Llama 2 的七倍,代码数据约为 Llama 2 的四倍,高质量非英语数据超过 5%,覆盖三十多种语言。Meta 还披露了启发式过滤、NSFW 过滤、语义去重和质量分类器等方法,并通过大量实验决定最终数据混合比例。Meta 官方说明

但是,Meta 并没有公开“Common Crawl 50%、GitHub 17%、Books 与 ArXiv 10%”这样的完整配比。

所以更严谨的写法应该是:大型语言模型的训练集通常会包含网页、代码、书籍、论文、百科、问答和多语言语料;具体比例取决于模型的目标能力,不能把行业猜测写成某个模型的官方数字。

这件事本身也说明:

模型架构可以写进论文,数据配方却常常构成真正的商业机密。

Phi-1 证明的是数据效率,不是小模型全面胜利

微软的 Phi-1 经常被用来说明数据质量的重要性,但它的结论也经常被夸大。

Phi-1 有 1.3B 参数,使用约 6B Token 的筛选代码数据,以及约 1B Token 的合成教材和练习进行训练。它在 HumanEval 和 MBPP 等代码基准上取得了很强的成绩。《Textbooks Are All You Need》

它真正证明的是:

在目标明确、结果可验证的领域,高信息密度的数据和良好的教学顺序,可以显著提高训练效率。

它没有证明 1.3B 模型能够在所有通用能力上全面超过 7B 模型。代码能力、世界知识、多语言、长文本和写作是不同维度,不能用一个代码榜单替代全部能力。

这个区别非常重要。数据质量不是魔法,它不能绕过任务范围,也不能凭空补充训练集中不存在的知识。

LIMA 证明的是少而精,不是“1000 等于 52000”

LIMA 使用 1,000 条精心挑选的提示与回答,对一个已经完成大规模预训练的 65B LLaMA 模型进行监督微调,展示了很强的指令跟随能力。LIMA 论文

这里的前提不能忽略:基础模型已经通过预训练获得了大量知识。SFT 主要是在教它如何组织、调用和表达这些能力。

因此,LIMA 更准确的启示是:

对一个能力已经形成的基础模型,少量高质量、覆盖合理的指令数据,可能比大量粗糙、重复的指令数据更有效。

它并不意味着任何 1,000 条人工数据都等价于 52,000 条 Alpaca,也不意味着企业只标 1,000 条数据就一定足够。模型基础能力、任务边界、样本覆盖和评测标准都会改变结果。

一条生产级数据流水线应该是什么样

真正的大模型数据工程,不是运行一次清洗脚本,而是一套可以追踪、复现、评估和持续迭代的数据生产系统。

数据源登记与许可证审查
        ↓
采集、解析与格式标准化
        ↓
正文提取与文档结构恢复
        ↓
语言、领域与内容类型识别
        ↓
规则过滤与异常检测
        ↓
质量模型打分与分层抽样
        ↓
精确去重、近似去重与跨源去重
        ↓
PII、密钥、安全与合规处理
        ↓
训练集与评测集污染检测
        ↓
数据配比、课程编排与 Token 预算
        ↓
小规模消融实验
        ↓
能力、安全、偏差与回归评测
        ↓
版本化发布

这个顺序不是绝对固定的。例如,精确去重可以提前降低后续计算成本;质量感知去重则需要先评分,再从重复样本中保留质量最高的版本。最佳实践不是死记步骤,而是保证每个阶段都有输入、输出、指标和可追溯记录。

1. 先治理来源,再开始清洗

每一批数据都应该记录来源、采集时间、许可证、用途限制、语言、领域和处理历史。

如果不知道数据从哪里来,就无法处理版权争议、隐私删除、污染定位和训练复现。企业真正需要的不是一个装满文件的对象存储,而是一份数据资产目录和数据血缘。

2. 解析质量决定后续上限

网页中的菜单、广告、推荐链接、Cookie 提示和评论,可能比正文还多。PDF 还会出现页眉页脚重复、双栏顺序混乱、表格错位和 OCR 错误。

如果解析阶段已经破坏了语义结构,后续模型再强也只是在清洗一堆排列错误的字符。数据工程的第一步,是尽可能恢复原始内容的文档边界和结构。

3. 语言识别不能只有 fastText

fastText 可以作为基础工具,但短文本、方言、低资源语言以及代码与自然语言混合内容都可能误判。

生产环境通常需要把语言模型、字符规则、来源信息和人工抽样结合起来,并对不同语言分别设定质量阈值。用一套英语规则过滤所有语言,往往会系统性删除最稀缺的多语言数据。

4. 困惑度不是质量的同义词

KenLM 困惑度、启发式规则和分类器都很有用,但没有一个分数可以单独代表质量。

困惑度很高,可能是乱码,也可能是专业术语、新知识或低资源语言。阈值过于激进,会把最稀缺的内容一起删掉。

更可靠的方式是多信号联合评分、按语言和领域分桶、人工抽检,并用训练实验验证过滤规则,而不是凭感觉调阈值。

5. 去重不只是 MinHash

同一篇文章可能被转载几十次,同一个 GitHub 项目可能有大量 Fork,教程可能只改了标题和几句话。

完整的去重通常包括:

  • URL 与内容哈希去重;
  • 文档级精确去重;
  • MinHash、LSH 或向量方法进行近似去重;
  • 跨数据源和跨语言去重;
  • 训练集与评测集之间的污染检测。

去重的目标不是删得越多越好,而是在重复簇中保留来源可靠、内容完整、质量最高的版本。

6. PII 与安全不能只靠正则

邮箱、手机号、身份证、家庭住址、API Key 和内部代码都可能进入训练集。

正则表达式适合处理格式稳定的内容,但生产系统还需要命名实体识别、密钥扫描、分类器和人工复核。更重要的是建立删除机制:当数据需要撤回时,团队必须知道它进入过哪些数据版本和模型版本。

有害内容也不能简单按关键词全部删除。模型仍然需要理解攻击、欺诈和危险内容,才能识别并拒绝它们。真正需要管理的是上下文、比例、标注方式和训练目标。

数据配比,本质上是能力预算

训练算力是有限的。提高一种数据的采样比例,就意味着其他数据获得的训练机会下降。

代码数据具有结构化、长程依赖和部分结果可验证的特点,增加它可能改善编程和某些推理任务,但并不保证通用推理一定增强。比例过高,也可能挤压自然语言、领域知识和多语言能力。

增加中文语料,通常能够改善中文理解、表达和知识覆盖;但一段中文需要多少 Token,主要取决于 Tokenizer 的词表和分词策略。中文数据比例与 Tokenization 效率有关联,却不是同一件事。

增加论文与书籍,可以提高知识密度和长文本结构;增加社交媒体内容,可以覆盖实时语言和大众观点,也会带来更多谣言、攻击性表达和群体偏差。

所以,不存在适合所有模型的黄金配比。

数据配比不是原料采购,而是产品目标在训练集上的投影。

一个面向代码的模型、一个中文法律模型和一个通用对话模型,本来就不应该使用同一份数据配方。

合成数据的核心不是生成,而是验证

当高质量自然数据越来越稀缺,合成数据成为重要来源。强模型可以生成教材、推理题、代码、问答和偏好样本,还可以控制难度和覆盖长尾任务。

但合成数据不会凭空创造可靠知识。

教师模型的错误会传递给学生模型;模板过于单一会降低表达多样性;同一模型反复生成、筛选自己的内容,还可能放大固有偏差。

因此,合成数据最重要的不是生成规模,而是验证机制:

  • 数学题验证最终答案与推导约束;
  • 代码通过编译器、单元测试和静态分析验证;
  • 工具调用通过真实执行结果验证;
  • 知识问答通过检索和来源交叉验证;
  • 难以自动验证的内容进行多模型评审与人工抽样。

如果没有验证器,合成数据只是更便宜、更快速地制造不确定性。

数据工程必须与评测形成闭环

一次清洗完成后,团队最应该问的不是“还剩多少 Token”,而是:模型在哪些能力上变好了,在哪些能力上退化了,为什么?

模型错误与用户反馈
        ↓
错误分类与根因分析
        ↓
定位数据缺口、错误样本或配比问题
        ↓
补充、修正、重采样或重新标注
        ↓
小规模训练与消融实验
        ↓
离线评测、红队测试和线上观察
        ↓
通过门禁后进入下一数据版本

这里至少要建立四类指标:

  1. 数据指标:重复率、语言分布、领域覆盖、质量分布、PII 命中率;
  2. 训练指标:不同数据桶的 Loss、梯度异常、Token 利用率和收敛曲线;
  3. 能力指标:目标任务准确率、代码通过率、事实性和指令遵循;
  4. 风险指标:幻觉、有害输出、隐私泄露、偏差与评测集污染。

没有数据版本,训练无法复现;没有消融实验,无法证明某批数据有效;没有线上反馈,离线榜单也无法代表真实价值。

对企业而言,数据护城河应该如何落地

大多数企业没有必要从零预训练一个通用大模型。真正值得投入的是把内部知识、业务过程和专家反馈转化为可治理、可评测的数据资产。

我会优先做下面这些事情:

  1. 明确三个最有价值、结果可以衡量的业务任务;
  2. 为每个任务建立独立评测集,而不是先收集“所有数据”;
  3. 盘点数据来源、权限、许可证、敏感级别和负责人;
  4. 建立清洗、去重、脱敏、版本和血缘流水线;
  5. 先用 RAG 或小规模微调验证价值,再决定是否扩大训练;
  6. 把用户纠错、人工审核和失败案例持续回流;
  7. 用业务结果决定数据投入,而不是用 Token 数量汇报成绩。

企业真正独有的数据,往往不是互联网上还能再爬一遍的网页,而是经过授权的业务流程、专家判断、客户反馈、失败案例和结果标签。

这些数据规模可能不大,却与真实结果高度相关,也最难被竞争对手复制。

最后的判断

大模型的算法和代码当然重要。训练系统、模型结构、优化器、算力和推理工程,也不会因为开源而失去价值。

但当基础架构逐渐成为公共能力,真正难以复制的是:

  • 长期积累且获得授权的领域数据;
  • 对数据来源、偏差和质量的理解;
  • 人类专家的判断与反馈;
  • 从模型错误持续生产训练数据的能力;
  • 与真实业务结果绑定的评测体系。

“垃圾进,垃圾出”只是第一层结论。

我更愿意把它完整地写成:

参数决定模型的容量,算力决定训练的规模,算法决定学习的效率,而数据决定模型最终学会什么。

当代码逐渐成为公共基础设施,真正的竞争不再是谁能把模型跑起来,而是谁能持续把正确、稀缺、合法、可验证的数据送进模型,并证明模型因此变得更好。

这才是大模型时代真正的数据护城河。

参考资料

31 / 41

中小企业 Agent 平台架构:从入口、编排到工具与治理的完整设计

一套可以直接用于方案评审和生产落地的 Agent 架构:七层系统、三类核心契约、完整执行链路、知识与记忆、工具网关、安全治理、部署拓扑及 90 天实施计划。
2026/08/07 · 24 分钟阅读

企业 Agent 不能按照“做一个聊天机器人,再接几个 API”的思路设计。

聊天机器人解决的是回答问题;生产 Agent 解决的是完成任务。后者要识别操作者身份、读取有权限的数据、规划步骤、调用业务系统、等待审批、处理中断、验证结果,并留下可以追责和复盘的执行记录。

大型集团把这些能力建设成统一的 Agent Platform、Tool Hub、Knowledge Platform 和 Governance Center。中小企业没有必要复制一套重型中台,但不能删除这些能力。正确做法是:保留完整逻辑分层,采用轻量部署;先实现一个业务域,等复用和规模真实出现后再拆平台。

这篇文章给出的不是概念清单,而是一套可以直接拿去做技术方案评审的蓝图。

一、先看完整架构

中小企业 Agent 平台总体架构

整个系统可以分为七层,以及贯穿所有层的治理与可观测能力:

01 交互层       Web / App / 企业 IM / API / Event
02 Agent Gateway 身份、租户、会话、限流、风险分级
03 编排层       Router、Workflow、Planner、State Machine、Approval
04 Agent Runtime Instructions、Skills、Tools、Context、Stop Conditions
05 模型层       Model Gateway、模型路由、结构化输出、预算与降级
06 知识与记忆层 RAG、业务事实、任务状态、用户偏好、版本与权限
07 工具与集成层 Tool Gateway、MCP/API Adapter、CRM/ERP/邮件/数据库

横切能力        IAM、Policy、Audit、Evaluation、Trace、Cost、Safety

图中的关键并不是层数,而是两条边界:

  1. 模型不直接访问企业系统。 所有外部动作必须经过 Tool Gateway;
  2. 模型不负责授权自己。 是否允许执行由确定性的 Policy Engine 判断。

这两条边界把“一个可能犯错的推理模型”变成“一个被系统约束的业务执行单元”。

二、七层架构怎样设计

Layer 1:Interaction Layer——入口只负责表达目标

入口可以是聊天框,也可以是 CRM 中的“分析客户”按钮、邮件事件、定时任务或其他系统的 API 调用。不要把 Agent 等同于 Chat UI。

交互层负责:

  • 收集目标、附件和补充参数;
  • 显示执行计划、进度、引用和审批卡片;
  • 支持暂停、取消、重试和人工接管;
  • 把对外发送、付款、删除等敏感动作明确展示给审批人。

所有入口最后都转换为统一的 TaskSpec,后续系统不应该依赖“用户说了一句话”这种模糊输入。

Layer 2:Agent Gateway——先回答“谁在做什么”

Agent Gateway 类似 API Gateway,但它额外理解 Agent 任务。它必须在模型推理之前完成:

Authentication  你是谁?
Tenant           属于哪个公司或业务单元?
Authorization    能访问哪些数据和工具?
Task Routing     这是客服、销售、采购还是财务任务?
Risk Tier        只读、可逆写入、外部影响还是高风险动作?
Budget           最长运行多久、最多花费多少、最多调用几次工具?

一个可落地的任务契约如下:

{
  "task_id": "tsk_20260807_001",
  "task_type": "sales_region_diagnosis",
  "tenant_id": "acme",
  "actor": { "id": "u_102", "roles": ["sales_manager"] },
  "input": { "region": "east", "period": "2026-Q3" },
  "risk_tier": "L1",
  "budgets": { "max_seconds": 180, "max_tool_calls": 12, "max_cost_usd": 0.8 },
  "acceptance": ["所有数字来自工具结果", "结论包含引用", "不得自动发送邮件"]
}

没有统一任务契约,后面很难做权限、幂等、成本归因和回归评测。

Layer 3:Orchestration Layer——系统真正的控制中心

编排层不是让 LLM 随意思考,而是决定哪些步骤由代码控制、哪些节点允许模型判断。

以“分析华东区销售下降”为例:

1. 校验用户是否有华东区数据权限             deterministic
2. 查询本期与同期销售数据                    deterministic tool call
3. 并行查询客户、产品、渠道和退货维度          parallel workflow
4. 找出显著异常并提出原因假设                  model reasoning
5. 用第二组数据验证每个假设                    evaluator workflow
6. 生成带引用的报告                           model synthesis
7. 发送给区域经理                             human approval + tool call

生产编排器至少需要:

  • State Machinequeued → running → waiting_approval → succeeded/failed/cancelled
  • Checkpoint:长任务中断后从已完成步骤继续,而不是全部重跑;
  • Idempotency:同一审批回调或写入请求重复到达,不产生双重发送和重复订单;
  • Timeout / Retry / Circuit Breaker:区分模型超时、工具暂时失败和永久业务拒绝;
  • Human-in-the-loop:审批不是聊天里的一句“可以”,而是一条包含操作者、动作、参数摘要、过期时间的记录;
  • Compensation:部分执行失败时,知道如何撤销标签、关闭草稿或回滚状态。

任务路径确定时使用 Workflow;只有无法预先写出路径时才让 Agent 自主选择下一步。这个边界决定系统是否可预测。

Layer 4:Agent Runtime——Agent 到底由什么组成

一个生产 Agent 不是一段 Prompt:

Agent Runtime
= Instructions      角色、目标、边界、完成定义
+ Skills             某类任务的步骤、示例和失败处理
+ Tool Definitions   可调用动作及输入输出 Schema
+ Working Context    当前任务事实、历史步骤、剩余预算
+ Policies           数据、动作和审批规则
+ Evaluators         结果、轨迹和安全检查
+ Stop Conditions    完成、预算耗尽、冲突、连续失败、需要人工

Instructions 应描述稳定原则,Skill 描述可复用任务方法,业务事实从工具实时获取。不要把每天变化的库存、价格和客户状态硬编码到 Prompt。

Runtime 每一轮执行的是同一个闭环:观察状态 → 选择下一动作 → Policy 校验 → 执行工具 → 写入结果 → 判断完成。这个闭环必须有最大轮数和最大工具链长度,避免无限规划。

Layer 5:Model Layer——模型是算力,不是架构

业务代码不应直接依赖某个模型 SDK。Model Gateway 统一处理:

  • 供应商与模型路由;
  • 超时、限流、重试和故障降级;
  • JSON Schema / Structured Output 校验;
  • Prompt、模型、采样参数版本记录;
  • Token、延迟和费用预算;
  • 敏感字段脱敏、允许区域和数据出境策略。

路由策略可以很务实:

任务模型策略
意图分类、字段抽取、文档路由低成本快速模型
多步规划、异常归因、复杂综合强推理模型
高并发固定问答缓存 + 小模型,必要时升级
敏感任务先执行数据策略,再选择合规部署的模型

“敏感数据使用私有模型”不是完整答案。私有部署仍可能存在日志泄露、越权检索和错误工具调用;公有模型也可能通过零保留、区域部署、字段脱敏和企业契约满足特定要求。安全判断必须围绕数据流,而不是模型品牌。

Layer 6:Knowledge & Memory——不要把向量库叫作企业知识

知识层的基本对象不是 Chunk,而是“有治理的知识条目”:

{
  "document_id": "contract-policy-2026",
  "version": "3.2",
  "owner": "legal",
  "classification": "internal-confidential",
  "allowed_roles": ["legal", "sales-director"],
  "effective_from": "2026-01-01",
  "expires_at": "2026-12-31",
  "source_uri": "s3://knowledge/legal/contract-policy-v3.2.pdf"
}

完整知识链路应该是:

数据源接入
→ OCR / 结构化解析
→ 去重与版本识别
→ 按标题、段落、表格语义切块
→ 继承权限和元数据
→ Embedding + 关键词索引
→ 查询权限过滤
→ Hybrid Search
→ Reranker
→ 返回片段、来源、版本和有效期

Memory 需要分开:

  • Working Memory:当前任务中间状态,任务结束后归档;
  • Conversation Memory:经过摘要的对话上下文,有长度与生命周期;
  • User Preference:语言、格式等明确授权的稳定偏好;
  • Enterprise Knowledge:组织政策和业务资料,它不是个人记忆;
  • Business State:订单、库存、余额等实时事实,只从权威业务系统读取。

最危险的错误,是把历史对话中的旧事实当成当前业务状态。

Layer 7:Tool Platform——把企业能力变成安全动作

Agent 不应直接生成 SQL 连接生产数据库,也不应拥有“万能 CRM 工具”。正确链路是:

Agent → Tool Gateway → Business API / MCP Server → CRM / ERP / Email / Database

一个工具契约至少包含:

{
  "name": "get_customer_sales",
  "version": "1.3.0",
  "description": "查询指定客户在授权时间范围内的已确认销售额",
  "input_schema": {
    "customer_id": "string",
    "start_date": "date",
    "end_date": "date"
  },
  "required_permission": "sales.customer.read",
  "risk_tier": "L0",
  "timeout_ms": 3000,
  "idempotent": true,
  "audit_fields": ["customer_id", "date_range"]
}

Tool Gateway 负责参数校验、身份透传、权限复核、速率限制、幂等、超时、结果裁剪和审计。模型只看到完成任务所需的最小结果,不能读取整张客户表。

三、一次 Agent 请求到底怎样运行

Agent 从请求到执行与学习的完整链路

一次“分析销售下降并把报告发给经理”的完整运行过程是:

  1. Gateway 验证用户身份、租户和角色;
  2. Router 将任务路由到 Sales Analysis Skill;
  3. Orchestrator 创建任务状态、预算和 Trace;
  4. Runtime 读取 Skill,只生成当前所需的查询计划;
  5. Policy Engine 检查用户能否读取目标区域和指标;
  6. Tool Gateway 并行调用 BI/CRM 的窄接口;
  7. 工具结果以结构化 Observation 写回任务状态;
  8. Agent 基于事实生成原因假设;
  9. Evaluator 检查每个数字和结论是否有工具证据;
  10. Runtime 生成报告草稿和 send_email 动作建议;
  11. Policy 将外发动作升级为人工审批;
  12. 审批通过后工具执行,结果进入审计日志和在线评测。

注意:审批发生在动作执行前,而不是模型生成完整回答之后随便弹一个确认框。审批对象必须包含收件人、主题、附件、数据等级和内容摘要,审批后参数被修改则必须重新审批。

四、常用编排模式怎样选

模式适用场景例子
Prompt Chaining步骤固定、前后依赖提取合同字段 → 检查条款 → 生成摘要
Routing输入类型决定流程售前、售后、投诉分别进入不同 Skill
Parallelization子任务独立且结果可合并同时分析客户、产品、区域、渠道
Evaluator–Optimizer结果有清晰质量标准报告生成后检查数字、引用和禁用表达
Orchestrator–Workers子任务数量和类型动态变化调研多个竞品并汇总差异
Autonomous Agent路径无法预先确定、环境反馈充分复杂故障调查、开放式研究

中小企业最常用的不是 Autonomous Agent,而是前三种 Workflow 加少量模型判断。多 Agent 只有在需要上下文隔离、权限隔离、真正并行或独立复核时才值得引入。

推荐的演进顺序是:

Single Prompt
→ Workflow + Tools
→ Single Agent + Skills
→ Supervisor + 2~3 Specialist Agents

不要从最后一步开始。

五、安全治理不是最后加一个过滤器

建议按动作风险定义权限:

级别动作默认控制
L0读取公开或已授权内部数据自动执行,完整记录
L1创建草稿、标签、内部建议策略自动批准,可撤销
L2外发邮件、更新 CRM、创建订单执行前人工审批
L3付款、删除、合同签署、生产发布双人审批或禁止 Agent 执行

生产前至少覆盖以下风险:

  • Prompt Injection:网页、邮件、文档均视为数据,不能覆盖系统指令;
  • Excessive Agency:工具和数据权限按任务最小化,禁止通配符权限;
  • Data Leakage:检索前做权限过滤,日志和模型输入做字段级脱敏;
  • Tool Misuse:参数经过 Schema、业务规则和 Policy 三次校验;
  • Unbounded Loop:限制轮次、工具链、时间、Token 和费用;
  • Memory Poisoning:只有通过验证的信息才能进入长期记忆,并保留来源;
  • Supply-chain Risk:第三方 MCP Server 和工具需要固定版本、权限清单与安全审查。

Policy Engine 的输入应是结构化事实,而不是让另一个 LLM回答“这个操作安全吗”。

六、评测与可观测性怎样落到指标

传统 APM 只能告诉你接口是否报错,Agent Observability 还必须回答:为什么选择这个工具、使用了什么知识、是否越权、答案有没有依据、一次合格结果花了多少钱。

建议记录一条统一的 Trace:

task_id
├── input + actor + policy_version
├── route_decision
├── model_call(prompt_version, model, tokens, latency)
├── retrieval(query, filters, document_versions, scores)
├── tool_call(tool_version, args_digest, result_digest, status)
├── approval(actor, action_digest, decision, expires_at)
└── result(evaluation_scores, human_feedback, total_cost)

指标分四组:

类型关键指标
业务结果完成率、首次通过率、端到端周期、转化或问题解决率
Agent 质量工具选择准确率、事实有据率、任务轨迹得分、人工接管率
系统可靠性P50/P95 延迟、工具失败率、重试率、恢复时间
经济性单任务成本、单个合格结果成本、Token/工具/人工复核成本

评测集不要只放标准问答。它应该包含完整任务:初始状态、允许工具、预期关键步骤、禁止动作、最终验收和可接受的多条路径。模型、Prompt、Skill、工具、知识和 Policy 任一变化,都要跑回归。

七、中小企业可直接采用的部署拓扑

第一阶段没有必要上 Kubernetes。一个稳定的生产起点可以是:

Nginx / Cloud Load Balancer
  ├── Web / Admin Console
  └── Agent API
        ├── Orchestrator Workers
        ├── PostgreSQL:任务、审批、审计、业务配置
        ├── Redis:队列、短期状态、限流
        ├── Object Storage:文档原件和产物
        ├── pgvector / 托管向量库:知识索引
        ├── Model Gateway:模型接入与预算
        ├── Tool Adapters:CRM、ERP、邮件、BI
        └── OpenTelemetry:Trace、Metric、Log

技术选型按复杂度决定:

能力轻量起步规模化后
编排代码状态机 + 队列LangGraph 或 Temporal 等持久工作流
任务数据PostgreSQLPostgreSQL + 分区/只读副本
短期状态RedisRedis Cluster / 托管服务
RAGPostgreSQL + pgvector独立检索服务或托管向量库
工具协议内部 REST/函数调用统一 Tool Gateway + 受控 MCP
可观测OpenTelemetry + 日志平台专用 LLM Trace 与评测平台
模型单供应商 + 降级模型多供应商路由、区域与合规策略

什么时候才需要拆成平台?当至少三个业务场景重复使用模型网关、工具、知识权限、审批和评测能力,并且独立发布节奏已经互相阻塞。此前保持模块化单体,通常比微服务更可靠。

八、完整落地案例:销售分析 Agent

目标不是“帮销售聊天”,而是把一个明确流程从 2 小时缩短到可控的十几分钟,同时保证所有结论有数据依据。

输入

分析 2026 Q3 华东区销售额下降原因,比较同比与环比,
拆分客户、产品、渠道和退货因素,给出三项行动建议,
生成报告草稿,但不要自动发送。

系统执行

  1. Gateway 确认销售经理仅能读取华东区;
  2. Router 选择 sales-region-diagnosis:v2 Skill;
  3. 编排器并行调用四个只读工具;
  4. Agent 找到“大客户流失、A 产品缺货、渠道退货上升”三个候选原因;
  5. Evaluator 要求每个原因绑定指标、对比期和查询 ID;
  6. 对缺少证据的原因自动补查一次,仍无证据则删除;
  7. 输出结论、置信度、数据引用和行动建议;
  8. 报告写入内部文档草稿,外发动作等待审批。

验收标准

  • 报告中的金额、比例和排名 100% 可追溯到工具结果;
  • 不读取华东区之外的客户明细;
  • 任一工具失败时明确标记数据缺口,不用模型猜数字;
  • 报告生成失败不得触发发送;
  • 人工修改被分类为数据问题、推理问题、表达问题或流程问题,并进入评测集。

结果看板

不要预先虚构“效率提升 80%”。上线前冻结基线,上线后按同一口径填入实测结果:

指标上线前基线试点目标实测
端到端周期采集 2 周降低 ≥ 50%试点后填写
人工有效操作时间采集 2 周降低 ≥ 40%试点后填写
首次通过率历史抽样≥ 85%试点后填写
数字可追溯率历史抽样100%试点后填写
严重越权或错误外发00试点后填写
单个合格报告总成本人工完全成本低于基线试点后填写

真正的 ROI 应包含模型、工具、基础设施、人工审批、维护和失败成本。最有意义的单位是每个被业务接受的结果成本,不是每百万 Token 价格。

九、90 天实施计划与交付物

0–30 天:跑通一条只读闭环

  • 选定一个流程、业务 Owner 和技术 Owner;
  • 定义 TaskSpec、三个核心 Tool Contract 和权限矩阵;
  • 建立 30–50 条真实任务评测集;
  • 完成 Gateway、状态机、Model Gateway、Trace;
  • 影子运行,只生成报告,不写业务系统。

交付: 可运行 MVP、基线报告、评测集、风险清单、运行 Trace。

31–60 天:加入知识、审批和有限写入

  • 建立文档版本、权限和有效期;
  • 增加可逆写入与审批记录;
  • 完成 Prompt Injection、越权、超预算、工具失败测试;
  • 设置降级、熔断、回滚和一键停用;
  • 每周分析人工修改并更新 Skill 与评测。

交付: Knowledge v1、Policy v1、审批流、安全测试报告、质量看板。

61–90 天:对照试点并决定是否扩展

  • 新旧流程覆盖至少两个完整业务周期;
  • 统计业务、质量、可靠性和经济性四组指标;
  • 固化可复用的 Gateway、Tool、Policy、Trace 和 Eval 组件;
  • 只有达到验收线才扩大用户和写权限;
  • 不达标则定位数据、工具、模型或流程问题,缩小范围而不是继续堆 Agent。

交付: 试点结果、事故预案、运行手册、扩展/停止决策。

十、架构评审清单

  • 用户、Agent 和工具是否使用同一套身份与权限上下文?
  • 业务事实是否只从权威系统读取,而不是从对话记忆猜测?
  • 每个工具是否有 Schema、版本、权限、风险、超时和幂等定义?
  • 模型能否绕过 Policy Engine 直接执行动作?
  • 外发、资金、删除、合同和生产动作是否在执行前审批?
  • 检索是否在召回前做租户与权限过滤?
  • 任务中断后能否续跑,重复请求是否会重复写入?
  • 是否限制轮数、工具调用、运行时间、Token 和费用?
  • 能否通过 task_id 重建模型、知识、工具、审批和结果链路?
  • 任一模型、工具或知识源不可用时,系统是否安全降级?
  • 是否有离线评测、影子运行、灰度、回滚和一键停用?
  • 是否以业务接受结果而不是调用次数衡量价值?

结语

成熟的 Agent 架构不是“一个更强的聊天机器人”,而是一套 AI 原生业务执行系统:模型负责理解与判断,编排器控制流程,知识层提供有权限的上下文,工具层连接真实世界,Policy 决定能不能做,Evaluation 判断做得对不对,Observability 解释整个过程发生了什么。

中小企业不需要从 Agent Marketplace 和 Kubernetes 开始,但必须从清晰边界和完整闭环开始。保留七层逻辑,先以模块化单体实现;用一个真实业务流程跑通,再依据复用、并发和团队边界逐步拆分。

架构的终点不是“拥有多少 Agent”,而是让更多业务任务能够被安全、稳定、可度量地完成。

延伸阅读

32 / 41

用务实 DDD 构建 Docket:从业务边界到可演进的模块化单体

以 Docket 的真实代码为例,拆解专业服务协作平台如何划分有界上下文、组织 API、领域服务与数据模型,并讨论模块化单体走向更严格 DDD 的演进路径。
2026/08/07 · 13 分钟阅读

Docket 是一个面向律师与专业服务团队的工作台,覆盖获客、材料收集、协议签署、项目交付、收费回款与客户转介绍。它看起来像一个“项目管理系统”,但真正困难的地方不是增删改查,而是让多个角色、多个阶段和多种业务规则在同一条服务链路中保持一致。

我在实现它时采用了 DDD(领域驱动设计)的核心思想,但没有机械复制教科书式的四层目录。Docket 的准确定位是:以业务有界上下文组织的模块化单体。它保留单体部署和本地事务的效率,同时用领域边界控制复杂度。

Docket 的务实 DDD 总体架构

先划分业务,再选择技术

如果按页面拆系统,很容易得到“项目页模块”“上传页模块”“后台页模块”;如果按数据库表拆,则会得到一组彼此调用的 CRUD Service。这两种方式都没有回答最重要的问题:业务能力的边界在哪里?

Docket 先把核心业务划为若干有界上下文:

上下文核心职责代表对象
Identity账号、认证、套餐身份Lawyer、LoginLog
Lead线索、跟进、转化LeadEntry、LeadFollowUp
Project项目生命周期与协作主线Project、ProjectItem
Collection客户上传、审核、签收DocumentFile、ReviewService
Agreement多方协议与签署流程ProjectAgreement、AgreementSigner
Delivery证照与成果交付Delivery、DeliveryPhoto
Finance / Billing收费回款、套餐与用量FeeRecord、PaymentEntry、CoinAccount
Profile / Portal公开获客页与客户门户LawyerProfile、PortalProjectService
Notification邮件、提醒与任务记录NotificationLog

这不是一次性完成的分类。边界来自业务语言和变化原因:材料审核规则变化不应迫使身份模块一起修改;签署状态机与项目状态有关,但不等于项目本身;通知是多个领域共享的支撑能力,却不应拥有项目决策权。

Docket 有界上下文及其协作关系

代码中的三层职责

后端由 Flask 应用工厂统一装配,主要形成三个可观察层次。

第一层是 app/api/*_api.py。Blueprint 负责 HTTP 协议:解析参数、验证身份、调用服务、序列化响应。路由不应该决定“项目何时完成”或“协议能否签署”。这样,同一业务能力未来可以被后台任务、CLI 或其他接口复用。

第二层是 app/{domain}/services.py。这里承载用例编排和业务规则。例如材料域处理上传验证、批次与审核;协议域管理邀请、拒签、完成和结果 PDF;门户域将多个上下文的数据组织成客户视图。Service 是系统当前最接近应用层与领域层合并体的部分。

第三层是 app/{domain}/models.py。SQLAlchemy 模型保存实体状态、关系和部分枚举语义;MySQL、邮件、文件、定时任务和区块链存证则提供基础设施能力。

一次典型请求如下:

Next.js 页面
  → Flask Blueprint:认证与参数
  → Domain Service:执行业务用例
  → ORM Model / db.session:读取并提交状态
  → Notification / File / Scheduler:触发支撑能力
  → JSON 响应

依赖方向的约束很简单:页面不直接理解数据库,API 不复制业务规则,领域模块不依赖前端展示细节。

聚合不是“有关联的表放在一起”

Project 是 Docket 最明显的聚合入口。外部通过 public_id 找到项目,内部整数主键只用于关联;ProjectItem 和 DocumentFile 作为协作链路中的子对象,由服务在明确的权限和状态约束下改变。

这种设计解决了两个问题。其一,对外标识与存储标识分离,URL 不暴露业务规模,也便于跨环境引用。其二,状态变化必须经过用例,而不是任意控制器直接更新字段。

无登录场景则使用独立 token:客户收集链接的 client_token、签署人的 signer_token 既是定位信息也是能力凭证,不能与需要 JWT 保护的 public_id 混用。这是领域安全规则,而不只是 URL 风格。

跨域协作如何保持可控

一个真实流程会跨越多个上下文:线索转为客户和项目;客户上传材料;律师审核;协议完成;成果交付;系统邀请评价并沉淀转介绍。

Docket 当前采用单体内的显式 Service 调用与同库事务。它的优势是部署简单、调试直接,对早期产品尤其重要。需要发送邮件、生成 PDF 或写入存证时,则通过 Notification、任务函数或队列式组件把副作用从主流程中分离。

这里的关键不是禁止跨域调用,而是明确谁拥有规则。例如“协议是否完成”由 Agreement 决定;Project 可以消费完成结果,但不应自己重写签署判断。跨域传递的是结果和标识,而不是共享一段散落在路由中的判断逻辑。

为什么没有一开始就上微服务

有界上下文不等于微服务。Docket 的各业务域共享一个 Flask 进程和 MySQL 数据库,这让涉及项目、材料和通知的操作可以使用本地事务,也避免了分布式调用、消息一致性和运维平台的过早成本。

模块化单体的前提是边界真实存在:目录独立、入口清晰、数据所有权可解释。如果模块只是换了文件夹却随意互相导入模型,它最终仍会退化成“大泥球”。因此是否拆服务,应由独立扩缩容、故障隔离、团队自治或合规隔离等实际压力决定,而不是由模块数量决定。

这套实现并不是“纯 DDD”

真实架构需要诚实描述。Docket 的 Service 直接使用 SQLAlchemy 模型和 db.session,领域对象同时也是持久化对象;部分服务承担了序列化和跨域查询;跨模块依赖也尚未全部通过端口、领域事件或仓储抽象隔离。

这是有意识的工程取舍:在业务高速变化期,先获得清楚的语言和模块边界,比提前维护大量 Repository 接口、DTO 映射与消息设施更有价值。但随着复杂度增长,可以按风险逐步演进:

  1. 把关键状态机和不变量从大型 Service 移入领域对象或独立 Domain Policy。
  2. 为文件存储、邮件、AI、区块链等外部能力定义 Port,并在基础设施层实现 Adapter。
  3. 用应用层 DTO 隔离 API 表达与 ORM 模型,避免序列化规则渗入领域服务。
  4. 对“协议完成”“项目签收”“线索转化”等事实引入领域事件,并用 Outbox 保证提交与投递一致。
  5. 建立模块依赖检查,只允许公开入口,阻止跨域直接修改他方数据。
  6. 只有当运行边界真的不同,再把成熟上下文拆成独立服务。

如何验证边界是否有效

架构图不是验收标准,变化成本才是。一个边界有效,通常能通过三个问题:修改一个领域规则时,影响是否主要停留在该模块;一次业务动作是否只有一个明确入口;失败后能否判断是哪个上下文、哪条用例、哪个副作用出了问题。

测试也应围绕这些边界组织:领域规则测试覆盖状态转换和不变量;Service 测试覆盖用例与事务;API 测试覆盖认证、参数和响应契约;少量端到端测试覆盖从获客到交付的关键旅程。

最后的判断

DDD 的价值不在目录名,而在让代码结构跟业务结构保持一致。对 Docket 来说,最重要的不是是否拥有 domain/application/infrastructure 三个文件夹,而是团队能否清楚回答:谁拥有项目状态,谁决定材料合格,谁确认协议完成,谁负责交付,跨域事实如何传播。

先用模块化单体建立边界,再让架构随业务证据演进,是 Docket 采用 DDD 的方式。它不追求形式上的纯粹,但追求每一次复杂度增加,都能被放回一个清楚、可测试、可演进的业务模型中。

项目

33 / 41

心绪云脑AI:从零构建可靠的多模态情绪理解系统

从文本、语音与手绘图三通道出发,设计一套包含独立模态编码、缺失模态鲁棒融合、多任务学习、不确定性校准、隐私治理和持续评测的生产级情绪理解架构。
2026/08/07 · 18 分钟阅读

心绪云脑AI的目标,是从用户主动提供的文字、语音和手绘图中理解当下表达的情绪线索,并把结果用于更有同理心的人机交互。

这个任务的难点不在于把三种输入送进一个大模型,而在于三个事实:不同模态表达的不是同一种信息;情绪本身可能共存、含混并随语境变化;模型输出只能表示“从当前证据推断出的可能状态”,不能替代用户自述,更不能被当作心理诊断。

因此,这套系统的设计原则是:保留每种模态的独特证据,显式建模不确定性,让用户拥有最终解释权。

心绪云脑AI多模态情绪理解架构

先定义任务,而不是先选模型

离散的快乐、悲伤、愤怒、恐惧、惊讶、厌恶和中性可以保留为产品展示层,但训练目标不应只有一个七分类 Softmax。

真实表达可能同时包含悲伤和愤怒,“中性”也可能只是证据不足。更稳健的输出包含三部分:

{
  "emotions": [
    {"label": "悲伤", "probability": 0.68},
    {"label": "焦虑", "probability": 0.31}
  ],
  "valence": -0.62,
  "arousal": 0.48,
  "uncertainty": 0.27,
  "evidence": {
    "text": "用户明确表达失落",
    "audio": "语速较慢且停顿增加",
    "drawing": "仅作为弱辅助信号"
  },
  "decision": "ask_for_confirmation"
}

其中离散标签支持多标签,Valence 描述正负感受,Arousal 描述唤醒程度;不确定性决定系统是回答、询问用户确认,还是停止推断。强度不应由生成模型随意输出一个 0-1 数字,而应来自经过标注和校准的回归头。

三种输入必须保留三种证据

文本通道

文本编码器处理字面语义、否定、反讽、上下文和对话历史。ASR 转写也进入文本通道,但必须携带时间戳、置信度和语言信息。模型要区分用户原始输入与自动转写,避免把 ASR 错误当作确定事实。

语音通道

语音不能只经过 Whisper 变成文字。文字会丢失音高、能量、语速、停顿、音质和节奏。生产架构应保留原始波形或声学特征,通过 speech encoder 生成时序表示,再与 ASR 语义共同参与融合。

音频预处理包含采样率规范化、静音和语音活动检测、质量评分与分段,但不要用过强降噪抹掉呼吸、停顿等潜在信息。低信噪比时应降低该模态权重,而不是强行给出高置信判断。

手绘图通道

手绘图表达高度个人化。颜色、线条和构图可以提供上下文,却不存在“黑色等于悲伤”这样的通用映射。视觉编码器应理解画面语义与结构;绘制时长、笔画轨迹等过程数据只有在用户明确同意时才可使用。

图像增强必须尊重任务语义。任意色彩抖动可能改变情绪线索,裁剪可能删除主体;所有增强策略都要通过消融实验验证。生成式合成图可用于预训练或稀有模式增强,但必须标记来源、限制比例,不能进入验证集和测试集。

为什么不把所有输入直接交给一个 VLM

视觉语言模型擅长联合理解图像和文字,但普通 VLM 并不天然接收原始音频,也未必学到了适用于特定人群和文化语境的情绪边界。把语音只做 ASR、再与图片一起送进 VLM,会丢掉完整声学信号。

心绪云脑AI采用多分支架构:文本 encoder、speech encoder、vision encoder 各自产生表示,通过适配器映射到共享维度,再由 gated fusion 或 cross-modal transformer 融合。VLM 可以作为视觉语义教师、弱标注器或解释生成器,但最终分类、维度回归和不确定性由受监督任务头负责。

这样设计还有一个现实优势:某个模态缺失或质量较差时,系统仍能运行,而不必伪造一个空图片或空音频。

缺失模态不是异常,而是默认场景

用户可能只输入文字,也可能拒绝上传语音,图片可能损坏,ASR 也可能失败。训练和评测必须覆盖文本、语音、图像的所有可用组合。

可以在训练中使用 modality dropout,随机屏蔽一路或多路输入;融合层同时接收模态存在标志和质量分数;每个单模态分支都保留辅助损失,避免融合模型完全依赖最强通道。

推理时先执行输入质量门控:

可用性检测 → 单模态编码 → 质量估计 → 动态融合
           → 多任务预测 → 校准 → 策略决策

系统应分别报告全模态、单模态和不同缺失组合的性能。只报告三路输入齐全时的 Macro-F1,会掩盖真实线上风险。

数据:用户自述优先于旁观者猜测

情绪标签具有主观性。三名众包标注者多数投票可以描述“外部观察者如何理解这段表达”,但不能自动成为用户真实情绪的金标准。

数据体系应区分:

  • self_report:用户自述标签和 Valence/Arousal,作为主要监督信号;
  • observer_labels:多名标注者的分布,而不是压缩成一个硬标签;
  • context:场景、语言和对话背景;
  • modality_quality:音频信噪比、ASR 置信度、图像可读性;
  • consent_scope:允许训练、评测、个性化或仅本次推理;
  • provenance:真实、公开数据、合成数据和生成方法。

训练、验证和测试必须按用户或说话人分组切分,同一人的相邻片段、同一对话、同一原始视频不能跨集合。否则模型可能记住身份、背景或剧集场景,得到虚假的高分。

公开数据适合预训练和基线,但 MELD、IEMOCAP 等影视或实验室数据与真实中文用户存在领域差异。评测集必须包含目标人群、目标设备和真实缺失模态分布,并经过授权。

训练:先建立基线,再逐层增加复杂度

推荐按四个阶段推进:

  1. 训练文本、语音、图像单模态基线,确定每一路真正贡献了什么。
  2. 冻结大部分 encoder,只训练适配器、融合层与多任务头,建立稳定的 late-fusion 基线。
  3. 引入 cross-modal attention、modality dropout、soft labels 与类别不平衡损失。
  4. 只有数据和评测证明需要时,再对部分 encoder 做 LoRA/QLoRA 或分阶段解冻。

参数高效微调不是固定配置。LoRA rank、目标层、学习率和量化方式都要通过实验选择;不能预设 r=64 就代表任务复杂度。视觉 encoder、语言模型和声学 encoder 也不应无差别全部微调,小规模数据很容易破坏基座能力。

损失函数可以组合为:

L = λ1 · MultiLabelEmotionLoss
  + λ2 · ValenceArousalRegressionLoss
  + λ3 · UnimodalAuxiliaryLoss
  + λ4 · CrossModalConsistencyLoss
  + λ5 · CalibrationLoss

所有实验记录数据版本、切分、随机种子、预处理、基座模型、代码提交、超参数与硬件环境。模型注册表保存权重、阈值、校准器和 Model Card,而不只是一个合并后的 checkpoint。

评测:准确率远远不够

离散标签至少报告 Macro-F1、各类 Precision/Recall、混淆矩阵和多标签指标;Valence/Arousal 报告 MAE、CCC 等回归指标;置信度报告 ECE、Brier Score 和选择性预测曲线。

评测必须包含:

维度要回答的问题
单模态与组合消融每种模态是否真的贡献增益
缺失与损坏模态ASR 失败、噪声、模糊图像时是否稳定
跨人群与设备性别、年龄、口音、地区、麦克风是否造成显著差异
跨数据集/OOD换场景后性能下降多少
校准与拒绝低置信时是否真的知道自己不知道
安全行为是否避免诊断、标签化和不当升级

“83% Accuracy”没有数据切分、置信区间、类别分布和独立复现实验就没有可比较意义。模型上线门槛应由目标场景的风险和错误成本决定。

心绪云脑AI的数据、训练与评测闭环

推理服务:模型之前和之后都需要策略层

API 不应直接把模型生成的 JSON 返回给用户。完整在线链路包括:

同意与用途校验
  → 文件安全、格式和大小限制
  → 模态质量检测与预处理
  → 并行编码、融合与多任务预测
  → 温度缩放/校准、阈值与 OOD 检测
  → 安全策略和表达生成
  → 用户确认或纠正

输出 JSON 使用严格 schema 校验,解析失败应返回明确错误或降级结果,不能默认判为“中性”。服务端设置请求级 deadline、批处理上限、显存准入和熔断;ASR、编码器与生成服务分别观测延迟和失败率。

LoRA 权重不一定必须合并。合并适合单模型低开销部署,独立 adapter 适合多租户和快速回滚。vLLM、TensorRT-LLM 或其他推理引擎是否支持目标多模态结构和 adapter,需要在选择前实际验证,不能只根据文本模型部署方式推断。

安全、隐私和产品边界

语音和图像可能包含生物特征与高度敏感信息。默认策略应是最小化采集、传输与静态加密、短期保留、可删除、用途隔离和细粒度访问审计。原始数据不应因“低置信度”自动进入训练池;只有独立、明确的训练同意才能回流。

产品文案使用“情绪表达线索”或“模型推测”,避免宣称读懂内心。系统不能据此进行招聘、绩效、教育评价、保险、信贷或执法决策,也不应作为心理疾病诊断。欧盟 AI Act 明确限制工作场所和教育机构中的情绪推断,并指出这类系统存在可靠性、特异性和泛化局限。

当文本包含自伤或即时危险线索时,不能由情绪分类标签自动下结论。应进入单独设计和验证的安全流程:提供支持性语言、鼓励联系当地紧急服务或可信任的人,并在适用法规和用户同意下进行人工升级。

监控:观察质量,而不是监控人的情绪

线上监控关注系统行为:各模态可用率、质量分布、预测熵、校准误差、拒绝率、用户纠正率、分组性能、数据漂移、P95/P99 延迟和资源饱和度。

“中性占比低于 40%”或“平均置信度高于 0.75”不是通用健康指标。真实用户群的情绪分布可能变化,高置信也可能是过度自信。应比较带标签的稳定评测集、校准曲线和用户确认数据,再判断是否漂移。

重训由证据触发:目标评测集显著退化、分组差距扩大、新设备或新语言上线、数据定义变化。新模型通过离线门禁、影子流量和小比例灰度后再发布,并保留快速回滚能力。

最终架构判断

心绪云脑AI不是一个“Qwen + Whisper + 分类头”的接口,而是一套以证据质量、用户同意和不确定性为核心的多模态学习系统。

文本告诉我们用户说了什么;语音补充他们如何表达;手绘图提供个人化的视觉语境。融合层负责组合证据,而不是把三路信号强行压成一个确定标签。真正可靠的系统会在证据冲突时降低置信,在模态缺失时安全降级,在用户纠正时尊重用户,并始终知道自己不能做心理诊断。

参考资料

34 / 41

现代并发编程:从执行模型到生产级可靠性

系统梳理并发与并行、内存模型、Java 虚拟线程、Go channel、Python asyncio、结构化并发、背压、取消和可观测性。
2026/08/07 · 16 分钟阅读

并发编程的核心可以归纳为三个问题:如何分工,如何协作,如何保护共享状态。语言和运行时提供线程、协程、事件循环、Actor、channel 等不同工具,但工具本身并不会自动带来正确性。

生产系统还必须处理任务生命周期、资源上限、超时、取消、背压与部分失败。只有把这些约束放进同一套设计中,并发才能从“同时运行多个任务”变成可推理、可观测、可控制的工程能力。

2026 年并发编程决策地图

先把四组概念分开

并发不是并行

并发描述多个任务在时间上重叠、需要被协调;并行描述多个任务在同一时刻真正执行。单核事件循环可以并发但不能并行执行 Python 代码,多核上的多个工作线程则可能同时具备两者。

Amdahl 定律仍然成立:串行部分决定固定工作量下的加速上限。2026 年更应补充两个现实约束:协调本身有成本,扩容会把瓶颈推向锁、内存带宽、数据库连接或下游限额。增加线程从来不是免费的加速器。

同步/异步与阻塞/非阻塞不是一回事

同步和异步主要描述结果如何交付以及控制流如何组织;阻塞和非阻塞描述一次操作不能立即完成时,调用线程是否停住。它们是两个维度,不能简单把 BIO、NIO、AIO 填进一个永远正确的四象限。

同一个异步 API 也可能在内部阻塞工作线程;一个阻塞 API 放到 Java 虚拟线程上,代码仍然阻塞,但平台线程可以去执行其他任务。工程判断应关注:谁在等待、占用了什么资源、能否取消,而不是只看 API 名字里有没有 async

进程、平台线程、轻量任务

进程拥有独立地址空间和故障边界;平台线程共享进程内存,由操作系统调度;goroutine、Java 虚拟线程和 Python asyncio Task 是由语言运行时管理的更轻量并发单元,但三者实现和语义并不相同。

协程会在挂起点交出执行权。多个任务对共享可变状态进行读-改-写时,仍会发生逻辑竞态。单线程事件循环只消除同一时刻的多核并行,不会自动保证跨 await 的不变量。因此,协程代码同样需要明确状态所有权和临界区。

内存模型:真正的问题是顺序关系

并发 Bug 通常来自三个维度:可见性、原子性和有序性。理解它们的关键不是推测 CPU 缓存的具体行为,而是依据语言内存模型判断操作之间是否建立了明确的 happens-before 关系。

在 Java 中,volatile 的意义来自 Java 内存模型:对 volatile 字段的写 happens-before 随后的读,从而建立可见性与顺序保证;它不使 count++ 这样的复合操作变成原子操作。synchronized、锁、线程启动与结束、并发容器也通过各自规则建立 happens-before。

Go 的结论类似但语法不同:如果多个 goroutine 并发访问同一位置且至少一个是写,必须使用 channel、syncsync/atomic 建立同步。官方内存模型给出的最好建议非常朴素:不要写需要反复推演内存模型才能证明正确的“聪明代码”。

锁的粒度取决于不变量和竞争特征。现实系统可以使用锁分段、读写锁和乐观并发;核心要求是:每一项共享状态必须有明确、始终一致的同步协议。多把锁共同保护一个不变量时,必须固定获取顺序并证明不会死锁。

Java:虚拟线程改变的是成本,不是正确性

虚拟线程已经在 Java 21 正式交付。对高并发 I/O 服务,直接、可调试的阻塞式代码可以为每个任务分配一个虚拟线程,Thread-Per-Task 不再天然昂贵。

但虚拟线程不是“更快的线程”,也不会让 CPU 密集型代码突破核心数。更重要的是,不能用线程池大小去限制数据库或第三方 API 的并发,因为虚拟线程本来就应当充足。对稀缺资源应使用 Semaphore、连接池或速率限制器做显式准入控制。

var permits = new Semaphore(64);

try (var executor = Executors.newVirtualThreadPerTaskExecutor()) {
    var future = executor.submit(() -> {
        permits.acquire();
        try {
            return callDownstream();
        } finally {
            permits.release();
        }
    });
    return future.get();
}

Java 25 中的 Structured Concurrency 仍是预览 API,不应写成已经永久定型的标准。但它代表了正确方向:父任务拥有子任务,退出作用域前等待它们完成;一个子任务失败时,兄弟任务可以被取消;超时和错误沿任务树传播,而不是留下无人管理的 Future。

Go:channel 是同步工具,不是可靠消息队列

Go 仍然擅长以 goroutine 和 channel 表达并发协作。发送与对应接收、关闭与观察到关闭之间可以建立 happens-before,这让 channel 不仅传值,也传递顺序。

但“通过通信共享内存”不是“所有共享状态都必须用 channel”。计数器、缓存和短临界区经常用 sync.Mutex 更清楚。选择标准是所有权:任务流和所有权移交适合 channel;同一对象的短时互斥适合锁;简单计数或状态位才考虑原子操作。

生产代码必须回答 channel 教程经常遗漏的问题:谁关闭 channel、缓冲区多大、消费者变慢时谁被阻塞、取消怎样传播、goroutine 怎样退出。context.Context 应沿调用链传递 deadline 与 cancellation;队列必须有界,否则“异步”只是把过载变成内存增长。

Python:GIL 不再是一句结论

对默认 CPython,I/O 密集任务仍适合 asyncio 或线程,CPU 密集的纯 Python 工作通常使用多进程、原生扩展或独立计算服务。但从 Python 3.13 开始,CPython 提供可选的 free-threaded 构建,可以关闭 GIL 并在多个核心上并行运行 Python 线程。它还不是“升级后自动变快”:部分扩展可能重新启用 GIL,线程安全与性能都需要重新测试。

在异步代码中,asyncio.TaskGroup 比散落的 create_task() 更适合表达一组同生共死的任务:离开作用域会等待所有子任务;首个非取消异常会取消其他任务并聚合异常。清理逻辑应放在 try/finally 中,收到 CancelledError 后通常应在清理完成后继续传播。

async def load_dashboard():
    async with asyncio.TaskGroup() as group:
        user = group.create_task(load_user())
        projects = group.create_task(load_projects())
    return user.result(), projects.result()

任何阻塞 I/O 都不应直接运行在事件循环里;可以使用原生异步驱动,或用 asyncio.to_thread() 隔离遗留阻塞调用。对 CPU 任务,则应根据运行时选择进程池、free-threaded 线程或外部执行器。

从并发模型走向结构化并发

Reactor、Future、Callback、Actor、CSP 仍然有价值,但它们回答的是不同问题:Reactor 管理就绪事件;Future 表示未来结果;Actor 把状态封装在消息接收者中;CSP 强调通过通信过程协作。

2026 年最重要的新共识是任务生命周期也必须被建模。一个并发任务不应比创建它的请求活得更久,除非它被明确移交给一个长期拥有者。结构化并发把任务组织成树,使完成、失败、取消和观测都有清晰父子关系。

从创建任务到可靠完成的生产并发闭环

生产级并发的八条检查线

  1. 先定义目标:是降低单请求延迟、提高吞吐,还是隔离故障?目标不同,模型不同。
  2. 区分任务类型:I/O 等待、CPU 计算、混合任务分别评估,不凭语言偏好选线程数。
  3. 限制在途数量:线程轻量不等于数据库连接、内存、文件描述符和 API 配额无限。
  4. 队列必须有界:容量、满载策略、优先级和丢弃语义都应显式设计。
  5. 传播 deadline 与取消:超时是预算,不是某一层随意设置的独立计时器。
  6. 明确状态所有权:优先不可变数据、单写者和消息传递;共享可变状态必须有同步协议。
  7. 让失败可观察:记录队列等待时间、在途任务、拒绝量、取消量、锁竞争和下游耗时,而不只看平均 QPS。
  8. 测试交错而非只测结果:配合 race detector、压力测试、故障注入和虚拟时间,覆盖取消、超时、重复执行与部分失败。

设计模式仍然有效,但要补上边界

Immutability 仍是降低共享复杂度的首选;Copy-On-Write 适合读多写极少的数据,不适合大型集合的频繁写入;ThreadLocal 必须考虑线程池复用与清理,在虚拟线程时代也不应拿来承载大型缓存;Worker Thread 的核心价值是资源隔离和容量控制,而不只是复用线程。

生产者-消费者模式最容易被误用。队列可以解耦生产和消费,却不能消灭速度差:当平均生产速度长期高于消费速度,任何有限队列都会满,任何无限队列都会耗尽内存。正确答案是背压、拒绝、降级、扩容或减少输入,而不是再加一层队列。

如何定义现代并发编程

并发编程不是“同时做更多事”,而是在有限资源和不确定失败下,管理多个任务的生命周期与状态关系

线程、锁、channel 和执行模型只是实现手段。作用域、取消、背压、资源预算和可观测性同样属于并发设计。工具变得更轻,创建并发变得更容易,这也让约束并发成为更重要的工程能力。

真正成熟的系统,不是能启动一百万个任务,而是知道其中多少应该启动、何时停止、失败影响谁,以及系统过载时如何保持可控。

参考资料

35 / 41

大模型真的理解世界吗?从下一个 Token 到智能的边界

大模型的底层确实是 Token 预测和矩阵运算,但这是否意味着它完全不理解?本文从 Transformer、内部表征、功能性理解、意识与具身经验出发,讨论今天的大模型究竟是什么。
2026/08/07 · 17 分钟阅读

当一个大模型能够写代码、分析合同、解释量子力学,甚至与你讨论“我是否拥有意识”时,人很容易产生一种直觉:屏幕后面似乎真的存在一个正在思考的主体。

但如果打开这个系统,沿着每一层计算向下追踪,我们看到的不是欲望、体验和意图,而是 Token、向量、参数、注意力权重,以及一轮又一轮的矩阵乘法。

于是一个问题出现了:

如果大模型的核心只是在预测下一个 Token,它到底是真的理解,还是仅仅非常擅长生成“看起来像理解”的答案?

我最初的观点很直接:现在的大模型不是真正的人工智能。它只是依靠概率预测下一个字符;参数更大、层数更多、注意力机制更复杂,说到底仍是不停做矩阵运算,程序本身并不懂。

这个直觉抓住了大模型最重要的技术事实,但还不够准确。经过重新梳理后,我更愿意把结论写成:

当前大模型当然属于人工智能,也表现出某种功能性理解;但没有证据表明它拥有人的主观意识、稳定自我和真实意图。它可以形成复杂的内部表征,却不等于像人一样生活在、体验过并理解这个世界。

它预测的不是字符,而是 Token

首先需要修正一个技术细节:现代大语言模型通常预测的不是“下一个字符”,而是下一个 Token

Token 是模型处理信息的离散单位。它可能是一个汉字、一个英文单词的一部分、标点、数字,也可能是一段代码符号。输入文本先被 Tokenizer 转换成 Token ID,再映射为高维向量。

大模型从上下文到下一个 Token 的生成过程

自回归生成的过程可以简化为:

已有上下文
→ Tokenization
→ Embedding
→ 多层 Transformer
→ 得到整个词表的概率分布
→ 选择一个 Token
→ 把新 Token 放回上下文
→ 重复

例如输入:

巴黎是法国的

模型不会从数据库中直接复制“首都”。它根据上下文计算词表中每个候选 Token 的概率。首都可能具有最高概率,但城市政治中心等也可能获得不同权重。采样策略再决定实际输出哪个 Token。

OpenAI 在 GPT-4 技术报告中也明确描述:GPT-4 是一个经过预训练、用于预测文档中下一个 Token 的 Transformer 模型。这不是贬低,而是它最核心的训练目标。

说到底,确实是矩阵运算

从物理执行层面看,我原来的判断没有错。大模型推理主要由这些运算组成:

  • 向量与矩阵乘法;
  • Attention 中的相似度计算;
  • Softmax 概率归一化;
  • Feed-Forward Network;
  • 非线性激活;
  • 残差连接与归一化。

在 Self-Attention 中,每个 Token 的表示会被投影成 Query、Key 和 Value:

Q = XWq
K = XWk
V = XWv

Attention(Q, K, V)
= softmax(QKᵀ / √d) V

这套计算回答的是:在生成当前表示时,上下文中的哪些 Token 更相关,应当聚合多少信息。

所谓“注意力”只是一个数学名称,不意味着模型像人一样集中精神;所谓“神经元”也只是受到生物神经网络启发的计算单元,不能直接等同于人脑细胞。

一层 Transformer 完成 Attention 与前馈计算,再把结果交给下一层。几十层甚至上百层重复后,模型得到下一个 Token 的概率。GPU 真正在做的,确实是规模巨大的线性代数。

但“底层是矩阵运算”不能终结讨论

如果文章到这里就得出“所以模型什么都不懂”,论证会出现一个问题:低层机制的描述,并不能自动否定高层能力。

音乐文件在硬盘里只是二进制,操作系统只是晶体管电位变化,人脑活动也可以被描述为神经元放电和化学信号。我们不会因为音乐最终是 0 和 1,就认为旋律不存在;也不会因为大脑遵循物理规律,就认为人的理解不存在。

真正需要讨论的不是“底层是不是数学”,而是:

这种数学系统在规模化训练后,形成了什么内部结构,又能够稳定完成什么任务?

这是“随机接龙器”说法最容易忽略的部分。

为了预测语言,模型不得不学习结构

如果训练数据只有几个句子,模型确实只能记忆局部共现。但当它要预测海量文本中的下一个 Token,仅靠简单词频远远不够。

为了降低预测误差,模型必须逐渐捕获:

  • 语法和指代关系;
  • 实体、属性与事件之间的关联;
  • 文章结构和写作风格;
  • 代码的语法、类型和调用关系;
  • 问题与常见解法之间的模式;
  • 人类在文本中留下的部分因果与世界知识。

例如要补全:

玻璃杯从桌边掉到水泥地上,接下来它很可能会____。

模型只有形成“玻璃脆、重力向下、撞击可能导致破碎”等关联,才能持续给出较好的预测。它不一定以人类概念的方式存储这些知识,但参数中会形成能够支持预测的分布式表示。

所以,“它只是预测下一个 Token”与“它学到了复杂表征”并不矛盾。恰恰因为预测任务足够困难,模型才被迫压缩语言和世界中可由语言反映的结构。

参数、层数和数据,分别做了什么

大模型能力不能只概括成“参数更多、神经元更多”。更完整的变量包括:

因素作用
参数规模提供存储和组合模式的容量
网络深度允许信息经历多级变换与抽象
Attention动态组合上下文中不同位置的信息
训练数据决定模型能够看到哪些语言、知识与偏差
训练目标决定系统被奖励学习什么能力
后训练塑造指令遵循、偏好、安全和工具使用行为
推理时计算通过搜索、验证和更多步骤改善结果
外部工具提供实时事实、计算、记忆和真实执行能力

参数不是一条条可直接读取的数据库记录。一个事实或能力通常分散在大量权重中,一个参数也会同时参与许多模式。

规模确实重要,但规模不是魔法。数据质量、训练方法、架构和评测共同决定最终能力。把所有进步都归因于“堆显卡和参数”,与把大模型神化为数字大脑一样,都过度简化了问题。

“理解”其实有三种不同含义

讨论大模型是否理解,最容易犯的错误,是双方使用同一个词,却在谈不同的东西。

第一层:统计与结构理解

模型能否识别语言中的结构、关系和规律?

在这一层,大模型显然具有很强的能力。它能识别语义相似性、转换表达、跟踪代码依赖、提取合同条款,并组合训练中学到的模式。

第二层:功能性理解

模型能否把概念应用到新任务,解释原因,根据反馈修正方案,并完成过去需要人类认知能力的工作?

在许多领域,现代大模型已经表现出一定程度的功能性理解。它可能在一个从未见过的代码仓库里定位错误,或者根据一组约束生成可执行方案。

这种能力不能因为底层是概率就被简单抹去。天气预报也是概率系统,但预测仍然可能包含真实价值。

第三层:主体性理解

模型是否知道自己在做什么?是否拥有感受、意图、自我、欲望和第一人称体验?

在这一层,目前没有可靠证据证明大模型具有人的理解。

它说“我很害怕被关闭”,并不能证明它体验到了恐惧。更可能的解释是:当前上下文使这类表达具有较高概率。语言模型可以生成关于疼痛的精确描述,但没有身体损伤、神经系统和痛觉体验。

因此我认为,最准确的区分是:

大模型已经表现出统计结构理解和部分功能性理解,但没有被证明拥有主体性理解。

语言形式与现实意义之间还有一道鸿沟

Bender 与 Koller 在《Climbing towards NLU》中区分了语言的形式意义

文本训练让模型看到的是形式:字符、词、句子以及它们之间的关系。而人的意义还来自语言与世界、意图和共同经验之间的联系。

一个人理解“火很烫”,不仅因为见过这句话,还可能因为靠近过火、感受过温度、被警告过危险,并知道这句话在具体环境中会改变行动。

纯文本模型没有这种生活史。多模态训练让模型接触图像、声音和视频;机器人和工具调用让它获得有限的环境反馈。但“接收传感器数据”仍不自动等于拥有人的身体经验。

这也是为什么大模型有时能写出极其深刻的解释,却在一个很简单的常识变体上失败:它拥有强大的模式与表征,但这些表征并不总是稳定地锚定在现实世界中。

今天的模型已经不只靠预训练

“大模型就是下一个 Token 预测器”描述了基础模型的核心,却没有覆盖现代 AI 系统的全部能力。

今天的系统还会加入:

  • 监督微调和偏好优化;
  • 强化学习与可验证奖励;
  • 推理时搜索和多候选比较;
  • 检索增强生成;
  • 代码执行、计算器和业务工具;
  • 多模态输入与环境反馈;
  • Agent 的状态、计划、审批和结果验证。

不过,这些增强大多没有把模型变成拥有意图的主体。它们更像给概率模型增加了外部记忆、传感器、执行器和校验系统。

模型本身不会因为能调用邮件 API,就突然“想要”给客户发邮件。目标来自人、系统指令或奖励函数;权限来自外部 Policy;结果是否正确仍需要评测和现实反馈。

它为什么会一本正经地胡说?

下一个 Token 训练解释了大模型最典型的缺陷:它首先被优化为生成一个在上下文中合理的后续,而不是保证每句话都对应可验证事实。

当模型缺少知识时,“继续生成”通常仍比“保持沉默”更符合生成过程。因此它可能构造不存在的论文、API 或事件,而且表达得非常流畅。

这不意味着模型永远不能可靠,而是说明可靠性不能只依赖语言表面。生产系统需要:

模型提出判断
→ 检索或工具获取事实
→ 结构化约束
→ 规则与评测验证
→ 高风险动作人工审批

把大模型当作有概率误差的推理组件,比把它当作“无所不知的数字员工”更符合工程现实。

它究竟算不算真正的人工智能?

如果人工智能的定义是“由机器完成通常需要人类智能的任务”,大语言模型显然属于人工智能。说它“不是 AI”在学术和工程定义上都站不住脚。

但如果“真正的智能”意味着:

  • 持续存在的自我;
  • 来自身体和环境的经验;
  • 自己形成的目标与价值;
  • 对行为后果的真实关切;
  • 主观感受与意识;

那么今天的大模型距离这种人类式智能仍然很远,而且我们甚至没有统一方法判断机器是否拥有主观体验。

问题不在于它是“智能”还是“完全不智能”这两个极端,而在于智能可能本来就是多维的:语言、预测、规划、学习、具身、社会关系、自我和意识并不是同一个能力。

大模型在其中一些维度非常强,在另一些维度几乎没有可靠证据。

我的最终观点

现在我不会再说“大模型只是概率,所以根本不懂”。“只是”这个词掩盖了规模化预测能够产生的复杂能力。

我也不会说“大模型已经像人一样理解世界”。流畅语言会诱导人类把主体、感情和意图投射到程序上,而目前的技术证据不足以支持这种判断。

我更愿意这样描述它:

大语言模型是一种通过大规模数据和计算训练出来的高维概率系统。它的核心目标是预测 Token,底层执行矩阵运算;但在完成这一目标的过程中,它形成了支持语言、知识、推理和工具使用的复杂内部表征。它可以表现出功能性理解,却没有被证明拥有人的主观意识、稳定自我和真实意图。

这个结论并不会削弱大模型的价值。飞机不需要像鸟一样扇动翅膀,才能真正飞行;机器也不一定需要复制人脑,才能完成有价值的智能任务。

但我们必须清楚它是什么,才能知道应该相信它到什么程度、把什么权力交给它,以及哪些责任永远不能推给它。

真正值得追问的,也许不是“它到底像不像人”,而是:

当一个没有被证明拥有意识的概率系统,已经能够完成越来越多智能任务时,我们是否需要重新定义智能本身?

延伸阅读

36 / 41

LangChain 与 LlamaIndex:如何选择,以及如何构建生产级 RAG

从框架定位、真实应用场景到完整 RAG 链路,系统比较 LangChain、LangGraph 与 LlamaIndex,并梳理解析、切块、混合检索、重排、引用、评测和权限治理。
2026/08/07 · 17 分钟阅读

LangChain 和 LlamaIndex 经常被放在一起比较,因为两者都能连接模型、向量数据库和外部工具,也都能构建 RAG 与 Agent。但“LangChain 做 Agent,LlamaIndex 做 RAG”只是一个粗略起点,不能作为完整的技术结论。

今天的 LangChain 更接近面向 Agent 的高层框架:提供模型、工具、中间件和预构建 Agent 循环;复杂、有状态、可恢复的编排由底层 LangGraph 承担。LlamaIndex 则以数据为中心:围绕 Document、Node、Ingestion Pipeline、Index、Retriever、Query Engine 建立完整抽象,同时也提供 Workflows、FunctionAgent、ReActAgent 和多 Agent 能力。

真正的选择题不是“哪个框架更强”,而是:系统最难的部分是数据进入、检索与证据组织,还是工具决策、状态流转与长任务编排?

LangChain、LangGraph 与 LlamaIndex 的能力边界

一张更准确的对比表

维度LangChain / LangGraphLlamaIndex
核心定位LangChain 提供 Agent 与模型/工具集成;LangGraph 提供有状态编排运行时面向私有数据的上下文工程、索引、检索、查询与工作流
主要抽象Model、Tool、Middleware、Agent;State、Node、EdgeDocument、Node、Transformation、Index、Retriever、Query Engine、Workflow
RAG支持加载、切块、向量库、Retriever、2-Step/Agentic/Hybrid RAG数据摄取、元数据、索引、检索、合成和评测抽象更集中
Agent高层 create_agent,底层 LangGraph 支持持久化、流式、人机协同与恢复FunctionAgent、ReActAgent、AgentWorkflow 与事件驱动 Workflows
适合的复杂度工具选择、条件分支、循环、审批、长任务状态异构数据接入、复杂检索、文档关系、查询引擎与数据 Agent
可观测性LangSmith 与 LangGraph 状态轨迹集成紧密Callback/Instrumentation,并可接入多种观测平台
使用建议业务流程和 Agent 行为是系统核心时优先私有数据质量和检索链路是系统核心时优先

这里最重要的是避免两个误区。

第一,LlamaIndex 不等于“向量索引工具”。它覆盖数据摄取、转换、存储、查询、响应合成、评测和 Agent 工作流。第二,LangChain 不等于早期的“Chain 拼接库”。LangChain 1.x 的 Agent 运行在 LangGraph 之上,LangGraph 才是需要精细控制状态、循环、持久化和恢复时的低层入口。

用场景而不是功能清单做选择

场景一:企业知识库与制度问答

核心难点通常是 PDF/Office 解析、版本管理、权限过滤、章节结构、混合检索、引用定位和检索评测。此时优先使用 LlamaIndex 往往更自然,因为它的数据与检索抽象集中,Ingestion Pipeline 还能处理转换缓存、去重和增量更新。

但如果只是一个固定的“检索一次再回答”流程,原生代码或 LangChain、LlamaIndex 中任意一个都能完成。不要为了框架而框架化。

场景二:多工具业务 Agent

例如一个售后 Agent 需要查询订单、读取知识库、判断退款条件、发起审批、等待人工确认、调用支付系统并记录结果。难点是状态机、工具权限、循环上限、失败恢复和 Human-in-the-loop。此时 LangChain Agent + LangGraph 更贴合问题结构。

场景三:数据研究与报告生成

Agent 需要先判断问题,调用文档检索、SQL、Web API,再迭代补证据并生成带引用报告。可以用 LlamaIndex 构建高质量检索工具,用 LangGraph 管理研究步骤、状态、审批和恢复。混用是合理的,但必须保持边界:LlamaIndex 暴露稳定 Retriever/Query Engine 接口,编排层只消费结构化结果,不直接操作索引内部对象。

场景四:检索本身就是产品

当产品提供按租户、时间、类别和权限组合过滤,支持多索引路由、父子块检索、Graph RAG 或多模态文档时,数据层复杂度远高于 Agent。优先围绕 LlamaIndex 或独立搜索服务建设检索平台,再把它作为工具提供给任意 Agent 框架。

RAG 不是一条箭头,而是两条生命周期

一个完整 RAG 系统包含离线摄取和在线回答两条链路,并由评测反馈闭环连接。

离线摄取:
数据源 → 解析/OCR → 清洗与结构恢复 → 元数据/权限 → 切块
      → Embedding + 关键词索引 → 版本化存储 → 质量检查

在线回答:
问题 → 安全与权限 → 查询理解/改写 → 路由 → 混合召回
    → 融合/去重 → Rerank → 上下文组装 → 有依据生成
    → 引用校验/拒答 → 响应

持续闭环:
真实问题 + 标注集 → 检索评测 → 生成评测 → 线上监控 → 失败样本回流

生产级 RAG 的端到端链路

只画“文档 → Embedding → 向量库 → LLM”会漏掉生产中最容易出错的部分:文档版本、访问控制、查询改写、关键词召回、重排、上下文预算、引用映射、拒答和评测。

1. 数据摄取:先保证证据正确

RAG 的上限首先由数据决定。PDF 解析不能只抽取连续文本:标题层级、页码、表格单元格、图注、脚注和阅读顺序都可能影响答案。扫描件需要 OCR,复杂版式可以选择 LlamaParse、Unstructured 或经过验证的专用解析器,但必须用自己的文档集比较字段完整率和版面恢复率。

每份文档至少保留:稳定 document_id、来源、租户、权限标签、版本、生效时间、更新时间、标题层级、页码/锚点和内容哈希。删除或更新文档时,要能精确删除旧 chunks,而不是让向量库永久积累幽灵内容。

摄取流程应当幂等、可重放、可观测。解析器、切块器和 Embedding 模型都要记录版本;变更其中任一步时,应知道哪些文档需要重建。

2. Chunking:不存在通用的 512-1024

固定 token 窗口可以作为基线,但不能把 512-1024 tokens + 10%-20% overlap 当成最佳答案。合适粒度取决于文档结构、查询类型、Embedding 模型和生成上下文。

更可靠的策略是:

  • 优先按标题、段落、列表、代码块和表格等语义边界切分;
  • chunk 保留父文档、章节路径、页码和相邻关系;
  • 用小块提高召回精度,再按父章节或邻居块扩展生成上下文;
  • 表格、代码和 FAQ 使用专门切分规则,不强行套统一长度;
  • 在真实问题集上对 chunk size、overlap 和 parent-child 策略做消融实验。

Overlap 能缓解边界断裂,但会增加索引、召回重复和上下文浪费。只有评测证明有收益时才扩大 overlap。

3. Embedding 与索引:语义检索不是唯一通道

Embedding 模型要按语言、领域、维度、成本和部署方式评估。BGE-M3 等多语言模型可以作为候选,但不能只凭排行榜决定。应建立包含中英文、缩写、产品名、编号、长尾表达和困难负样本的检索集,测 Recall@K、MRR 或 NDCG。

索引通常至少包含两路:

  • 稠密向量检索处理语义相似和口语表达;
  • BM25/关键词检索处理精确术语、编号、人名、错误码和稀有实体。

两路结果可以用 Reciprocal Rank Fusion 等稳定方法融合。元数据过滤应尽可能在召回前执行,尤其是租户、ACL、生效时间和数据类型;不要先召回无权内容再在 Prompt 前删除。

4. 查询理解与路由

用户问题未必适合直接 Embedding。多轮对话需要把代词和省略信息改写成独立查询;复杂问题可能需要拆解;明确的编号查询应提高关键词权重;涉及结构化事实时应路由到 SQL 或 API,而不是强行向量搜索。

查询改写必须保留原始约束,不能为了“更容易检索”而改变用户意图。高风险系统应记录原问题、改写结果、路由决定和模型版本,方便追踪错误发生在哪一步。

5. 召回、融合与 Rerank

第一阶段召回追求覆盖率,可以从多个通道取较大的候选集;第二阶段用 cross-encoder 或专用 reranker 按 query-document 相关性精排,再选取进入上下文的证据。

Top-K = 3-5 不是固定最佳实践。最终数量取决于证据密度、文档重复度、上下文窗口和问题是否需要多来源综合。更好的做法是:先召回较多候选,重排和去重,再按 token 预算、分数阈值与证据覆盖动态截断。

Reranker 解决相关性排序,不负责权限、时效和业务资格。确定性约束必须由过滤规则执行。

6. 上下文组装:把证据变成可消费输入

上下文不是把 Top-K 直接拼接。组装器需要:去重、恢复标题路径、合并相邻块、保留来源编号、控制单一文档占比,并避免在 token 截断时切掉关键结论。

建议为每个证据块分配稳定引用 ID,并携带标题、URL/文件、页码、更新时间和权限安全的片段。Prompt 应明确要求只依据证据回答、区分事实与推断、证据不足时拒答,并输出可解析的引用结构。

但 Prompt 不能真正消除幻觉。“文档中未找到”必须由检索置信度、证据覆盖和生成后引用校验共同支持,而不是只写一句系统提示。

7. 生成、引用与拒答

生成阶段至少区分三种结果:有充分证据并回答;证据部分充分,回答已知部分并说明缺口;证据不足,拒绝作答并建议澄清或转人工。

引用校验应检查:每个关键结论是否有引用、引用片段是否真的支持结论、引用是否仍在授权范围内。高风险场景还需要规则校验、结构化输出验证或人工审批。

答案不是 RAG 的唯一输出。调试和审计所需的 retrieval trace、候选分数、过滤原因、模型版本与延迟,应进入内部观测系统,但不能向终端用户泄露敏感元数据。

8. 评测:先分层,才能知道改哪里

至少建立四层指标:

层级关键指标回答的问题
解析/切块字段完整率、结构保真、chunk 覆盖正确证据有没有进入索引
检索Recall@K、MRR、NDCG、过滤正确率正确证据有没有被找到并排在前面
生成Faithfulness、引用正确率、完整性、拒答准确率答案是否真正被证据支持
系统P50/P95 延迟、成本、失败率、缓存命中、权限违规系统是否可稳定、安全地运行

离线评测集应来自真实问题,并包含无答案问题、模糊问题、跨文档问题、版本冲突和权限隔离案例。线上反馈不能只看点赞率:还应分析改写率、重复提问、转人工率和引用点击。

什么时候混用,什么时候不要混用

混用的合理边界是:LlamaIndex 作为独立的摄取与检索模块,向 LangGraph 暴露一个带结构化输入输出的检索工具;LangGraph 负责决定何时检索、是否补充查询、是否调用其他工具,以及如何处理审批和恢复。

LangGraph / LangChain Agent
  ├─ KnowledgeSearchTool → LlamaIndex Retriever / Query Engine
  ├─ SQLTool
  ├─ BusinessAPITool
  └─ HumanApproval

不要混用的情况也很明确:一个固定的 2-Step RAG 如果单框架几十行代码就能完成,加入两套抽象只会增加版本冲突、Tracing 割裂、类型转换和调试成本。先保持最小系统,等数据层与编排层都出现独立复杂度后再拆分。

最终选择建议

  • 固定知识库问答、复杂文档和高级检索占主导:优先 LlamaIndex。
  • 多工具 Agent、条件分支、循环、持久状态和人工审批占主导:优先 LangChain + LangGraph。
  • 简单 2-Step RAG:两者都可以,甚至可以直接使用模型 SDK + 搜索服务。
  • 复杂数据 Agent:LlamaIndex 管数据与检索,LangGraph 管任务生命周期,是清晰但并非强制的组合。

框架选择只决定开发体验,不决定 RAG 质量。真正决定上线效果的是证据质量、权限边界、召回与重排、拒答策略、评测集和持续观测。先把这些工程契约定义清楚,再选择最贴合主要复杂度的框架。

参考资料

37 / 41

如何构建 AI 原生团队:不是给旧流程加 AI,而是重写工作系统

从一次新电脑配置经历出发,讨论 AI 原生团队如何重构目标、工作流、人机职责、组织记忆与治理,并给出一份可执行的 90 天路线图。
2026/08/06 · 16 分钟阅读

换新电脑时,我习惯先恢复开发环境:GoLand、IntelliJ IDEA、VS Code、JDK、Python、Node.js、MySQL、Redis、Docker、Postman……过去这通常是一场持续两三天的安装仪式。

这一次,装到一半我突然停了下来。

GoLand,我上次是什么时候打开的?IDEA 呢?那些曾经代表工程师生产力的工具,为什么已经很久没有成为我的工作入口?

答案并不是我不再写代码,而是写代码这件事正在发生结构性变化。我越来越多地描述目标、提供上下文、审查方案和验证结果;Agent 阅读仓库、修改代码、运行测试并处理重复执行。语言和框架仍然重要,但它们逐渐从“我必须亲自操作的工具”,变成“我必须能够判断的执行环境”。

那一刻我意识到:变化的不只是 IDE,而是工作的基本单元。

这个变化也不会停留在研发团队。如果 AI 已经能够理解上下文、调用工具、执行多步任务并根据结果调整计划,那么组织面对的问题就不再是“要不要给员工配一个 AI 助手”,而是:

当 AI 可以成为业务执行单元,我们应该怎样重新设计团队?

AI 赋能不等于 AI 原生

很多公司的 AI 转型从采购工具开始,也停在采购工具结束。会议纪要自动生成了,文案可以批量写了,程序员有了代码补全,管理层看到了使用次数增长,于是组织宣布自己已经“AI 化”。

但旧流程没有改变:任务仍然层层转述,信息仍然分散在聊天记录里,决策仍然依赖会议,人仍然是每一步的传送带,AI 只是在局部让传送带跑得快一点。

AI 原生的区别,是从一开始就把 AI 当作系统参与者来设计。

AI 赋能AI 原生
给旧流程增加助手围绕目标重新设计流程
AI 生成,人继续搬运AI 在授权范围内直接执行
Prompt 属于个人技巧Context 成为组织资产
关注使用人数和调用次数关注交付质量、周期与成本
出错后靠人补救预先设计评测、权限和接管
知识散落在文档与个人脑中知识可检索、可版本化、可复用

判断一家公司是否 AI 原生,可以问一个简单的问题:

如果把 AI 从核心工作流中拿掉,这套流程只是慢一点,还是根本无法按原方式运转?

只是慢一点,通常仍是 AI 赋能;必须重新设计,才说明 AI 已经进入组织结构。

团队需要一套新的工作操作系统

AI 原生不是单个工具项目,而是五层工作系统的共同变化。

AI 原生团队的五层工作操作系统

第一层:目标

Agent 可以高效执行错误目标,所以目标定义反而比以前更重要。每项任务至少需要说明:要解决什么问题、对谁产生价值、约束是什么、怎样才算完成。

“研究一下竞争对手”不是目标;“比较三家竞争产品的定价、核心工作流与用户差评,并给出我们下季度最值得验证的两个差异化假设,每个结论附证据”才是可执行目标。

第二层:工作流

不要把 AI 塞进旧流程的某一个节点,而要从结果倒推整条链路。哪些步骤可以并行?哪些信息可以自动收集?哪些判断必须由人完成?失败后如何回退?输出如何进入下游系统?

第三层:人机职责

不是讨论“AI 替代哪个岗位”,而是重新划分每类工作中的判断与执行。

人更适合负责目标、品味、优先级、责任、关系和高风险例外;Agent 更适合负责搜索、整理、生成、批处理、状态同步和可验证的执行。

第四层:组织记忆

如果每次新对话都要重新解释公司是谁、产品怎么做、哪些决策已经否决,那么 AI 只是一名每天失忆的实习生。组织需要把原则、业务词典、流程、历史决策、示例、反例和权限沉淀为可检索、可更新的 Context。

第五层:评测与治理

没有评测,团队只能凭“感觉更快了”判断价值;没有治理,效率越高,错误扩散越快。评测、权限、审计、降级和人工接管必须与工作流同时设计。

新的基本工作单元:一个人带着一组 Agent

传统组织通过增加人手扩大执行能力:一个负责人带几名经理,经理再带执行者。信息在层级间传递,协调成本随人数增长。

AI 原生团队更像由许多“小型人机单元”组成。一个人可以同时调度研究、数据、内容、开发或运营 Agent;人保留目标所有权,Agent 扩大执行带宽。

人和 Agent 的目标、执行、验证与学习闭环

关键不是 Agent 数量,而是职责是否清楚:

人:定义目标 → 提供边界 → 审查关键判断 → 对结果负责
Agent:制定计划 → 调用工具 → 执行任务 → 提交证据
系统:记录过程 → 自动评测 → 控制权限 → 触发接管

一个常见误区是过早搭建复杂的多 Agent 网络。任务边界清晰时,固定工作流通常比自主协作更稳定;单 Agent 能解决的问题,也没有必要拆成五个角色。只有当任务天然包含并行专业分工、上下文隔离或独立验证时,多 Agent 才真正创造价值。

复杂度应该由问题推动,而不是由技术兴奋推动。

六条工作流设计原则

1. 从验收标准开始

先定义什么是完成,再选择模型和工具。能够自动验证的任务最适合优先 Agent 化,例如测试通过、数据对账一致、字段完整、引用可访问。

2. Context 是资本

高质量输出不仅来自更好的模型,也来自更完整、更准确的上下文。团队需要像管理代码一样管理 Context:有来源、有版本、有负责人、有过期机制。

3. 先使用简单、可组合的模式

确定性任务使用代码和工作流;需要模糊判断的节点才调用模型;只有路径无法预先确定时,才把决策权交给 Agent。简单系统更容易评测、定位失败和控制成本。

4. 自动化程度必须与风险匹配

低风险、可逆、可验证的动作可以自动执行;高风险、外部可见或不可逆的动作必须审批。不要用同一种自治等级处理“整理会议记录”和“向客户发送合同”。

5. 每一步都必须可观察

至少记录任务目标、使用的 Context、模型和工具版本、关键决策、执行结果、人工干预和成本。否则失败发生时,团队只能反复猜测。

6. 失败要进入学习闭环

一次人工修正如果没有沉淀为规则、示例或评测样本,下次还会发生。真正的组织学习,是把个体纠错转化为系统能力。

不要先建立一个孤立的“AI 部门”

AI 转型如果完全交给独立创新团队,容易出现两种结果:创新团队做出漂亮 Demo,但不理解业务约束;业务团队把 AI 当成外部项目,不对结果负责。

更有效的结构包含四类责任主体:

管理层:目标与边界

明确为什么转型、优先改造什么、允许承担什么风险,并亲自使用新的工作方式。管理层只要求下属用 AI,自己仍靠会议和逐级汇报,组织会迅速识别这种不一致。

AI 平台小组:共享基础设施

负责模型接入、权限、工具、知识、评测、成本和安全底座。它不替业务团队做场景,而是降低每个业务团队重复建设的成本。

业务团队:结果所有者

最了解流程的人最适合发现 Agent 的价值点。业务负责人必须拥有流程改造权,也必须对质量和结果负责,不能把责任转移给模型或平台团队。

AI Champions:组织传播节点

从真实业务中选出一批实践者,帮助同事跨过使用门槛、分享成功与失败案例、连接平台能力。Champions 是催化剂,不是新的审批层。

找到第一个值得改造的工作流

第一步不要追求“全员 AI 化”,而要找到一个足够真实、又能控制风险的样板。

优先选择同时满足四个条件的任务:

  1. 高频:每周甚至每天重复发生;
  2. 耗时:占用大量搜索、整理、复制和协调时间;
  3. 可验证:输出质量有相对清晰的标准;
  4. 可控:失败成本低,或者能够在执行前拦截。

可以用一个简化公式排序:

机会分 = 频率 × 单次耗时 × 可验证性 × 可复用性 ÷ 风险

选定场景后,不要只比较“使用 AI 前后节省了多少分钟”。还应记录首次通过率、返工次数、人工接管率、单位结果成本和交付周期。如果速度提高一倍,但复核成本增加三倍,这不是成功。

把 Prompt 库升级为组织 Context

Prompt 模板有价值,但它只是最浅的一层。成熟的组织 Context 至少包括:

组织原则:我们如何做取舍,什么绝不允许
业务词典:产品、客户、指标和领域概念
流程说明:任务步骤、输入输出和负责人
历史决策:做过什么选择,为什么
示例与反例:什么是好结果,什么是常见失败
工具与权限:Agent 能访问和修改什么
评测集:真实任务、标准答案和失败边界

这些内容必须持续维护。过期 Context 比没有 Context 更危险,因为它会让 Agent 稳定地产生错误结果。

组织记忆也不等于把所有文件扔进向量数据库。不同知识有不同生命周期和权限:政策可能按月更新,产品指标按天更新,人事信息严格分级,架构决策需要版本化。检索只是入口,治理才是核心。

治理不是减速器,而是规模化的前提

当 Agent 只能生成一段文本时,风险主要是内容质量;当它可以发送邮件、修改数据库、部署代码或操作客户系统时,风险变成真实行动。

建议按动作而不是按工具设计权限:

权限级别适用动作处理方式
自动允许读取公开资料、生成草稿、运行只读分析自动执行并记录
条件允许修改内部文档、运行测试、创建工单满足规则后执行
执行前审批对外发送、生产变更、资金或合同动作人工确认计划与影响
禁止绕过审计、扩大自身权限、访问无关敏感数据系统硬阻断

同时设计四项能力:最小权限、完整审计、可随时停止、可恢复到安全状态。

人工接管也不是失败。真正危险的是系统不知道什么时候应该请求帮助。目标模糊、信息冲突、权限不足、风险升高或连续验证失败时,Agent 应主动暂停,并把已经完成的工作、证据和待决问题一起交给人。

一份务实的 90 天路线图

AI 原生团队的 90 天落地路线图

第 1–30 天:诊断与点火

  • 选定一个业务团队,而不是同时推动全公司;
  • 梳理三个高频工作流,记录当前周期、成本和质量基线;
  • 确定 2–3 个标配工具和明确的数据使用边界;
  • 选出业务负责人、平台伙伴和 AI Champion;
  • 改造一个低风险、高频、可验证的样板场景。

阶段交付物:现状基线、场景优先级、工具与数据规范、首个可运行工作流。

第 31–60 天:流程与知识

  • 将样板扩展到三个真实工作流;
  • 为每个工作流定义目标、输入、输出、权限和接管条件;
  • 建立最小组织 Context 和经过验证的示例库;
  • 从真实失败中建立第一版评测集;
  • 每周复盘成功与失败,不只分享“神奇 Demo”。

阶段交付物:三个工作流 SOP、Context v1、评测集 v1、周度质量报告。

第 61–90 天:制度化与扩展

  • 将评测接入每次模型、Prompt 和流程变更;
  • 建立权限审批、审计、成本和事故响应机制;
  • 比较改造前后的周期、质量、成本与接管率;
  • 沉淀可复用组件,而不是复制整套流程;
  • 根据证据决定扩大、调整或停止哪些场景。

阶段交付物:评测看板、治理机制、季度复盘和下一阶段路线图。

应该衡量什么

“多少人使用 AI”“调用了多少 Token”是采用指标,不是价值指标。

更值得关注的是:

  • 交付周期:从任务提出到可用结果需要多久;
  • 首次通过率:结果无需返工即可验收的比例;
  • 单位结果成本:模型、人工复核和系统成本的总和;
  • 人工接管率:哪些场景频繁需要人,以及为什么;
  • 失败恢复时间:发现问题后多久回到安全状态;
  • 可复用率:有多少能力被其他团队直接复用;
  • 业务结果:收入、转化、质量、客户满意度或风险是否改善。

指标的目的不是证明 AI 正确,而是帮助组织持续决定:什么应该自动化,什么应该继续由人负责,什么根本不值得做。

AI 原生最终放大的仍然是人的判断

AI 会持续降低执行成本,但目标不会自动变得正确,品味不会自动出现,责任也不会转移给模型。

未来优秀团队的差异,未必来自谁拥有更多 Agent,而来自谁能更清楚地定义问题、更高密度地提供 Context、更快地验证结果,并把每一次失败沉淀成组织能力。

所以,AI 原生团队并不是简单追求“更少的人”。

它是一种让人的判断可以被更大规模执行,同时仍然保持可控、可验证和可负责的组织方式。

回到那台新电脑,我最终没有装回所有旧工具。不是因为它们失去了价值,而是因为我的角色已经从“操作每一件工具”,逐渐变成“设计一套能让人和 AI 共同工作的系统”。

对一个团队来说,真正的 AI 原生转型,也从这个角色变化开始。

延伸阅读

38 / 41

从 Query 理解到知识驱动推荐:一套可演进的财税搜索架构

复盘 2022 年的一次财税产品技术设计,并将 Query 理解、混合检索、知识结构化、重排与评测重新组织成一套面向今天的生产架构。
2026/08/06 · 14 分钟阅读

2022 年,我为一个财税新产品整理过一份技术方案。当时讨论了 Query 理解、推荐架构和财税知识碎片化,也列出了分词、意图识别、召回、排序、知识抽取等大量算法。

几年后重新看这份方案,具体模型早已不是最重要的部分。真正经得起时间检验的,是当时做出的一个优先级判断:

财税知识结构化 > Query 理解 > 推荐排序。

这不是说排序不重要,而是说在强领域、强时效、强约束的财税场景里,系统上限首先由它能否正确表达知识决定,其次由它能否正确理解用户问题决定,最后才是如何把候选结果排得更好。

如果知识源不完整,Query 理解再准确也只能召回残缺答案;如果没有识别地区、主体类型和生效时间,模型越自信,风险反而越高;如果前两层没有做好,复杂的推荐模型只是在更精确地放大错误。

从 2022 年算法模块堆叠到知识驱动检索系统的演进

财税搜索真正困难的地方

通用搜索经常在“相关性”上竞争,而财税搜索必须同时满足五类约束。

第一,用户表达往往不完整。“小规模怎么开票”“重庆研发费用怎么扣”“个税还能退吗”都不是完整的业务问题。主体是谁、发生在什么时间、适用哪个地区、属于哪类业务,可能没有直接写在 Query 里。

第二,专业词汇具有强领域含义。一个词在日常语言、会计语言和法规语言中的含义可能完全不同,同一个概念还可能存在俗称、旧称、缩写和政策原文等多种表达。

第三,答案具有时效性。财税知识不是静态百科。政策有发布、生效、废止和过渡期,地方口径也可能不同。相关但已经失效的答案,不是低质量答案,而是错误答案。

第四,结果存在多目标权衡。用户既需要权威法规,也需要读得懂的解读和可执行的操作指引。系统必须在权威性、相关性、可读性、时效性与个性化之间做显式权衡。

第五,输出必须可追溯。用户可以接受系统说“我无法确定”,却不应该接受一段无法指出依据的确定性回答。

所以,财税搜索不是“把文档放进向量数据库,再让大模型回答”。它是一套从知识治理到查询理解、从多路召回到风险控制的决策系统。

Query 理解的输出不应该只是一组标签

传统 Query 理解常被拆成预处理、分词、纠错、扩展、实体识别和意图分类。这些能力仍然有用,但生产系统真正需要的是一个稳定、可审计的结构化查询对象。

例如,用户输入:

重庆小微企业今年增值税怎么交?

系统内部可以得到:

{
  "rawQuery": "重庆小微企业今年增值税怎么交?",
  "normalizedQuery": "重庆 小微企业 2026 增值税 申报缴纳",
  "intent": "tax_policy_and_procedure",
  "entities": {
    "region": "重庆",
    "taxType": "增值税",
    "businessType": "小微企业"
  },
  "constraints": {
    "effectiveAt": "2026-08-06",
    "authorityLevel": ["国家", "重庆"]
  },
  "rewrites": [
    "重庆小微企业增值税优惠政策",
    "重庆小微企业增值税申报流程"
  ],
  "confidence": 0.91,
  "needsClarification": false
}

这个对象比“意图=政策查询”更有工程价值。它可以被召回、过滤、重排、回答生成、日志和评测共同消费,也能清楚说明系统在哪一步理解错了。

当置信度不足或缺少决定性条件时,正确动作不是强行猜测,而是请求补充信息。例如“公司买车怎么抵扣”至少需要确认主体、用途、发票类型和业务发生时间。

用可观测流水线代替算法堆叠

我在 2022 年方案里采用了 Pipe-Filter 思想:一个稳定基座承载数据流,每种算法作为可插拔 Filter 接入。这个思想仍然适用,但今天更重要的是为每个阶段定义输入输出契约、评测方法和降级策略。

财税 Query 从理解到输出的生产流水线

一条生产级 Query 流水线可以这样组织:

  1. 输入规范化:字符、单位、日期、法规编号、地区别名和企业类型规范化。
  2. 安全与范围识别:识别敏感输入、越权请求和产品不能回答的问题。
  3. 意图与实体解析:提取任务目标、业务实体、时间与地域约束。
  4. Query 改写与拆解:纠错、同义表达、专业术语映射;复杂问题拆成多个可检索子问题。
  5. 多路召回:关键词、语义、规则、知识关系和行为数据并行召回。
  6. 融合与去重:合并不同召回通道,避免单一分数体系支配结果。
  7. 重排与业务约束:结合语义相关性、权威等级、时间有效性和用户上下文精排。
  8. 可信度校验:检查证据覆盖、政策状态、引用一致性与冲突来源。
  9. 结果呈现:返回答案、证据、适用范围、不确定性和下一步操作。

每个 Filter 都应记录版本、耗时、输入摘要、输出摘要与失败原因。出现超时或模型不可用时,系统可以退回关键词搜索和规则过滤,而不是让整条链路失效。

多路召回:不要在关键词和向量之间二选一

财税检索天然适合混合架构。

关键词召回擅长法规编号、税种、专业术语、精确短语和数值条件。BM25 仍然是重要基线,不能因为有了 Embedding 就被抛弃。

向量召回擅长口语表达、概念近义和没有共享关键词的语义匹配。例如“员工出差住酒店开的票能不能抵”与“住宿服务增值税进项税额抵扣”在字面上差异很大,但语义高度相关。

规则召回处理不能模糊化的硬约束,例如地区、生效日期、企业资格和政策状态。

知识关系召回适合沿着“政策—税种—主体—业务事项—材料—办理流程”等关系寻找上下游信息。

行为召回只有在拥有足够、合规且去偏的真实反馈后才值得引入。点击并不天然代表答案正确,停留时间也可能来自内容难懂,因此行为信号必须经过业务解释。

多个召回通道不应简单拼接。可以先用 Reciprocal Rank Fusion 等方法进行稳定融合,再用重排模型处理 Top-K 候选。融合阶段追求不漏,重排阶段追求次序,业务规则负责守住不能被相关性覆盖的边界。

推荐不是一个模型,而是一段决策过程

原方案中使用“推荐算法 + 召回 + Rank”概括工业级推荐架构。今天我会把它表达得更明确:

候选生成
  → 资格过滤
  → 去重与多样性控制
  → 粗排
  → 精排
  → 业务约束
  → 解释与展示

候选生成解决“可能有什么”;过滤解决“哪些绝对不适用”;排序解决“哪个更值得先看”;解释解决“为什么推荐给你”。

对于财税内容,精排分数至少应包含:

FinalScore =
  SemanticRelevance
  + AuthorityWeight
  + FreshnessWeight
  + ContextMatch
  + EvidenceCoverage
  - ExpirationPenalty
  - ConflictPenalty

这不是固定公式,而是一种设计提醒:相关性只是信号之一。法规已废止、地域不适用或缺少原文依据时,再高的语义分也不能进入最终答案。

知识层决定系统的长期上限

“知识碎片化”是原方案里优先级最高的问题,这一点今天更加重要。一个可靠的知识层至少包含四项工作。

1. 知识获取

从法规原文、政策解读、办事指南、问答案例和企业内部资料中获取内容,同时保留来源、发布日期、发布机构和原始链接。

2. 知识结构化

抽取实体、属性与关系,但不必一开始就建设庞大的知识图谱。先从影响适用性的核心字段开始:

政策 → 发布机构
政策 → 生效/废止时间
政策 → 适用地区
政策 → 适用主体
政策 → 税种
政策 → 业务事项
政策 → 替代/引用政策

3. 知识融合与冲突处理

同一政策可能被多个来源转载、解释甚至错误概括。系统需要完成实体对齐、版本合并、权威层级判定和冲突标记,而不是把重复文本全部交给模型自行判断。

4. 质量评估与增量更新

知识必须有可计算的健康状态:来源是否权威、当前是否有效、字段是否完整、是否存在冲突、多久没有复核。政策变化应触发增量更新和受影响答案重评,而不是定期全量重建后等待用户发现错误。

大模型应该放在哪里

大模型显著提升了 Query 理解、语义改写、复杂问题拆解和自然语言回答能力,但它不应该成为没有边界的中心节点。

适合交给模型的工作包括:

  • 从口语 Query 中提取结构化意图和实体;
  • 生成多种检索表达;
  • 将复杂问题拆成可验证的子问题;
  • 对召回结果进行语义重排;
  • 基于已确认的证据组织答案;
  • 识别证据之间的冲突并请求人工判断。

不应只交给模型的工作包括:

  • 判断法规是否仍然有效;
  • 执行权限与数据隔离;
  • 决定高风险业务动作;
  • 在没有来源时补齐“看起来合理”的事实;
  • 代替确定性的地区、日期和资格过滤。

原则很简单:让模型处理模糊性,让系统处理确定性;让模型提出判断,让证据和规则约束判断。

评测比模型选型更值得长期投入

没有评测集,架构优化最终会退化成对几个演示 Query 的主观调参。

建议从真实问题中建设分层评测集:

层级主要指标关注的问题
Query 理解Intent Accuracy、Entity F1有没有理解用户在问什么
召回Recall@K正确证据有没有进入候选集
排序NDCG@K、MRR正确结果是否足够靠前
回答证据覆盖率、引用正确率每个结论是否得到证据支持
业务解决率、二次搜索率、人工接管率用户是否真正解决问题
风险过期引用率、越权率、无依据回答率系统是否守住底线

从真实 Query 到持续优化的相关性飞轮

评测数据不能只包含成功样本。含糊表达、错别字、跨地区政策、多意图、过期法规和互相冲突的来源,才真正决定系统是否能进入生产环境。

如果今天从零开始

我不会先训练一个大模型,也不会先画一张覆盖所有算法的全景图。我会按以下顺序推进:

  1. 选择一个边界清晰的财税任务,定义“正确答案”和不可接受错误。
  2. 建立最小知识模型,先解决来源、时效、地区、主体和政策关系。
  3. 用 BM25 + 向量召回建立混合检索基线。
  4. 把 Query 解析成稳定的结构化对象,并对低置信度问题主动澄清。
  5. 加入重排、引用和规则校验,确保答案可解释、可追溯。
  6. 用真实失败 Query 建立评测集和每周回归机制。
  7. 只有当基线暴露出明确瓶颈时,再增加知识图谱、个性化和多 Agent 编排。

回头看 2022 年的设计,我最大的感受不是“当年的算法已经过时”,而是工程判断必须比模型寿命更长。

一个可靠的财税智能系统,不是因为使用了多少先进模型,而是因为它知道知识从哪里来、适用于谁、何时有效;知道用户真正想解决什么;也知道在证据不足时停下来。

这三件事,至今仍然比模型名称更重要。

延伸阅读

39 / 41

我的 AI 编程工作台:让多个模型协作,而不是寻找唯一最强工具

从 Ollama + Qwen3.5:9B、OpenCode、Claude Code 到 Codex:我如何用项目级上下文、架构评审、任务拆分、交叉 Review 和质量门禁组织一套多模型开发工作流。
2026/08/06 · 12 分钟阅读

我现在的编程工具箱并不单一。

本地侧,我使用 Ollama + Qwen3.5:9B;终端工作流里有 OpenCode、Claude Code 和 Codex,OpenCode 也会接入 Kimi K3;复杂的桌面任务,我会使用 GPT 的桌面版本。它们能力不同、成本不同、交互方式不同,但我越来越确定:真正决定产出的,不是选中了哪一个“最强模型”,而是怎样组织它们工作。

我不希望一个 Agent 从模糊需求出发,一口气完成设计、编码和验收。我的做法更接近一支小型工程团队:先建立项目上下文,让强模型提出架构方案,由我审核关键判断;再把工作拆成边界清晰的任务,交给不同工具执行和交叉 Review;最后以测试、类型检查、静态分析和实际行为作为验收证据。

这套方法的核心不是多开几个终端,而是建立一条可审计的工程流水线:

需求与约束
   ↓
项目上下文(AGENTS.md / CLAUDE.md / 文档)
   ↓
方案设计(架构、领域边界、风险、验收标准)
   ↓
人的评审与决策
   ↓
任务拆分 → 多工具执行 → 交叉 Review
   ↓
自动验证 + 场景验收
   ↓
把纠错沉淀回项目上下文

我使用的不是工具列表,而是分层工作台

不同模型适合占据不同位置。把所有任务都交给最昂贵的模型,会浪费成本;把高风险设计交给轻量本地模型,又可能在错误方向上快速前进。

层次我的工具更适合的工作
本地探索层Ollama + Qwen3.5:9B代码解释、局部检索、草稿、低风险修改、敏感上下文下的辅助分析
开放编排层OpenCode + Qwen / Kimi K3多模型切换、快速试验、成本与能力对比、可替换的终端工作流
深度设计层Claude Code阅读大范围上下文、提出架构与领域模型、梳理复杂改造路径
工程执行层Codex / Claude Code / OpenCode仓库探索、实现、重构、测试、修复和代码 Review
桌面协作层GPT 桌面版跨文件与视觉材料理解、研究整理、长任务协作和成果打磨

这不是固定排名。模型会更新,工具也会变化;稳定的应该是分工原则:按任务的风险、上下文规模、可验证性和隐私要求选择执行者。

我的路由规则很简单:低风险且可逆的任务优先使用本地或低成本模型;需要跨模块推理的任务交给更强模型;涉及架构、数据迁移、安全、生产变更时,人必须进入决策环节;任何工具的输出都不能替代验收证据。

第一步不是写 Prompt,而是初始化项目上下文

进入一个新项目后,我会先建立 AGENTS.mdCLAUDE.md 等项目级说明,把技术栈、目录结构、运行方式和工程约束写进去。这一步看似只是准备文档,实际上决定了后续每个 Agent 的工作上限。

如果没有共同上下文,不同工具会反复扫描仓库、猜测约定,甚至各自发明一套实现风格。高质量的项目上下文至少应该回答:

项目目标:它解决什么问题,当前阶段是什么
技术栈:语言、框架、版本与关键依赖
架构边界:模块职责、依赖方向、禁止跨越的边界
领域语言:核心概念、术语与不变量
开发命令:安装、启动、测试、类型检查、构建
编码约定:命名、错误处理、日志、测试与提交规范
安全边界:敏感数据、密钥、外部调用和禁止操作
完成定义:一次改动必须通过哪些质量门禁

但上下文文件也不能变成几千行的知识垃圾场。AGENTS.md 更适合放跨工具、可执行、稳定的规则;CLAUDE.md 可以补充 Claude 特有的交互偏好。详细架构放进专门文档,再从入口文件链接过去。规则要短、明确、能验证,并随着代码一起更新。

一个重要原则是:不要在多个文件复制同一条规则。 重复内容迟早会不一致。公共事实应该只有一个来源,工具专属文件只记录差异。

先让强模型设计,但架构决定权仍然属于人

面对中大型需求,我通常先让 Claude 输出架构设计、领域边界、DDD 模型和实施路径。AI 很适合快速展开问题空间:发现受影响模块、列出候选方案、补齐异常流程、识别隐含依赖,并把模糊需求变成可以讨论的结构。

但我不会把一份结构完整的设计文档直接当作正确答案。我会重点审核五件事:

  1. 是否解决真实问题:方案有没有把需求想复杂,或者只展示架构技巧;
  2. 边界是否自然:领域划分是否来自业务变化,而不是为了套用 DDD 名词;
  3. 依赖是否可控:数据流、事务边界、失败恢复和兼容策略是否清楚;
  4. 是否可以渐进落地:能否分阶段交付,是否存在大爆炸式重写;
  5. 如何证明有效:测试、性能、迁移和业务验收标准是否在编码前就明确。

DDD 是组织复杂业务知识的方法,不是每个项目的默认装饰。CRUD 明确、生命周期短的模块,不需要为了“领域驱动”增加聚合、仓储和层层抽象;当业务规则复杂、术语混乱、边界长期演进时,DDD 才能真正降低认知成本。

因此我更愿意让模型同时提交“为什么这样设计”“替代方案是什么”“什么时候不该这样做”。好的架构输出不是一张看起来高级的图,而是一组可以被质疑、取舍和验证的决策。

拆分任务时,以边界和证据为单位

方案通过后,我不会把一句“请实现整个功能”扔给另一个 Agent,而是拆成可以独立理解、独立验证、尽量少共享写入范围的任务。

一个好的任务包应该包含:

目标:要改变的用户或系统行为
范围:允许修改的模块与明确不做的事项
上下文:相关设计决策、接口和现有约定
验收:测试、示例、性能或可观察行为
风险:兼容性、数据、安全与回滚要求
交付:代码、测试、文档和仍未解决的问题

任务可以按领域边界、模块、读写职责或验证类型拆分,而不是机械地按文件分配。多个 Agent 同时修改同一核心文件,往往会把节省的时间重新消耗在冲突和上下文同步上。只有边界足够清楚、写入范围互不干扰时,并行才真正有价值。

我也会控制每个任务的上下文。给 Agent 整个仓库并不总是更好;无关信息会稀释约束,增加错误联想。理想状态是:共享项目规则保持稳定,每个任务只补充完成当前目标所需的局部上下文。

交叉 Review:让不同工具发现不同类型的问题

我会让其他工具组对实现进行交叉 Review。这里的价值不是“两个模型投票”,而是引入独立视角。

实现者容易延续自己的假设,因此 Reviewer 不应该只收到一句“帮我看看代码”。更有效的 Review 会明确检查维度:

  • 是否符合需求和验收标准;
  • 是否破坏架构边界或引入隐藏耦合;
  • 异常路径、并发、幂等和资源释放是否完整;
  • 安全、隐私、权限和依赖风险是否可接受;
  • 测试是否验证行为,而不是复述实现;
  • 是否存在更简单、更易维护的方案。

Reviewer 应提交具体证据:文件与位置、触发条件、影响、复现方式和建议修复,而不是泛泛而谈。随后由实现工具处理问题,再运行验证。不同模型意见冲突时,不按模型名决定,而是回到需求、代码、测试和可复现事实。

还要警惕“模型互相背书”:如果几个工具共享了同一份错误假设,它们可能一致地给出错误结论。真正的独立验证应改变信息来源或验证方式,例如一个模型做静态 Review,另一个运行测试和场景检查,人再审查关键业务判断。

最终裁判不是模型,而是质量门禁

AI 生成的代码看起来正确,并不意味着系统行为正确。我的验收顺序通常是:

格式化 / Lint
      ↓
类型检查 / 编译
      ↓
单元测试 / 集成测试
      ↓
关键用户路径或 API 场景验证
      ↓
Diff 与架构一致性审查

能自动化的门禁应写入项目命令和 CI,而不是依赖 Agent 记住。Agent 必须报告它实际运行了什么、结果是什么、哪些验证因为环境限制没有执行。没有运行的测试不能写成“应该通过”,推测也不能伪装成证据。

高风险动作还要单独治理:生产部署、数据库迁移、删除数据、修改权限和对外发送都需要明确审批与回滚方案。本地模型保护了部分数据隐私,却不天然等于安全;模型下载来源、工具权限、Prompt 中的密钥、日志和外部插件同样需要管理。

把每次纠错变成下一次的默认能力

这套工作流最有价值的部分不是某一次把代码写快了,而是形成持续学习的闭环。

当我在 Review 中发现重复问题,会判断它应该进入哪一层:稳定的工程约束写回 AGENTS.md;架构取舍形成 ADR;领域事实进入领域文档;机械错误交给 Lint 或测试;高价值失败变成回归用例。这样下一次任务不需要依靠我再次提醒。

可以定期观察几项指标:从需求到合并的周期、首次验证通过率、Review 发现的问题数、人工返工时间、回滚次数,以及不同模型完成同类任务的成本。评价工具不能只看生成速度;一个写得快却带来大量复核工作的模型,未必更高效。

我的结论:人从编码者变成工作系统的设计者

Ollama、Qwen、OpenCode、Kimi、Claude Code、Codex 和 GPT 桌面版以后都会继续变化。今天最强的模型,明天可能只是工具箱里的普通一员。

真正可以积累的,是一套与模型无关的能力:把目标说清楚,把上下文写进项目,把架构变成可审核的决策,把任务拆成可验证的单元,让不同工具独立执行和 Review,再用自动化证据收口。

AI 降低了编码和探索的成本,但没有替我承担判断与责任。我的角色不是站在每一行代码前亲手输入,而是设计一套让正确上下文进入、让不同能力协同、让错误尽早暴露、让经验持续沉淀的工程系统。

这可能才是 AI 编程真正改变开发者的地方:我们不再只设计软件,也开始设计生产软件的方式。

40 / 41

构建生产级智能风控系统:实时流、离线湖仓与规则模型一体化

以 Kafka、Spark Structured Streaming、CDC、Hadoop/Iceberg、规则引擎与模型服务为核心,设计一套低延迟、可回放、可审计、可降级的实时与离线一体化风控架构。
2026/08/06 · 18 分钟阅读

智能风控最难的地方,不是写出一条“同一设备十分钟登录五次”的规则,而是在数据乱序、消息重复、服务故障、规则频繁变化和业务高峰同时发生时,仍然做出稳定、可解释、可追溯的决策。

一个成熟系统需要同时回答四类问题:

  • 现在是否放行:支付、登录、提现等请求通常要求毫秒级返回;
  • 最近发生了什么:用户、设备、账户在滑动窗口内是否出现聚集或突变;
  • 历史上是否异常:离线数据能否形成标签、基线、画像与训练样本;
  • 为什么这样判断:每次决策能否还原使用的事件、特征、规则和模型版本。

因此,生产级风控不是一个 Spark 作业,也不是一个规则库。它是一套由同步决策、异步流计算、离线湖仓、策略平台和反馈闭环共同组成的决策系统。

总体架构:双路径、同事实、可回放

实时与离线一体化智能风控架构

架构的关键是把“同步拦截”和“实时计算”分开:

  1. 同步在线路径:风险 API 读取在线特征,执行规则与模型,在严格延迟预算内返回通过、拒绝或人工审核;
  2. 异步实时路径:业务事件进入 Kafka,Spark Structured Streaming 以事件时间执行去重、滑动窗口、状态聚合和实时特征更新;
  3. 离线批处理路径:原始事实进入 HDFS 或对象存储上的湖仓,Spark Batch 负责回放、对账、特征回填、规则回测和模型样本构建;
  4. 统一策略与审计:规则、模型、特征定义和决策记录全部版本化,使线上结果可以离线复现。

这比让 Spark 直接阻塞每一个业务请求更稳妥。Structured Streaming 默认以微批方式执行,适合秒级状态计算;如果核心交易要求稳定的几十毫秒响应,同步决策服务必须独立部署,避免流处理调度、反压或 Checkpoint 抖动进入交易链路。

第一原则:建立不可变的风险事实流

Kafka 应被视为风险事件的事实日志,而不是临时消息管道。支付、登录、设备、账户变更、名单更新和人工审核结果都形成标准事件。

每条事件至少包含:

event_id          全局唯一,用于去重和追踪
event_type        事件类型及语义版本
event_time        业务实际发生时间
ingest_time       平台接收时间
entity_keys       user_id / account_id / device_id / ip 等
payload           业务事实,不放计算后的临时判断
trace_id          贯穿请求、流任务与决策记录
schema_version    支持兼容演进
source            来源系统与环境

Topic 按业务事实和数据保留要求设计,不按每条规则建 Topic。分区键要匹配状态计算需要:账户规则使用 account_id 可以保持同一账户事件有序,但设备团伙规则又需要 device_id,因此常通过规范化事实流派生不同 keyed stream,而不是期待一个分区键解决所有问题。

生产者启用幂等和足够确认级别,Schema 使用 Avro、Protobuf 或带注册中心的 JSON Schema 管理兼容性。消费者仍然必须具备幂等能力,因为端到端是否“恰好一次”还取决于外部 Sink。风险系统更务实的目标是:至少一次传输 + 业务主键去重 + 幂等写入 + 可对账重放。

数据库变化不要依赖高频轮询。用户状态、账户等级、名单和商户信息可以通过 Debezium 等 CDC 进入 Kafka;业务数据库更新与领域事件必须一致时,使用 Transactional Outbox,避免“数据库成功、发消息失败”的双写裂缝。

用事件时间定义滑动窗口

风控窗口必须基于 event_time,而不是消息到达 Spark 的时间。网络延迟、移动端离线和 Kafka 积压都会造成乱序。如果用处理时间,重启或积压期间同一批业务事实可能得到不同结果。

典型窗口包括:

1 分钟窗口,每 10 秒滑动:支付瞬时爆发
10 分钟窗口,每 1 分钟滑动:账户失败次数与金额
24 小时窗口,每 15 分钟滑动:设备关联账户数
7 天状态:新旧收款方、常用地域和行为基线

窗口长度代表观察范围,滑动步长代表更新频率。步长越小,状态和计算开销越大。不要为了“更实时”把所有窗口设为每秒滑动;应从业务允许的发现延迟反推配置。

Watermark 定义系统愿意等待迟到数据多久,也决定状态何时可以清理。它不是“数据一定在这个时间内到达”的保证。应根据真实延迟分布制定,例如覆盖 99.9% 事件,再把超出水位线的数据写入迟到旁路,供补算、审计和指标监控,不能静默丢弃。

events = (
    spark.readStream.format("kafka")
    .option("subscribe", "risk.payment.v1")
    .load()
    .transform(parse_and_validate)
    .withWatermark("event_time", "10 minutes")
    .dropDuplicatesWithinWatermark(["event_id"])
)

velocity = (
    events.groupBy(
        window("event_time", "10 minutes", "1 minute"),
        "account_id",
    )
    .agg(count("*").alias("tx_count_10m"),
         sum("amount").alias("tx_amount_10m"))
)

示例表达的是语义,不应直接复制到生产。真实作业还需要 Schema 校验、坏数据隔离、状态大小控制、Checkpoint 独立目录、输入速率限制、监控和 Sink 幂等设计。

实时特征不能只存在 Spark 内存里

滑动窗口结果、最近设备集合、账户速度特征和风险计数需要写入低延迟在线存储,由同步决策服务读取。可以使用 Redis、Cassandra、HBase 或团队已有的高可用 KV,但必须先定义特征契约:

feature_name + entity_key + value
event_time + computed_at
definition_version + producer_job_version
ttl + freshness_sla

在线特征写入必须幂等。使用 foreachBatch 时,可将 query_id + batch_id 或业务窗口主键作为提交标识,采用 Upsert、事务表或 Commit Log 防止重试造成重复副作用。Spark 的 Checkpoint 能恢复源 Offset 和计算状态,但不会自动让任意外部数据库获得端到端 exactly-once。

还要定义陈旧特征策略。在线存储不可用或特征超过 freshness SLA 时,决策引擎应知道是“真实值为零”还是“数据缺失”,并根据风险等级选择保守规则、降级模型、人工审核或有限放行。

规则与模型不是竞争关系

成熟风控通常采用组合决策:

硬规则:监管、黑名单、明确禁止条件
速度规则:次数、金额、关联实体和时间窗口
模型分:欺诈概率、异常分、账户接管概率
策略编排:规则命中 + 模型分 + 业务成本 → 动作

规则适合确定性强、需要解释和立即响应的风险;模型适合多变量组合和难以手写的模式。最终动作不能只看一个分数,还要结合损失金额、客户价值、误杀成本与人工审核容量。

规则平台至少需要版本、状态、优先级、适用人群、生效时间、失效时间、作者、审批人和变更原因。发布流程采用:草稿 → 单元测试 → 历史回放 → Shadow → 小流量灰度 → 全量。规则命中必须记录规则版本与输入快照,但不要在高 QPS 主链路同步写重型审计数据库;先写可靠事件,再异步落库。

规则 DSL 应保持受限和可分析,避免允许任意脚本访问网络或数据库。规则数据和维表通过受控接口或预加载快照提供,不能让每条交易规则临时查询生产库。

离线层:从 Hadoop 文件堆升级为可治理湖仓

HDFS 仍适合本地 Hadoop 集群的大规模分布式存储;云上则通常使用对象存储。无论底层是什么,都不建议继续以裸 Parquet 目录作为唯一数据管理方式。使用 Iceberg 等开放表格式,可以获得原子提交、Schema 演进、分区演进、快照和 Time Travel,让回放与审计有稳定基础。

湖仓至少划分三层:

  • 原始事实层:Kafka/CDC 原样归档,只追加,保留事件与 Schema 版本;
  • 标准明细层:完成去重、主数据映射、隐私处理与统一时间语义;
  • 特征与标签层:面向规则回测、模型训练、案件分析和指标统计。

Spark Batch 负责日终对账、历史窗口、特征回填、坏账与欺诈标签、策略效果评估。批处理与实时计算应共享特征定义或由同一套声明式逻辑生成,避免“训练时一个口径、线上另一个口径”。训练样本必须做 point-in-time join,只使用决策发生时已经可见的信息,防止未来数据泄漏。

流式写入 Iceberg 会产生大量 Snapshot 和小文件,需要独立维护任务定期压缩小文件、重写 Manifest、过期 Snapshot,并监控元数据增长。离线层不是无限保留:原始、特征、决策和敏感数据应分别设置保留期限与删除策略。

一次决策必须可以完整重放

每个决策至少留下以下 Decision Record:

decision_id / request_id / trace_id
event_id 与原始事实位置
特征值、特征时间和定义版本
命中规则及规则版本
模型名、模型版本、分数与阈值
最终动作、原因码和人工覆盖
决策时间、延迟、降级状态

审计不是只为合规,也用于回答生产问题:为什么同一客户昨天通过、今天拒绝?规则上线后误杀来自哪里?模型表现下降是数据漂移、特征延迟还是业务分布变化?

所有决策都应携带稳定的 reason code。面向运营的解释和面向客户的解释要分开设计,既保证可操作性,也避免暴露可被攻击者利用的规则细节。

高可用的关键是明确降级语义

系统不可能永不失败,生产设计的重点是失败时做什么:

故障推荐策略
Kafka 短时积压在线路径继续使用带时间戳的最近特征,监控新鲜度并切换保守策略
在线特征库不可用使用本地缓存与核心规则;高风险交易转人工或拒绝
模型服务超时快速熔断,降级到规则和最近稳定模型,不串行重试拖垮请求
规则配置错误立即回滚版本;高风险规则双人审批,发布前 Shadow
Structured Streaming 作业失败从持久 Checkpoint 恢复;原始 Kafka 数据和湖仓归档支持回放
数据质量异常隔离坏数据、冻结受影响特征、告警数据负责人,避免错误扩散

同步决策服务跨可用区部署,设置整体延迟预算和每个依赖的超时;Kafka、Checkpoint、在线存储和湖仓分别制定 RPO/RTO。不要把“重启成功”当作灾备,必须定期演练从 Offset、Checkpoint 和历史事实恢复。

可观测性要同时看系统、数据和决策

只监控 CPU 和延迟不足以运营风控。至少建立三组指标:

  • 系统指标:QPS、p95/p99 延迟、错误率、Kafka Lag、批次耗时、状态大小、Checkpoint 失败;
  • 数据指标:事件量、Schema 失败、重复率、迟到率、空值率、特征新鲜度、实时离线一致性;
  • 风险指标:通过/拒绝/审核率、规则命中率、模型分布、误杀率、欺诈损失、审核积压和策略收益。

告警要关联影响而非只关联阈值。例如 Kafka Lag 上升并不可怕,真正重要的是哪些特征已经超过 SLA、哪些决策正在降级,以及受影响的交易量。

从 MVP 到生产的落地顺序

阶段一:建立事实与最小决策闭环

  • 统一风险事件 Schema、唯一 ID、事件时间和 Reason Code;
  • Kafka 接入一种核心事件,原始数据同步归档湖仓;
  • 上线独立决策 API、少量硬规则和完整 Decision Record;
  • 建立延迟、错误率、Lag 和决策分布基线。

阶段二:引入实时状态

  • 用 Structured Streaming 实现 2–3 个高价值滑动窗口;
  • 建立 Watermark、迟到旁路、去重和幂等 Sink;
  • 接入在线特征存储并定义 freshness SLA;
  • 演练作业重启、Kafka 积压和特征库降级。

阶段三:规则平台与离线回放

  • 规则版本化、审批、Shadow、灰度和一键回滚;
  • 建立 Iceberg 明细、特征、标签和决策表;
  • 对新规则做历史回测并校验实时/离线特征一致性;
  • 引入人工审核反馈和案件闭环。

阶段四:模型化与持续优化

  • 通过 point-in-time join 建立无泄漏训练集;
  • 模型注册、可解释输出、Shadow、灰度和漂移监控;
  • 用损失、误杀和运营成本共同优化阈值;
  • 定期复盘规则重叠、无效特征、技术债和灾备能力。

最后的判断标准

生产级智能风控不等于“实时技术足够多”。真正成熟的系统应该具备:

  1. 同步决策延迟可控,流计算不会拖垮交易主链路;
  2. Kafka 保存可重放事实,重复、乱序和迟到都有明确语义;
  3. 实时与离线共享特征口径,规则和模型全部版本化;
  4. 每次决策可以解释、审计和复现;
  5. 任一依赖失败时,系统知道如何降级,而不是随机失败;
  6. 策略效果最终由欺诈损失、误杀成本和客户体验衡量。

风控的本质不是尽可能拒绝风险,而是在不断变化的信息和有限时间内,做出成本可控、证据充分、责任清晰的决策。Kafka、Spark、Hadoop 和规则引擎只是基础设施;真正的核心,是把实时事实、历史知识和业务判断组织成一条持续学习的决策闭环。

延伸阅读

41 / 41

从随机权重到本地推理:我如何从零训练一个 Transformer

在一台 16GB MacBook Air 上,用 MLX 从头实现 Decoder-only Transformer,并经历 Byte Tokenizer、BPE、Unicode、安全推理和独立评测的三代实验。
2026/08/06 · 15 分钟阅读

训练一个 Transformer,最容易做的事情是调用现成框架,最容易跳过的事情则是理解一条文本如何变成 token、梯度如何改变随机权重、Checkpoint 如何重新加载,以及为什么一个验证 Loss 很低的模型仍然不会回答真实问题。

我建立了 Local Transformer Training Lab,目标不是做一个能与大模型竞争的助手,而是在个人电脑上亲手跑通:

数据生成
→ Tokenizer
→ Decoder-only Transformer
→ 预训练
→ 指令微调
→ 独立评估
→ Checkpoint 与导出
→ 本地推理

项目在一台 16GB 内存的 MacBook Air 上完成,使用 Apple MLX 和 Metal GPU。所有模型都从随机权重开始训练,不是对 Qwen、Llama 等现成模型做微调。

三代本地 Transformer 实验的演进

为什么要从零训练

调用模型 API 能让我快速构建产品,却很难回答一些更底层的问题:

  • Tokenizer 的选择如何改变序列长度和输出安全?
  • 因果注意力的 Mask 在代码里究竟是什么?
  • 预训练与 SFT 为什么需要不同的数据和 Loss?
  • 验证集指标很好,为什么改写一个问法模型就失败?
  • 生成时的重复、乱码和空回答应该在哪一层解决?
  • 一个模型包最少需要保存什么,才能在另一个进程里可靠恢复?

从零训练的价值,不在于参数规模,而在于任何异常都不能推给“黑盒”。数据、模型、训练和推理之间的因果关系会变得具体。

第一代:先让完整链路跑起来

第一版 programmer-world-tiny 使用本地模板生成约 10 MiB“程序员世界”语料,覆盖 Go、Linux、Redis、MySQL、Docker、代码补全和招聘面试:

项目数值
总记录23,377
训练 / 验证22,908 / 469
文本重复率0
外部 API未使用

模型保持刻意的小:4 层 Decoder Block、4 个注意力头、128 隐藏维度和 384 FFN。128-token 版本有 742,272 个参数;上下文扩到 512 后有 791,424 个参数。

核心模块全部在 src/model.py 中实现:

Token Embedding + Position Embedding
→ RMSNorm
→ Causal Multi-Head Self-Attention
→ Residual
→ RMSNorm
→ GELU Feed Forward
→ Residual
→ LM Head

因果 Mask 保证位置 t 只能看到自己和之前的 token。训练目标没有神秘之处:输入序列去掉最后一个 token,标签序列去掉第一个 token,模型学习预测下一个 token。

logits = model(inputs)
loss = cross_entropy(logits, targets)

训练使用 AdamW、梯度裁剪、定期验证,并同时保存 best、阶段 Checkpoint 和 final。最终模型包只依赖三类文件:

config.json
model.safetensors
tokenizer.json

这三者缺一不可。权重没有配置无法恢复结构,模型没有同版本 Tokenizer 无法解释 token id。

Byte Tokenizer:简单、可靠,也很昂贵

第一版使用 UTF-8 字节级 Tokenizer,词表只有 263 个 token:256 个字节值加特殊标记。它不需要训练、可以无损覆盖中文英文和代码,非常适合理解流程。

代价也很明显:一个中文字符通常需要三个 token。上下文窗口标称 512,能装下的中文远少于 512 个字。模型还可能逐字节生成一个不完整的 UTF-8 序列,终端最终显示

第一代训练 2,500 步,512-token 版本最佳验证 Loss 为 0.135433,最终困惑度 1.1514,耗时约 110.63 秒。数字非常漂亮,但真实问答并不可靠。

这是项目最重要的早期提醒:训练集和验证集来自同一套模板分布,低 Loss 首先说明模型记住了模板规律,不等于获得了通用编程知识。

第二代:BPE、两阶段训练与回答区间 Loss

v1 把模型扩大到 8,534,272 参数,使用 8 层、8 头、256 隐藏维度,并训练 4096 词表的 ByteLevel BPE。

Tokenizer 的效率变化很直观:

“Redis 为什么这么快?”
Byte Tokenizer:28 token
BPE Tokenizer:7 token

更重要的变化是把训练拆成两个阶段。

领域预训练

预训练数据不再保留问答外壳,而被改写为技术笔记和完整代码。目标是学习领域语言、代码结构和 next-token 规律。

指令微调

SFT 数据清除模板化的“补充约束”“模拟业务背景”等表达,做语义去重和类别均衡。训练时只对 <|assistant|> 之后的回答区间计算 Loss,避免让模型把大量容量用在复现用户问题和控制标记上。

v1 完成 800 步预训练和 1,500 步 SFT。最低 SFT 验证 Loss 达到 0.235517,但独立改写提示暴露了真实问题:Redis、MySQL、Docker 之间会串台,身份回答会混入 HR 模板,换一种问法后泛化明显下降,少数提示直接生成结束标记。

这次实验比“Loss 降了多少”更有价值的结论是:

参数规模、BPE 和训练算法可以改善表示与拟合;语料的自然多样性、监督质量和独立评测决定模型是不是真的会回答。

第三代:先保证输出是合法的

v1 的 ByteLevel BPE 仍允许模型生成无法组成合法 UTF-8 的字节片段。v2 没有继续盲目扩大参数,而是换成 Unicode 字符 Tokenizer。

训练语料包含 750 个不同字符,加 9 个特殊标记,最终词表为 759。每个输出 token 都是合法 Unicode 码点;未知字符明确变成 <|unk|>,不再产生

v2 有 6,825,728 个参数,仍然是 8 层、8 头、512 上下文,完成 800 步预训练和 1,500 步 SFT,总训练耗时 115.45 秒。

字符级 Tokenizer 并不一定比 BPE 更强。它的序列更长,当前又没有 KV Cache,生成速度更慢。但它验证了一个工程原则:模型能力、Tokenizer 效率和输出合法性是三种不同目标,不能只用一个 Loss 概括。

推理不是训练脚本的附属品

一个能加载权重的脚本,不等于一个可用的推理入口。v2 在生成层增加了:

  • 最近 64 token 的重复惩罚;
  • 连续四个相同 token 时停止;
  • 同一三元组连续重复三次时停止;
  • 控制标记截断;
  • Unicode 替换字符过滤;
  • 空回答的明确回退;
  • 常见短问题规范化;
  • --no-history 隔离未经过多轮 SFT 的历史污染。

其中最反直觉的是默认关闭历史。拥有 512-token 上下文不代表模型学会了多轮对话。如果训练数据没有可靠的多轮结构,把上一次错误回答放进下一轮上下文,只会让错误复利。能力没有准备好时,少做比假装支持更可靠。

如何评估一个教学型小模型

训练和验证按同一模板随机切分,很容易产生过度乐观的指标。项目最终采用三层检查:

  1. 实现正确性:Tokenizer 往返、Mask、形状、保存加载和最小训练测试;
  2. 同分布指标:训练 Loss、验证 Loss、困惑度和梯度范数;
  3. 分布外行为:人工改写问题、领域串台、空回答、重复、乱码和多轮污染。

真正值得保留的不是某个最好看的数字,而是失败案例。它们指出下一步应该改数据、Tokenizer、Loss、模型还是推理策略。

我真正学到的五件事

1. 数据结构比数据体积更重要

10 MiB 高度模板化语料可以得到很低的 Loss,也可以得到很差的真实泛化。去重不仅要比较字符串,还要避免语义模板跨越训练和验证集合。

2. Tokenizer 是模型架构的一部分

它决定词表参数、序列长度、上下文利用率、未知字符行为和输出是否合法,不是一个可以随意替换的预处理工具。

3. 预训练与 SFT 解决不同问题

预训练学习语言和领域分布,SFT 学习如何按照任务格式回答。把两种数据混在一次 next-token 训练里,模型很难知道哪些内容是知识,哪些内容是交互协议。

4. Loss 只回答它被设计来回答的问题

同模板验证 Loss 回答的是“模型能否预测同分布 token”,而不是“它能否理解用户的自然表达”。指标必须与产品声称的能力对应。

5. 推理治理不是掩盖模型缺陷

重复停止、回退和关闭历史不会让模型更聪明,但会让能力边界诚实、稳定、可观察。可靠系统不只追求更多正确输出,也要限制错误输出如何扩散。

下一步

这个项目已经完成从随机权重到本地推理的闭环,但仍然是教学模型。下一阶段最有价值的工作不是继续重复合成模板或盲目增加训练步数,而是:

  • 使用来源和许可证明确的真实中文技术语料;
  • 人工编写 1,000–5,000 条自然问法、改写和多轮追问;
  • 按语义主题隔离训练、验证和测试;
  • 为代码增加编译测试,为技术回答增加规则或人工评分;
  • 比较 10M、30M 和 50M 参数模型;
  • 加入 KV Cache,系统评估速度、内存和质量的权衡。

从零训练没有让我更轻视大模型,恰恰相反。它让我看到,一个看起来简单的回答背后,数据、Tokenizer、架构、优化、评测和推理策略必须同时成立。

仓库与完整实验记录:hh696-wq/local-transformer-training-lab